


نظرة عامة
عند التعامل مع سجلات خوادم ضخمة أو مستندات نصية مركبة، تبرز الحاجة إلى تقطيع البيانات ليس فقط وفق الحجم أو عدد السطور الجامد، بل بالاستناد إلى بنيتها وسياقها الداخلي. هنا تتجلى قوة الأداة csplit التي تتفوق على نظيرتها التقليدية split بقدرتها الفائقة على تفتيت النصوص وفق التعبيرات النمطية (Regular Expressions) وأرقام الأسطر المحددة بدقة متناهية. يستعرض هذا الدليل التطبيقي خطوات توظيف هذه الأداة بكفاءة في بيئة العمل اليومية.
تجزئة الملفات النصية بناءً على أرقام الأسطر
نبدأ بتهيئة بيئة تجارب مخصصة لتفادي تداخل الملفات، وذلك بإنشاء مجلد عمل جديد والانتقال مباشرة إليه عبر تنفيذ الأمر mkdir -p ~/csplit_lab && cd ~/csplit_lab.
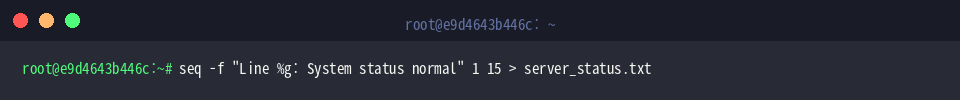
سنحتاج إلى عينة بيانات لتجربة التقسيم؛ لذا سنقوم بتوليد ملف نصي يتألف من 15 سطراً يحاكي تنبيهات فحص النظام عبر أمر التسلسل seq -f "Line %g: System status normal" 1 15 > server_status.txt.
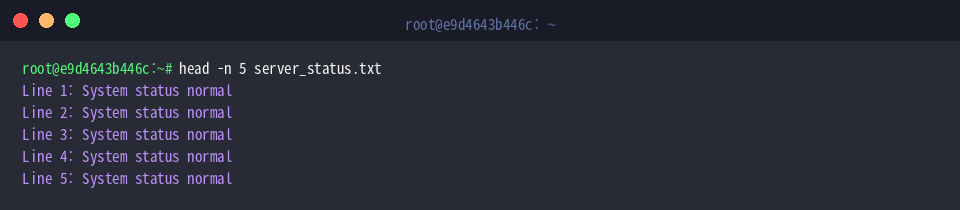
للتحقق من هيكل المحتوى الافتتاحي وتنسيقه، نستعرض أول خمسة أسطر من الملف باستخدام head -n 5 server_status.txt.
تقوم فكرة csplit الأساسية على قراءة الملف المصدر وفصله إلى مستندات فرعية عند نقاط التقاء معينة.
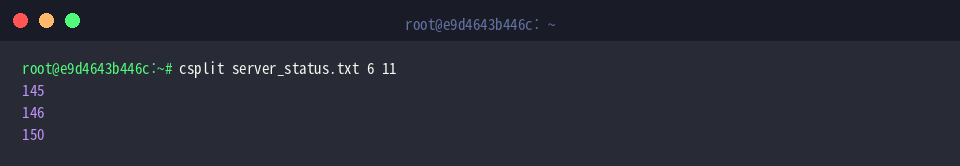
عند كتابة csplit server_status.txt 6 11، نطلب من الأداة اتخاذ السطرين السادس والحادي عشر كفواصل فاصلة، ما يوزع المحتوى إلى ثلاثة أجزاء متتابعة: (من السطر 1 إلى 5)، و(من 6 إلى 10)، و(من 11 حتى نهاية الملف).
القيم الرقمية الناتجة على الطرفية تُمثل أحجام المقاطع المتولدة مقدرة بالبايت (Bytes).
⚙️ [أهم خيارات التحكم]
-f PREFIX : تعيين بادئة مخصصة لأسماء الملفات المخرجة عوضاً عن القيمة الافتراضية (xx).-b FORMAT : ضبط نسق الترقيم التسلسلي باستخدام تنسيق مطابق لصيغة printf.-n DIGITS : تحديد عدد الخانات الرقمية في لاحقة الأسماء (الافتراضي: خانتان).-s : الوضع الصامت الذي يمنع طباعة أحجام البايتات على الشاشة.-z : استبعاد الملفات الفارغة ذات الحجم الصفري وتفادي إنشائها.-k : الإبقاء على المقاطع التي كُتبت بنجاح حتى وإن حدث خطأ في مسار العملية لاحقاً.
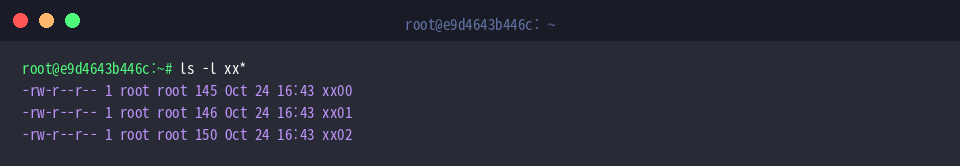
لعرض الملفات المجزأة الناتجة وبياناتها، ننفذ الأمر ls -l xx*.
نلاحظ ظهور ثلاثة ملفات ببادئة xx تليها أرقام ثنائية الخانة (xx00 و xx01 و xx02)، حيث يطابق حجم كل ملف عدد البايتات المعلنة سابقاً.
التقطيع التلقائي للأقسام بالاعتماد على التعبيرات النمطية
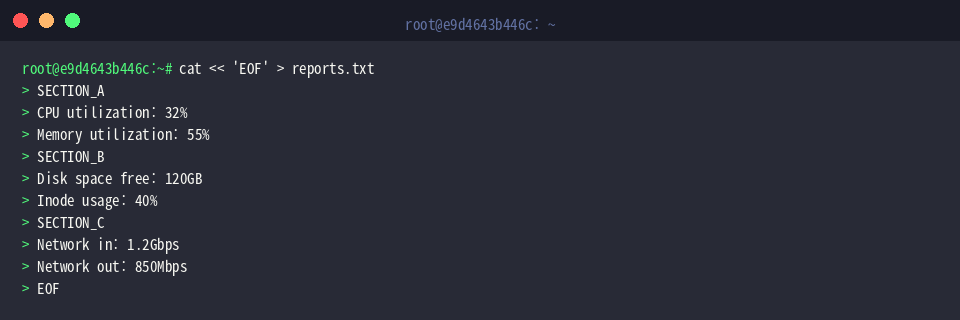
لاختبار قدرة الأداة على التعرف الذاتي على فواصل الأقسام، سننشئ ملفاً يحوي تقارير موارد خادم مقسمة برموز تعبيرية بواسطة التوجيه cat << 'EOF' > reports.txt.
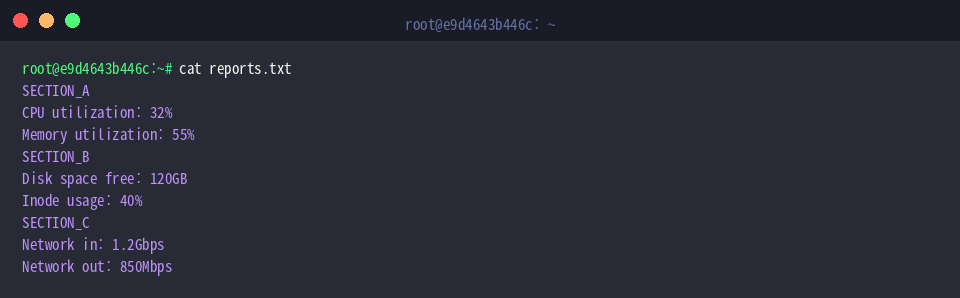
للتأكد من اكتمال محتويات التقرير ووضوح بنية الأقسام المختلفة، نعرض الملف كاملاً عبر الأمر cat reports.txt.
يحتوي الملف بوضوح على ثلاث مجموعات بيانات منفصلة: SECTION_A و SECTION_B و SECTION_C.
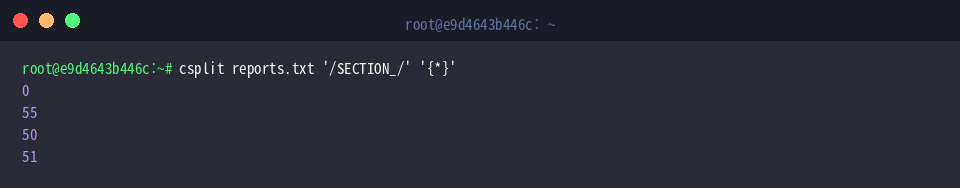
لفصل كل قسم في ملف مستقل تلقائياً، نشغّل الأمر csplit reports.txt '/SECTION_/' '{*}'؛ حيث يشير المعامل /SECTION_/ إلى النمط النصي الفاصل، في حين تخبر الإشارة { * } الأداة بضرورة تكرار البحث والتقسيم حتى آخر سطر في الملف المصدر.
تظهر على الشاشة أحجام الملفات الناتجة بالبايت، بدءاً من الجزء التمهيدي الذي يسبق ظهور النمط الأول (والذي قد يبلغ 0 بايت إن كان النمط في السطر الأول)، يليه حجم كل قسم تم استخلاصه.
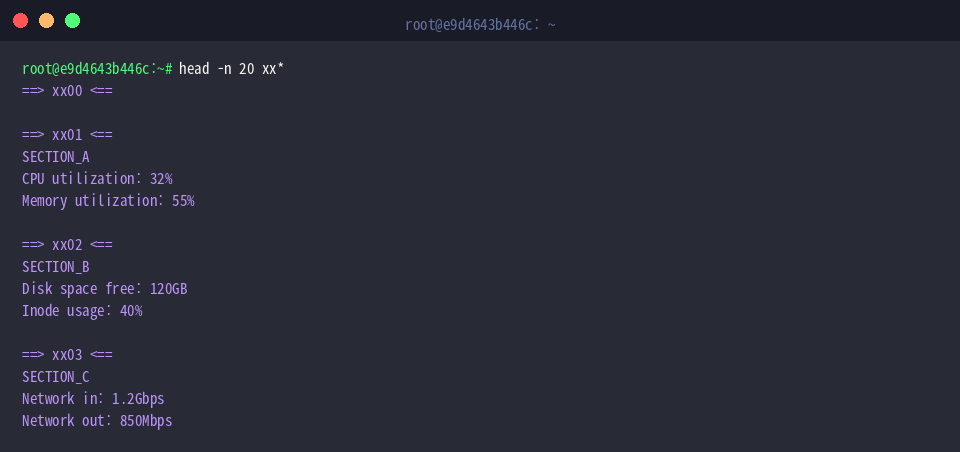
لفحص محتوى الأجزاء المستخرجة، نستطلع الأسطر الأولى منها دفعة واحدة بتنفيذ head -n 20 xx*.
يتضح بدء الناتج بالملف الفارغ xx00 (الواقع قبل أول علامة)، تليه الملفات xx01 و xx02 و xx03 التي حملت كل منها بيانات قسمها بدقة متناهية.
تخصيص تسميات الملفات وتنسيق أرقام المقاطع
لتطبيق التسميات المخصصة وخانات الترقيم، سنقوم بإنشاء سجل أحداث برمجي افتراضي يحاكي سجلات التطبيقات الحية عبر الأمر cat << 'EOF' > app.log.
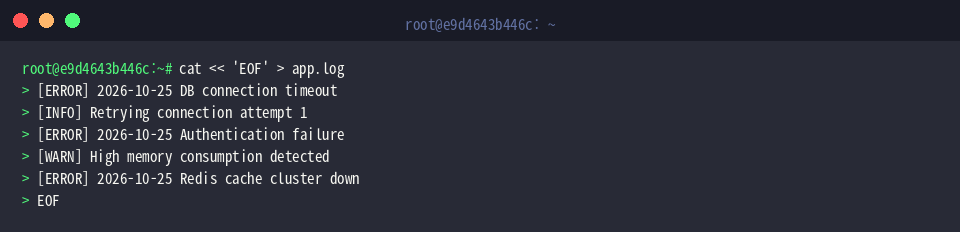
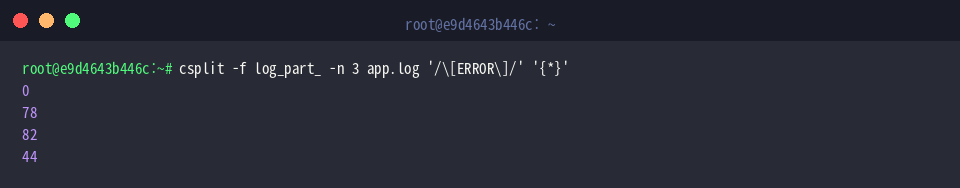
لعزل كتل الأخطاء مع اعتماد بادئة واضحة وترقيم من ثلاث خانات، ننفذ الأمر csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}'. حيث يقوم الخيار -f log_part_ باستبدال البادئة الافتراضية، بينما يفرض الخيار -n 3 صيغة ترقيم ثلاثية الأرقام (مثل 000، 001).
توضح الأرقام الظاهرة بعد التنفيذ السعة التخزينية لكل ملف فرعي بالبايت.
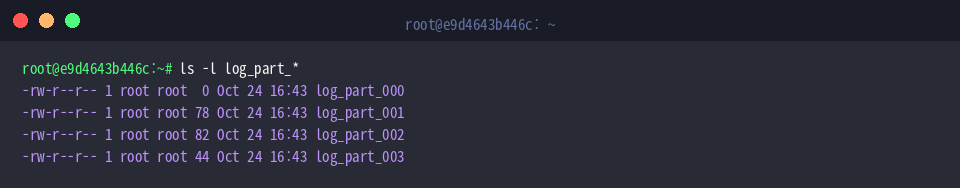
للتحقق من توافق الأسماء الجديدة مع الإعدادات المدخلة، نستعلم عن قائمة الملفات بواسطة ls -l log_part_*.
نرى بوضوح إنشاء الملفات من log_part_000 حتى log_part_003 متسلسلة وفق المعيار المخصص دون أي إرباك.
خيارات الإنتاج المتقدمة: تجاهل الملفات الفارغة (-z) وحفظ المخرجات عند الأعطال (-k)
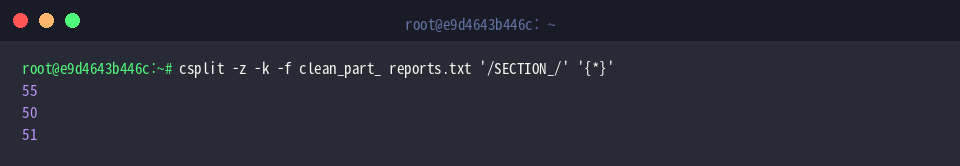
عند معالجة الملفات الحساسة، ندمج عادة خيارات الحماية والتنظيف؛ فالأمر csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' يجمع بين ميزة -z لمنع إنشاء أي ملف خاوٍ (0 بايت) وميزة -k لضمان عدم حذف المقاطع المنجزة في حال تعثرت العملية في منتصفها.
وبفضل حجب الملف الابتدائي الفارغ، لم يُسجل الصفر بايت، واقتصر الخرج مباشرة على أحجام كتل البيانات الفعلية الثلاث (55 و 50 و 51 بايت).
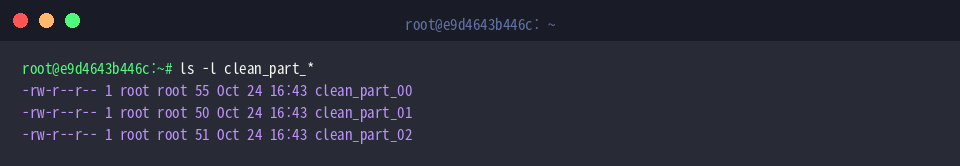
للتأكد من خلو الدليل من أي ملفات زائدة، نستعرض المخرجات عبر ls -l clean_part_*.
تُظهر النتيجة إنشاء ثلاثة ملفات فعلية فقط (clean_part_00 إلى clean_part_02) مع اختفاء أي أثر للملفات عديمة القيمة.
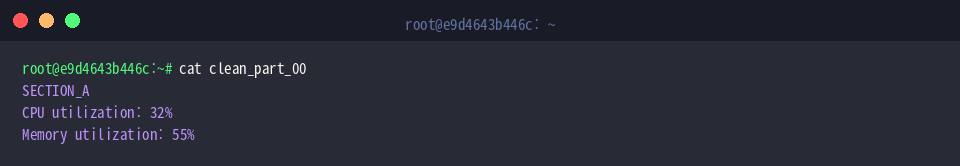
وللتثبت من عدم ضياع أول كتلة بيانات بسبب استخدام -z، نقوم بطباعة أول ملف بواسطة cat clean_part_00.
نرى أن الملف clean_part_00 يبدأ رأساً بمعلومات SECTION_A كاملة وغير منقوصة.
في ختام جلسة العمل، نُنظف بيئة الاختبار ونتخلص من الملفات المؤقتة بتنفيذ الأمر rm -rf ~/csplit_lab.
تناولنا خلال هذه الجولة العملية كيفية تسخير الأمر csplit لتقطيع وتوزيع الملفات النصية بحرفية اعتماداً على الأنماط والتعبيرات القياسية. لا شك أن إتقان هذه الأداة يوفر على مسؤولي الأنظمة ومهندسي DevOps وقتاً هائلاً عند تشريح سجلات الأنظمة العملاقة وإعادة هيكلة البيانات النصية المعقدة.