


Übersicht
In Linux-Umgebungen ist awk das mächtigste Werkzeug, um große Textdateien oder Protokolldaten effizient zu verarbeiten und zu filtern. In diesem Leitfaden lernen Sie die grundlegende Syntax sowie praktische Anwendungsfälle kennen, mit denen Sie ohne komplexe Skripte und mit nur einem einzigen Einzeiler bestimmte Spalten extrahieren, Bedingungen filtern und Daten aggregieren können.
1. Grundlegendes Funktionsprinzip von awk und Extrahieren bestimmter Spalten
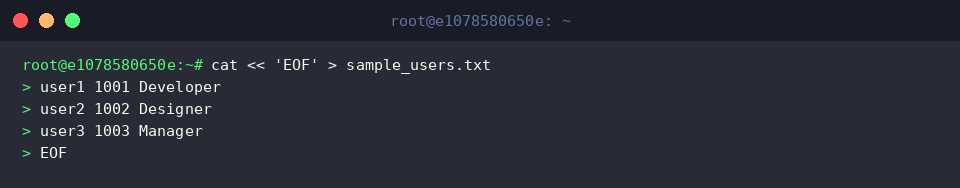
Um den awk-Befehl zu testen, erstellen wir eine Beispiel-Textdatei, in der Benutzername, ID und Berufsbezeichnung durch Leerzeichen getrennt sind.
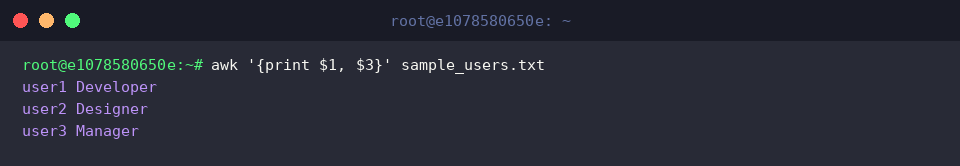
Mit dem Befehl awk extrahieren und geben wir aus jeder Zeile der Datei das erste Feld ($1, Benutzername) und das dritte Feld ($3, Beruf) aus, wobei standardmäßig Leerzeichen als Trennzeichen verwendet werden.
Sofern kein anderes Trennzeichen angegeben wird, teilt awk Felder standardmäßig anhand aufeinanderfolgender Leerzeichen oder Tabulatoren auf.
⚙️ [Wichtige Optionen]
-F fs : Legt das Eingabefeld-Trennzeichen (Field Separator) fest.-v var=val : Weist vor der Ausführung eine Variable und deren Anfangswert zu, die innerhalb des awk-Skripts verwendet werden können.-f progfile : Gibt den Pfad zu einer Datei an, die den auszuführenden awk-Skriptcode enthält.
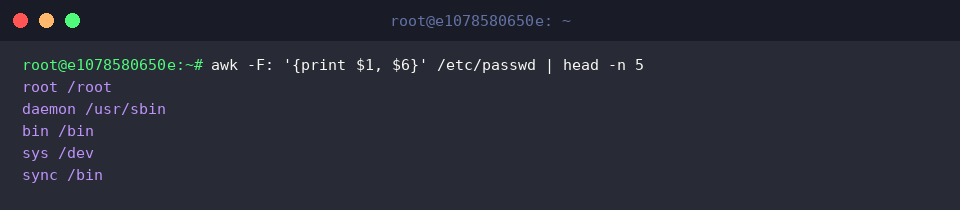
In der durch Doppelpunkte (:) getrennten Datei /etc/passwd wird mit der Option -F: das Trennzeichen festgelegt. Anschließend extrahieren wir nur das erste Feld ($1, Kontoname) und das sechste Feld ($6, Pfad des Home-Verzeichnisses) und überprüfen die ersten 5 Zeilen.
2. Benutzerdefinierte Datenfilterung mit Bedingungen und Operatoren
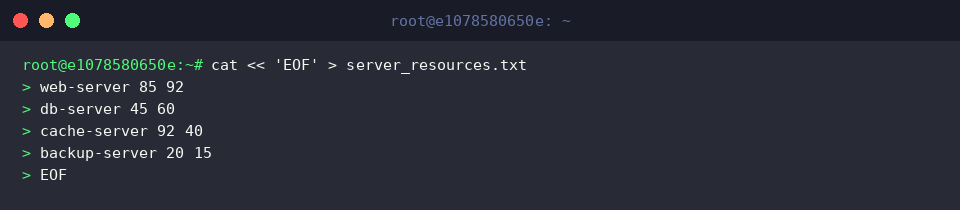
Wir erstellen die Übungsdatei server_resources.txt, die Daten zur CPU- und Speicherauslastung einzelner Server enthält.
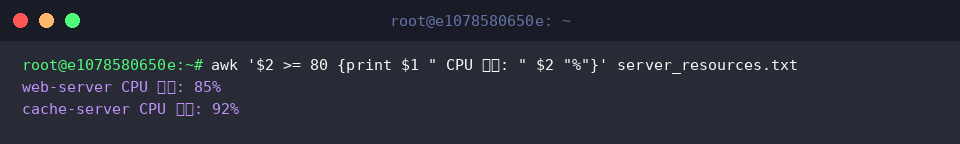
Über einen Bedingungsausdruck filtern wir Einträge heraus, bei denen das zweite Feld ($2, CPU-Auslastung) 80 % oder mehr beträgt, und geben den entsprechenden Servernamen zusammen mit einer Warnmeldung aus.
Dies ist äußerst nützlich, um Systemressourcen zu identifizieren, die Schwellenwerte überschreiten.
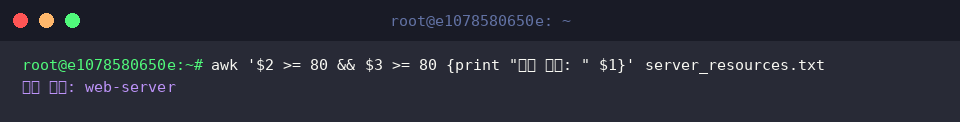
Mit dem logischen UND-Operator (&&) filtern wir kritische Server heraus, bei denen sowohl die CPU- ($2) als auch die Speicherauslastung ($3) mindestens 80 % erreichen.
Durch kombinierte Bedingungen lassen sich gezielt Systeme identifizieren, bei denen mehrere Ressourcen gleichzeitig den Grenzwert überschreiten.
3. Statistiken und Summierung mit integrierten Variablen sowie BEGIN/END-Blöcken
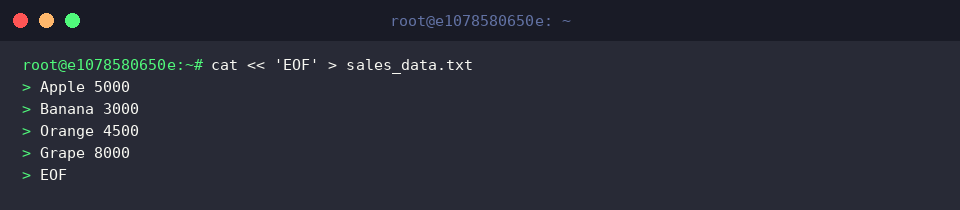
Um Datenaggregationen und statistische Berechnungen mit awk zu demonstrieren, erstellen wir die Beispieldatei sales_data.txt mit Artikelnamen und Verkaufszahlen.
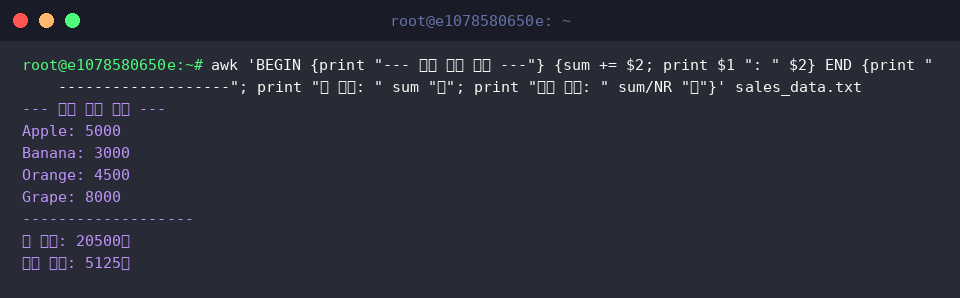
Über den BEGIN-Block wird vor der Verarbeitung des Dateiinhalts eine Einleitungszeile ausgegeben, und der Wert des zweiten Feldes ($2) jeder Zeile wird in der Variable sum aufsummiert.
Im END-Block, der nach der Verarbeitung aller Zeilen ausgeführt wird, werden der Gesamtumsatz sowie der durchschnittliche Umsatz mithilfe der integrierten Variable NR (Gesamtzahl der Datensätze) berechnet und ausgegeben.
4. Analyse von Webserver-Logs und Filtern von auffälligem Datenverkehr in der Praxis
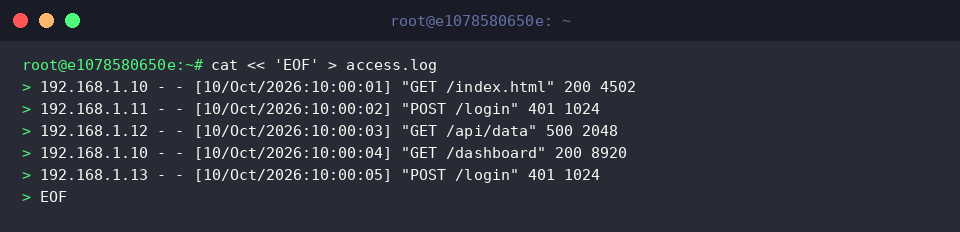
Zur Analyse von Webserver-Logs und zur Fehlersuche erstellen wir die Beispieldatei access.log im Nginx- bzw. Apache-Standardformat.
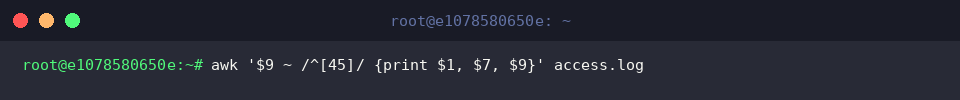
Mit dem Regex-Matching-Operator (~) filtern wir Zeilen mit 4xx-Clientfehlern und 5xx-Serverfehlern heraus, bei denen das neunte Feld ($9, HTTP-Statuscode) mit einer 4 oder 5 beginnt.
Aus den übereinstimmenden Logzeilen werden nur die Client-IP ($1), die angeforderte URI ($7) und der Statuscode ($9) extrahiert, um Störungen und auffälligen Datenverkehr schnell zu erkennen.
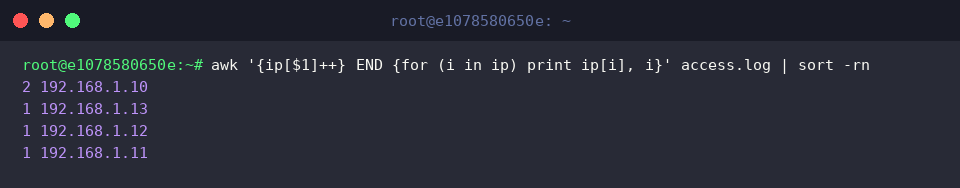
Mithilfe assoziativer Arrays in awk (ip[$1]++) wird die Anzahl der Anfragen pro IP-Adresse gezählt. Anschließend wird die Gesamtzahl über eine Schleife im END-Block ausgegeben und mit der Pipeline sort -rn absteigend nach Anfragehäufigkeit sortiert.
Dies ist eine praxiserprobte Analysemethode, um übermäßigen Traffic oder verdächtige Zugriffsversuche von bestimmten IP-Adressen zu erkennen.
In diesem Leitfaden haben wir die grundlegende Syntax sowie praxisnahe Schlüsselbeispiele des awk-Befehls kennengelernt, mit denen sich Textverarbeitung und die Analyse großer Logdateien unter Linux mühelos bewältigen lassen.
Wenden Sie die vorgestellten Optionen und Muster direkt in Ihren täglichen Aufgaben an, um wiederkehrende Datenextraktions- und Verarbeitungsschritte noch effizienter zu automatisieren.