


Einleitung
Jede erfolgreiche Diagnose und Leistungsanalyse auf einem Linux-System setzt voraus, dass man die laufenden Hintergrund- und Vordergrundprozesse präzise durchleuchten kann. Das Standardwerkzeug der Wahl ist hierbei ps (process status). In diesem Praxishandbuch beleuchten wir die Funktionsweise und das Zusammenspiel der wichtigsten Flags dieses Klassikers. Sie erfahren praxisnah anhand konkreter Terminal-Szenarien, worin sich BSD- und POSIX-Syntaxstile wie ps aux und ps -ef fundamental unterscheiden und wie sich verdächtige Instanzen via Pipes filtern sowie nach Ressourcenhunger sortieren lassen.
1. Erste Schritte im Terminal: Lokale Shell-Prozesse inspizieren
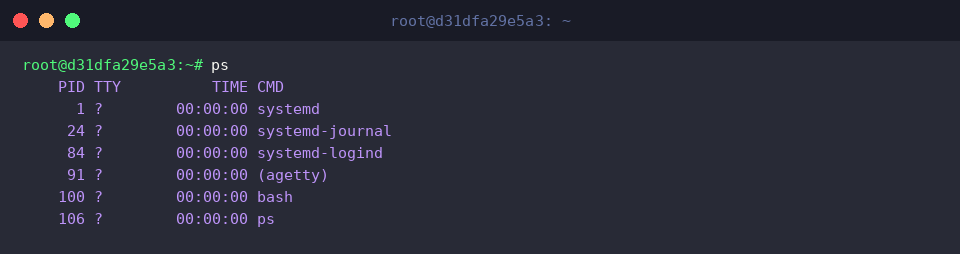
Ruft man das Dienstprogramm ps vollkommen ohne zusätzliche Parameter auf, beschränkt sich das Werkzeug auf ein absolutes Minimum: Es spiegelt lediglich die Tasks wider, die direkt an die aktuelle Sitzung gebunden sind.
Die generierte Tabelle liefert vier Kernwerte: Die eindeutige Prozessnummer PID, die zugewiesene Pseudoterminal-Schnittstelle TTY, die kumulierte Rechenzeit des Prozessors TIME sowie das ausführende Binary bzw. Skript unter CMD.
⚙️ [Zentrale Parameter im Überblick]
-e, -A : Erfasst ausnahmslos sämtliche laufenden Systeminstanzen über alle Terminals und Daemons hinweg.-f : Aktiviert das detaillierte Format (Full Listing) mit Attributen wie UID, PID und PPID.-u : Schränkt die Abfrage auf bestimmte Benutzerkonten ein oder gibt erweiterte Ressourcendetails aus.-ef : Die bewährte POSIX-Kombination, um das Gesamtsystem vollständig und übersichtlich darzustellen.aux : Das klassische BSD-Trio zur Analyse von CPU- und RAM-Last aller aktiven Tasks.-p : Filtert gezielt nach einer oder mehreren spezifischen Prozess-IDs (PIDs).
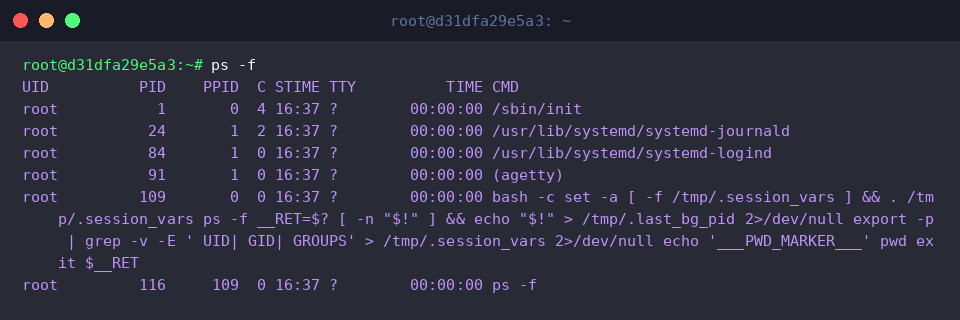
Möchte man mehr Kontext über die Befehlsausführung gewinnen, erweitert der Schalter -f die Datensätze um tiefere Metadaten.
Zu den Standardfeldern gesellen sich nun das Benutzerkonto (UID), der Verweis auf den erzeugenden Elternprozess (PPID), der exakte Startzeitpunkt (STIME) sowie der vollständige Aufrufpfad inklusive übergebener Flags.
Gerade die PPID ist bei der Ursachenforschung unersetzlich, wenn verwaiste Subprozesse aufgespürt oder hierarchische Abhängigkeiten rekonstruiert werden müssen.
2. Der BSD-Standard: Systemweite Transparenz mit ps aux
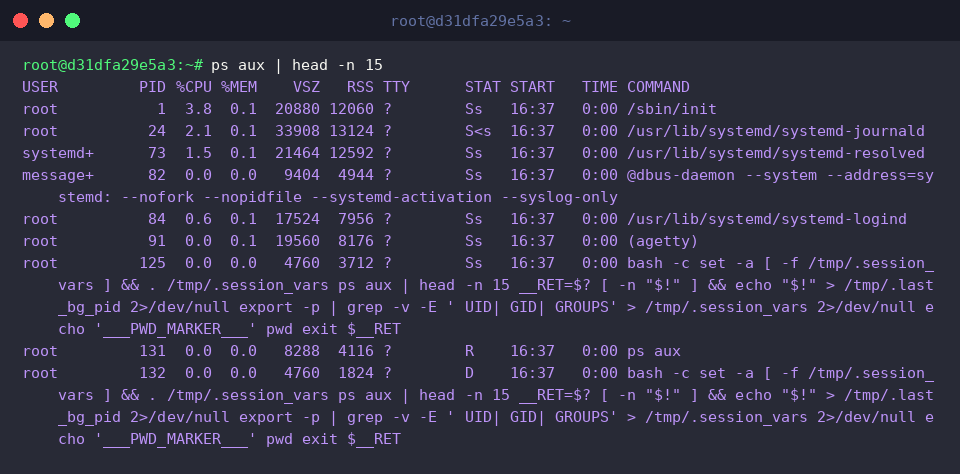
Die BSD-Notation ps aux verzichtet historisch bedingt auf führende Bindestriche und gewährt einen schonungslosen Rundumblick über jeden Prozess im Gesamtsystem.
Da diese Abfrage bei modernen Servern hunderte Zeilen umfasst, begrenzen wir den Datenstrom mittels head -n 15 auf die ersten 15 Einträge.
In der Ausgabe markiert USER den ausführenden Besitzer, während %CPU und %MEM den jeweiligen relativen Ressourcenverbrauch offenlegen.
Für die Speicherdokumentation sind VSZ (der gesamte reservierte virtuelle Speicher in KB) sowie RSS (Resident Set Size, der tatsächlich belegte physische RAM) entscheidend.
Über die Spalte STAT signalisiert der Kernel den aktuellen Zustand des Prozesses – darunter R für aktiv rechnend, S für unterbrechbaren Schlafmodus oder s für Sitzungsleiter (Session Leader).
Vervollständigt wird der Eintrag durch Startzeit (START), kumulierte Prozessorzeit (TIME) und den ursprünglichen Startbefehl (COMMAND).
3. Der UNIX/POSIX-Weg: Hierarchien analysieren mit ps -ef
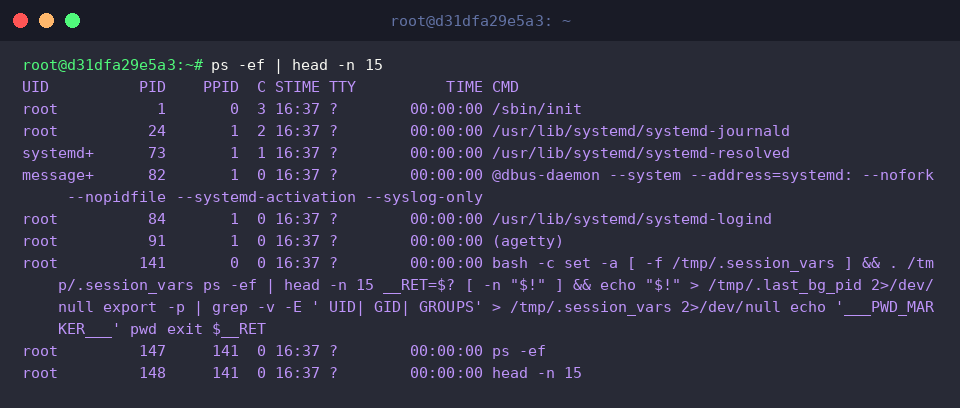
Als Alternative zur BSD-Syntax etablierte sich der POSIX-Standard ps -ef, der eine standardisierte, tabellarische Gesamtschau aller Tasks liefert.
Auch hier koppeln wir das Kommando mit head -n 15, um den Informationsfluss am Bildschirm kompakt zu halten.
Die resultierende Struktur zeigt den Prozessbesitzer unter UID, gefolgt von der eigenen PID sowie der übergeordneten Eltern-ID PPID.
Der Spaltenwert C spiegelt die CPU-Auslastung für das Scheduling wider, ergänzt um die Startuhrzeit STIME, das Steuerterminal TTY, die Laufzeit TIME und das ausführende Kommando CMD.
Das direkte Nebeneinander von PID und PPID macht diesen Aufruf zum perfekten Werkzeug, um Ursprung und Vererbung von Subtasks transparent nachzuvollziehen.
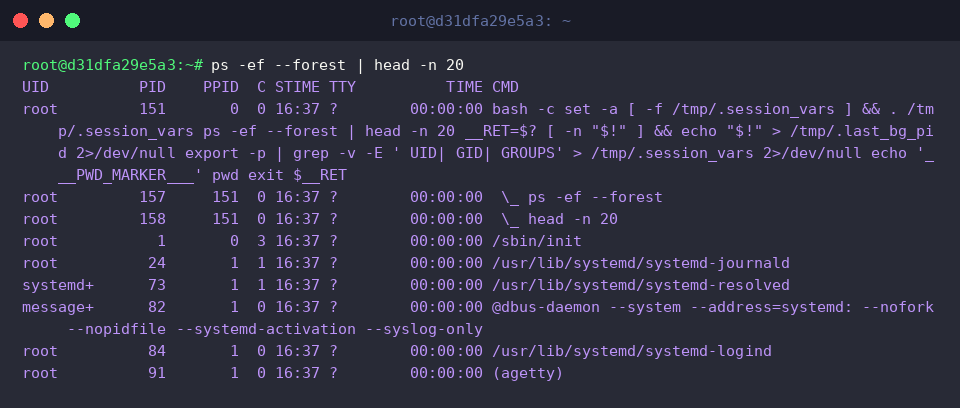
Wer Prozessbäume nicht mühsam per Hand anhand von Nummern vergleichen möchte, greift zur Baumansicht ps -ef --forest.
Die Weiterleitung an head -n 20 isoliert dabei die obersten Verästelungen der Systemhierarchie.
Mithilfe visueller Einrückungen und dem Präfix \_ in der Spalte CMD wird sofort ersichtlich, welche Kindprozesse von welchem Hauptdienst abgespalten wurden.
Diese Baumstruktur spart unschätzbare Zeit, wenn Daemon-Ketten, Worker-Pools oder komplexe Skript-Pipelines analysiert werden müssen.
4. Workflows für Fortgeschrittene: Gezielte Filterung und Sortierung
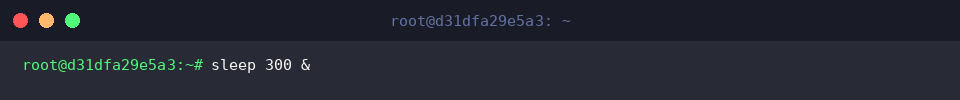
Um typische Szenarien der Systemadministration durchzuspielen, initiieren wir zunächst einen unkritischen Hintergrundjob via sleep 300 &, der fünf Minuten lang pausiert.
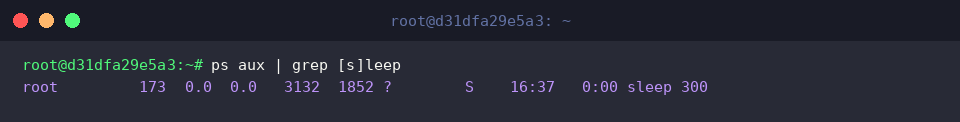
Bei der Suche nach bestimmten Prozessen entsteht oft das Problem, dass der Suchbefehl selbst in der Trefferliste auftaucht. Mit der Syntax ps aux | grep [s]leep lässt sich dieses Phänomen elegant umgehen: Der reguläre Ausdruck matcht den Zielprozess, schließt aber den grep-Befehl selbst aus.
Das Ergebnis liefert sauber die Eckdaten des zuvor erzeugten Tasks: PID (173), Schlafstatus (S) sowie den Startzeitpunkt.
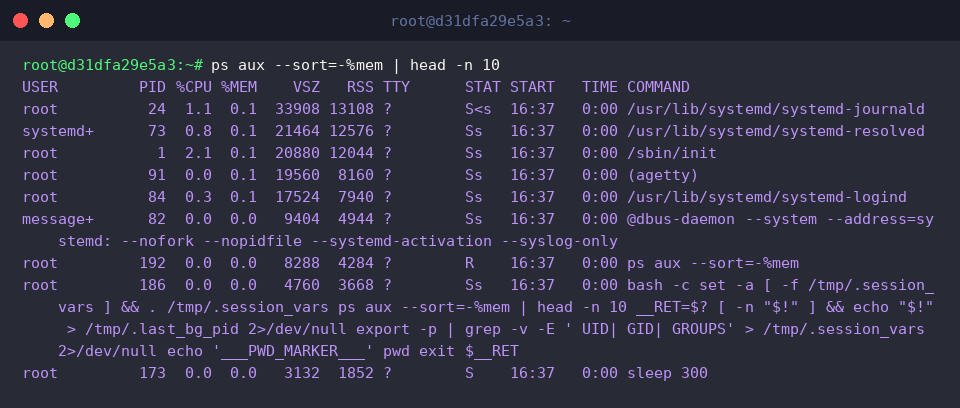
Droht dem System ein Speicherengpass, hilft der Parameter --sort=-%mem, der die Liste absteigend nach physischem RAM-Verbrauch ordnet.
In Kombination mit head -n 10 filtert diese Pipe blitzschnell die zehn größten Speicherfresser heraus – ideal für ein zügiges Troubleshooting.
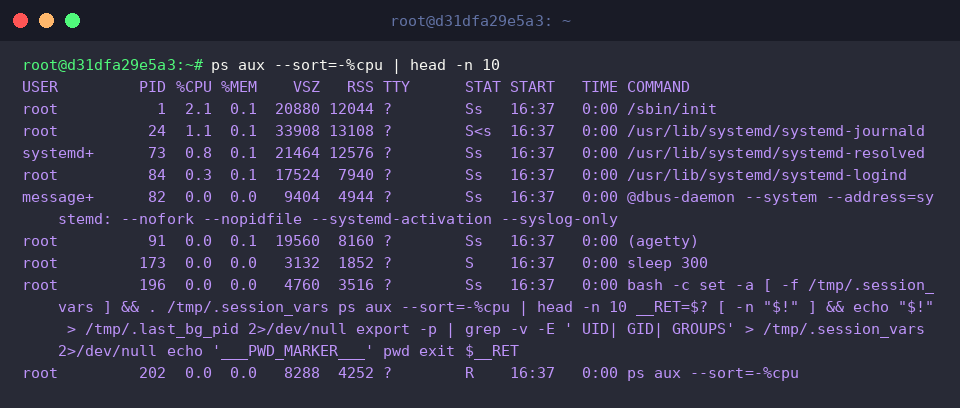
Äquivalent dazu identifiziert ps aux --sort=-%cpu diejenigen Tasks, die die Rechenkerne am stärksten belasten.
Wiederum genügen die ersten Zeilen via head -n 10, um CPU-Spitzenverursacher und Amok laufende Schleifen auf einen Blick dingfest zu machen.
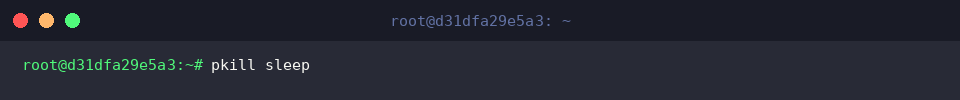
Nach Abschluss der Diagnoseübungen beenden wir den zuvor erstellten Hintergrundprozess sauber über pkill sleep, um die Systemumgebung wieder in ihren Ausgangszustand zu versetzen.
Mit diesen Kernbefehlen, Syntaxvarianten und Sortierpipelines besitzen Sie das fundamentale Rüstzeug, um Linux-Instanzen transparent zu überwachen und Engpässe im laufenden Serverbetrieb souverän zu beheben.