


Überblick
Kaum ein Werkzeug ist im Repertoire moderner DevOps-Ingenieure und Backend-Entwickler so unverzichtbar wie curl. Ob es um das schnelle Testen von Endpunkten, das Extrahieren von Header-Metadaten oder das Herunterladen umfangreicher Datensätze über instabile Netzwerke geht: Dieser praxisnahe Leitfaden führt systematisch durch die wichtigsten Parameter und Szenarien, die im Serveralltag regelmäßig benötigt werden.
1. Arbeitsumgebung einrichten und Basisabfragen ausführen (HTTP GET)
Bevor wir starten, bringen wir die lokalen Repositories auf den aktuellen Stand und stellen sicher, dass das Werkzeug auf dem System vorhanden ist:
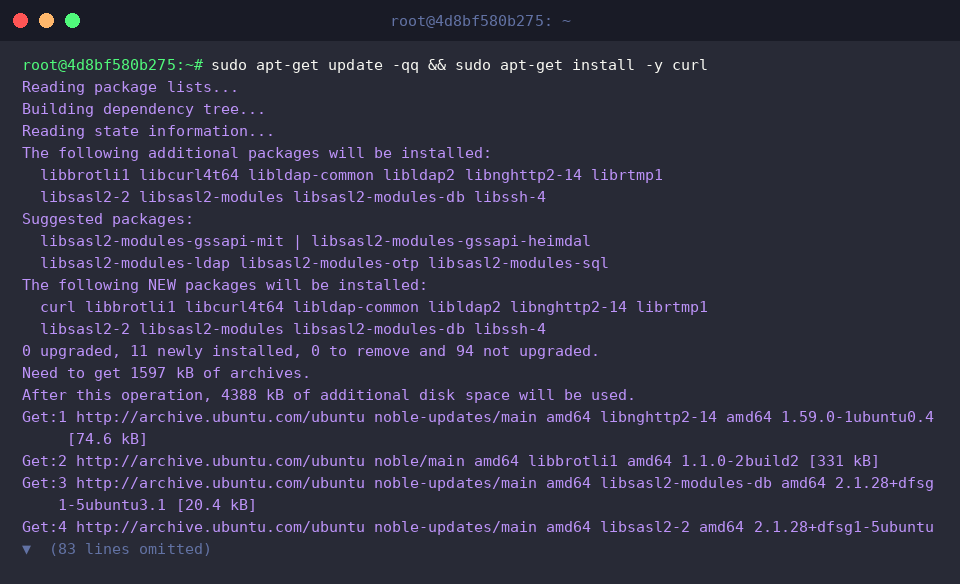
Das Utility curl agiert als vielseitiger URL-basierter Datentransfer-Client auf der Shell.
Wird dem Aufruf lediglich eine Zieladresse übergeben, sendet das Programm standardmäßig einen HTTP-GET-Request und leitet die empfangene Serverantwort unmittelbar auf die Standardausgabe (stdout) weiter.
⚙️ [Die wichtigsten Parameter im Überblick]
-s : Silent-Modus – unterdrückt Fortschrittsanzeigen sowie nicht kritische Meldungen für saubere Ausgaben.-i : Gibt die vom Server übermittelten HTTP-Header zusammen mit dem eigentlichen Antwortinhalt aus.-I : Führt einen HEAD-Request aus und liefert ausschließlich die Header-Zeilen ohne Response-Body.-X : Definiert explizit das zu verwendende HTTP-Verb (z. B. GET, POST, PUT, DELETE).-d : Übergibt die Nutzlast (Payload/Body) bei Schreiboperationen wie POST oder PUT an den Remote-Server.-H : Ergänzt den Request um benutzerdefinierte Header-Einträge.-o : Speichert den empfangenen Datenstrom unter einem frei definierbaren lokalen Dateinamen.-O : Übernimmt beim Speichern exakt die Dateibezeichnung der Remote-Ressource.-C - : Setzt zuvor unterbrochene Dateiübertragungen an der letzten bekannten Byte-Position fort (Resume).-L : Folgt eventuellen HTTP-Weiterleitungen (Statuscodes 3xx) automatisch bis zur finalen Zieladresse.
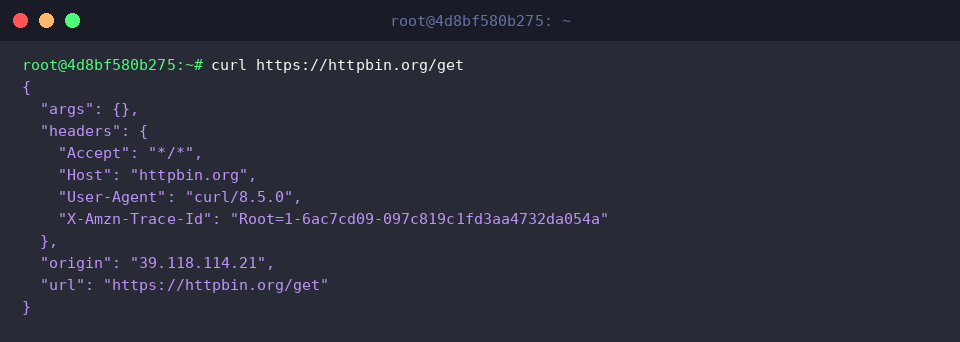
Mithilfe des Flags -s lässt sich die Ausgabe bereinigen, da Fortschrittsbalken und Transferstatistiken ausgeblendet werden.
Das ist insbesondere dann Gold wert, wenn Rückgabewerte in Bash-Pipelines (|) eingespeist oder innerhalb automatisierter Cronjobs weiterverarbeitet werden sollen.
2. HTTP-Antwortheader prüfen und Statuscodes isolieren
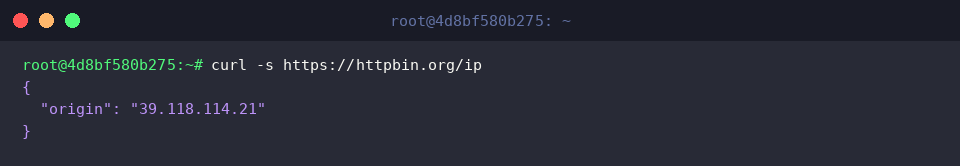
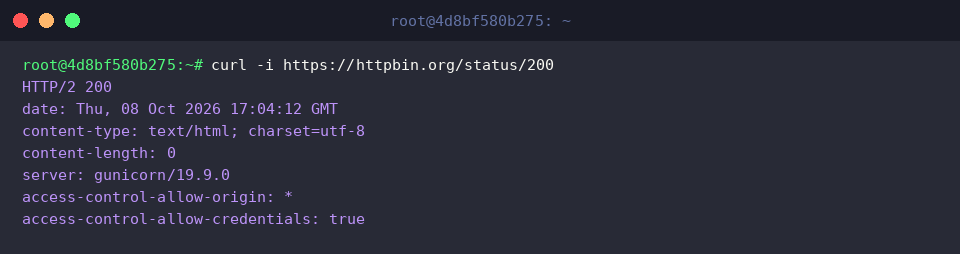
Um Diagnoseprozesse zu beschleunigen und Bandbreite einzusparen, liefert der Parameter -I die Metadaten des Webservers ohne den eigentlichen Payload.
Systemadministratoren nutzen diese Abfrage gern, um Protokollversionen (wie HTTP/2 200), MIME-Types oder Caching-Direktiven im Handumdrehen zu verifizieren.
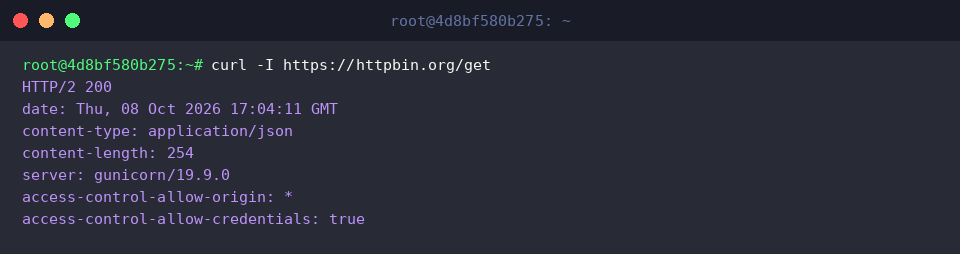
Möchte man hingegen Metainformationen und Nutzdaten gemeinsam untersuchen, empfiehlt sich die Option -i.
Gerade bei der Fehlersuche an Web-Schnittstellen erleichtert die kombinierte Anzeige den direkten Abgleich zwischen Response-Headern und dem gelieferten Body.
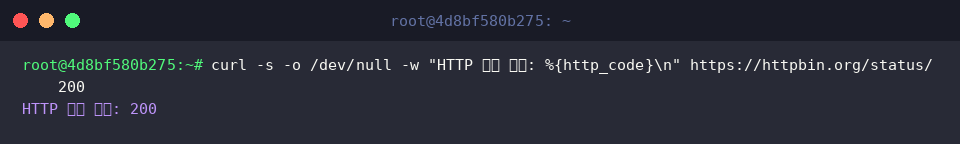
Für automatisierte Health-Checks und Monitoring-Skripte lässt sich die Abfrage weiter verfeinern: Wir kombinieren -s mit der Umleitung des Bodys nach -o /dev/null und extrahieren über das Format-Flag -w punktgenau den numerischen HTTP-Statuscode.
Dadurch lässt sich der Systemzustand ideal in Kontrollstrukturen (if/else) von Shell-Skripten abfangen.
3. Interaktion mit REST-APIs und Token-basierte Authentifizierung (POST & JSON)
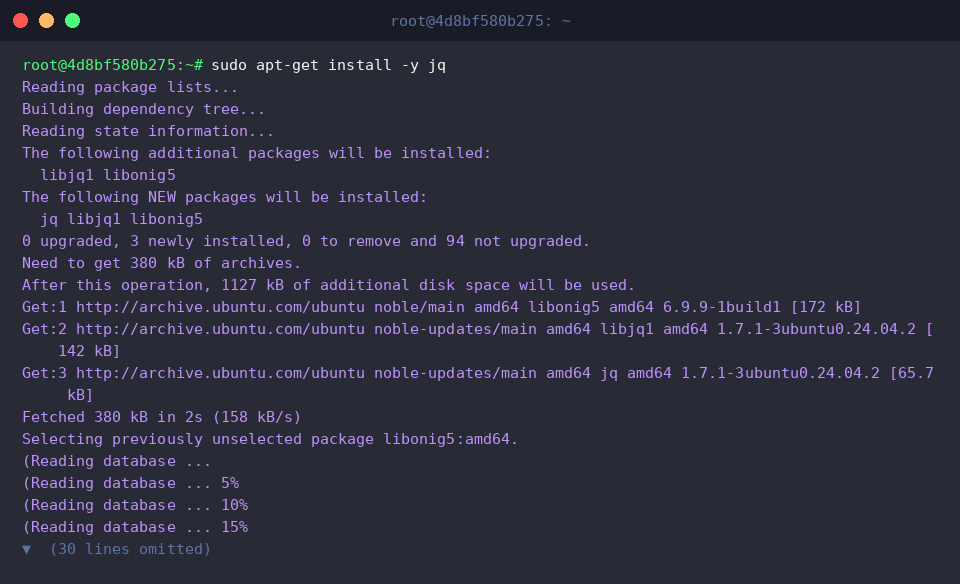
Für den eleganten Umgang mit strukturierten JSON-Antworten auf der Kommandozeile installieren wir zunächst den leichtgewichtigen Stream-Parser jq:
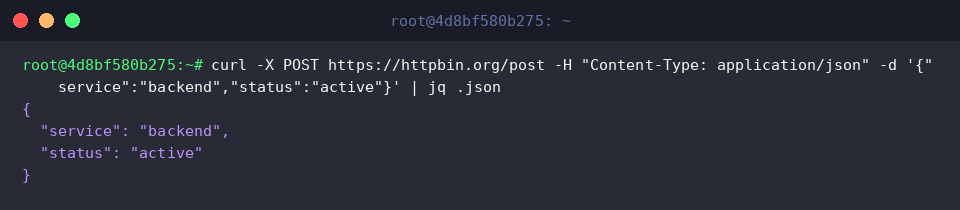
Mittels -X POST weisen wir die gewünschte Zugriffsmethode an, definieren über -H "Content-Type: application/json" das Datenformat und übergeben mit -d das JSON-Dokument.
Wird das Resultat über eine Pipe an jq übergeben, lässt sich die Serververarbeitung des gesendeten Payloads sofort übersichtlich und farblich hervorgehoben nachvollziehen.
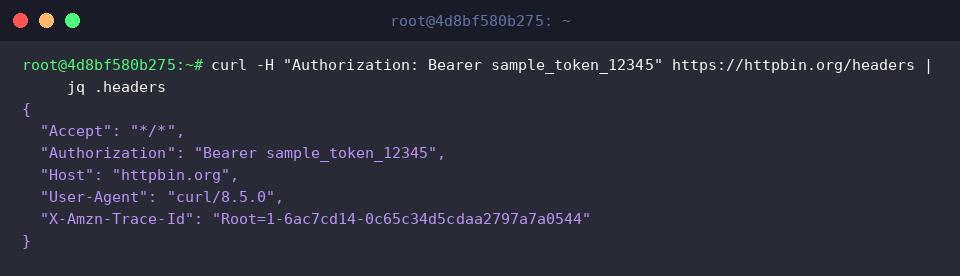
Geschützte Endpunkte verlangen in der Regel Autorisierungsnachweise. Durch Setzen des Authorization-Headers inklusive Bearer <Token> via -H wird die Authentifizierung nahtlos in den Request eingebunden.
So lässt sich verlässlich prüfen, ob Zugriffs-Token (wie JWTs) vom Zielserver korrekt interpretiert werden.
4. Zuverlässiges Herunterladen großer Dateien und Fortsetzen von Transfers
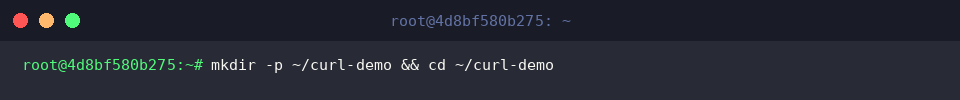
Für unsere Download-Tests legen wir ein separates Verzeichnis an und wechseln direkt hinein:
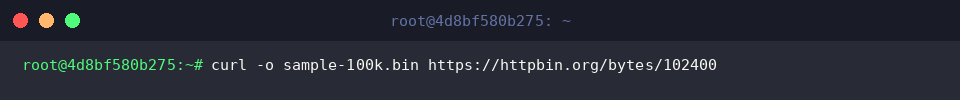
Binärdateien sollten niemals unkontrolliert im Terminalfenster landen. Durch Angabe von -o sample-100k.bin leiten wir den eintreffenden Bytestrom gezielt in die gewünschte lokale Zieldatei um.
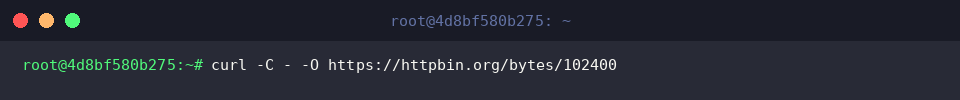
Bricht die Netzwerkverbindung bei umfangreichen Datentransfers ab, verhindert der Parameter -C - den zeitraubenden Neustart des gesamten Vorgangs: curl ermittelt die bereits vorhandene Dateigröße und fordert lediglich die fehlenden Bytes an, während -O die serverseitige Benennung beibehält.
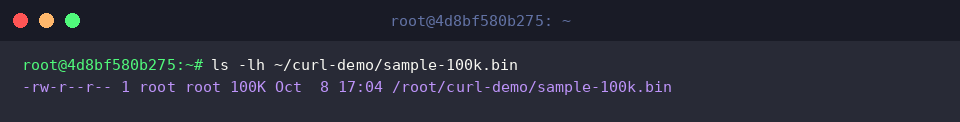
Abschließend prüfen wir die Integrität und Größe der heruntergeladenen Datei im Dateisystem mit dem Befehl ls -lh:
Mit diesem Fundament sind Sie bestens gerüstet, um Netzwerkinteraktionen effizient über das Terminal abzuwickeln. Nutzen Sie diese Parameterkombinationen, um manuelle Testabläufe zu beschleunigen und robuste Skripte für den produktiven Einsatz zu schreiben.