


Überblick
Große Protokolldateien belasten im entpackten Zustand Speicherplatz und I/O-Kapazitäten. Mit dem Dienstprogramm bzegrep können Linux-Administratoren bzip2-komprimierte Archive direkt nach Textmustern durchforsten, ohne das Archiv vorher mühsam entpacken zu müssen. In diesem Praxisleitfaden beleuchten wir die Funktionsweise des Befehls – von elementaren Suchabfragen bis hin zu komplexen regulären Ausdrücken zur gezielten Fehlerdiagnose.
Vorbereitung der Testumgebung und bzip2-Installation
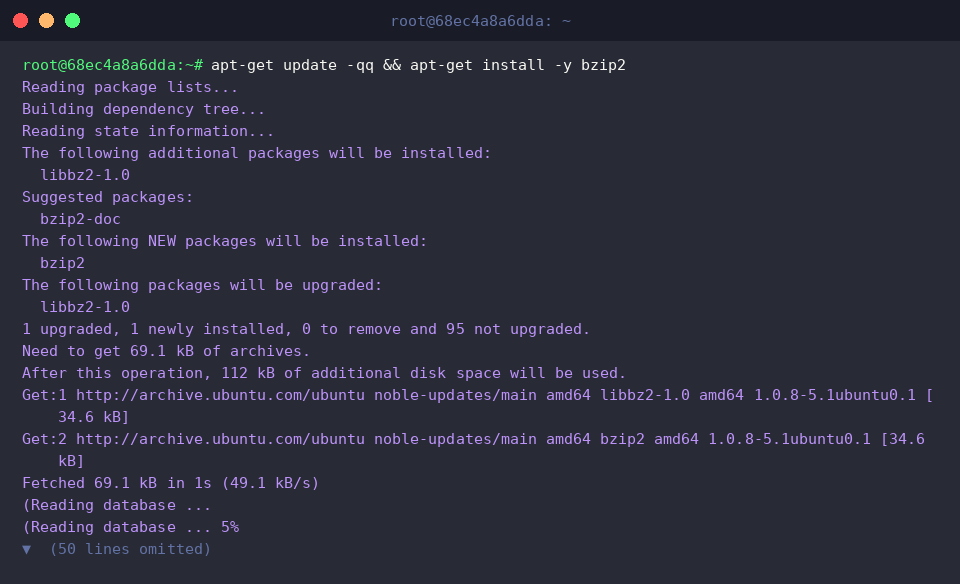
Um die benötigten Werkzeuge auf einem Ubuntu-System bereitzustellen, aktualisieren wir zunächst die Paketquellen und installieren anschließend das Paket bzip2.
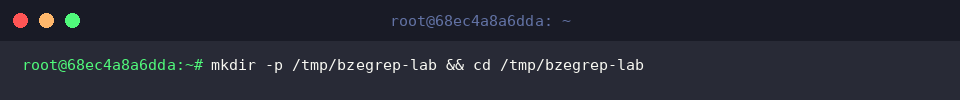
Für ein sauberes Arbeiten empfiehlt sich ein isoliertes Testverzeichnis. Mittels mkdir -p /tmp/bzegrep-lab && cd /tmp/bzegrep-lab legen wir diesen Ordner an und wechseln direkt hinein.
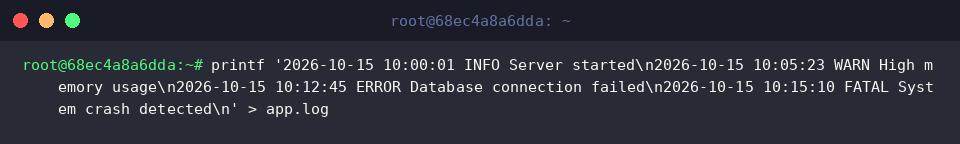
Als Datenbasis simulieren wir den typischen Meldungsverlauf eines Anwendungsdienstes und schreiben verschiedene Statusstufen in eine Beispieldatei namens app.log.
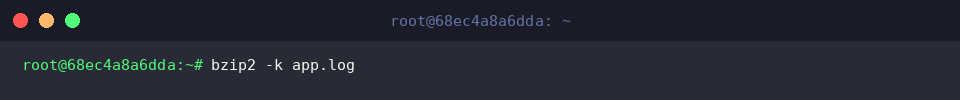
Mithilfe von bzip2 -k app.log komprimieren wir die Logdatei zu einem Archiv, wobei der Schalter -k sicherstellt, dass das unverpackte Original im Dateisystem erhalten bleibt.
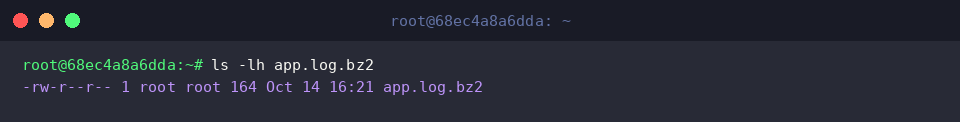
Ein Kontrollaufruf von ls -lh app.log.bz2 verifiziert das Vorhandensein sowie die finale Dateigröße des erzeugten Archivs.
Direkte Mustersuche in bz2-Dateien ohne Dekomprimierung
Wir wechseln vorab per cd /tmp/bzegrep-lab sicher in das Verzeichnis mit unseren vorbereiteten Datenbeständen.
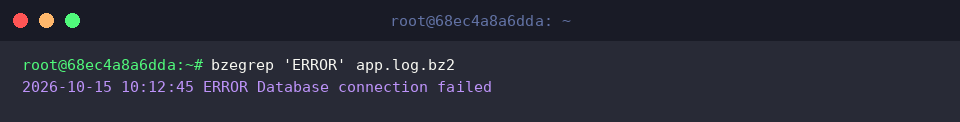
Mit dem Befehl bzegrep filtern wir nun gezielt nach Zeilen, die das Schlagwort ERROR enthalten, direkt innerhalb von app.log.bz2.
Das spart wertvollen Festplattenspeicher und Rechenzeit, da die Dekomprimierung transparent im Stream erfolgt und die Fehlereinträge sofort auf der Konsole ausgegeben werden.
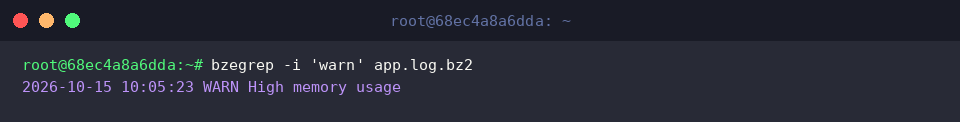
Um Groß- und Kleinschreibung zu ignorieren, übergeben wir den Parameter -i. Bei der Abfrage nach warn werden somit auch Treffer im Großformat wie WARN zuverlässig erfasst.
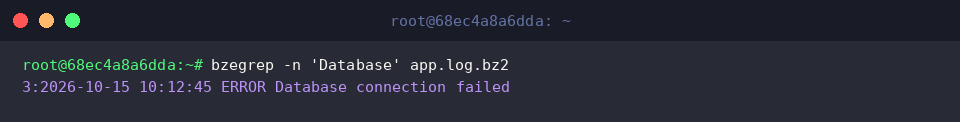
Für die genaue Verortung eines Fehlers im Ursprungstext liefert die Option -n die entsprechende Zeilennummer mit. Beim Suchbegriff Database signalisiert die vorangestellte 3 präzise die dritte Zeile der Quelldatei.
Erweiterte reguläre Ausdrücke (ERE) für komplexe Filter
Um fortzufahren, stellen wir mit cd /tmp/bzegrep-lab sicher, dass wir uns weiterhin im richtigen Testpfad befinden.
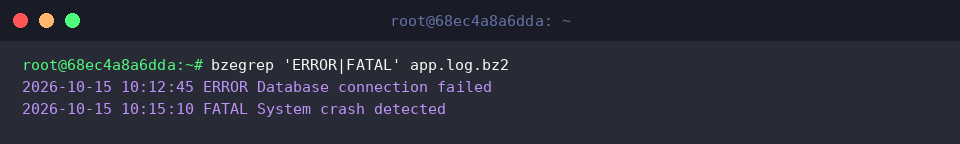
Ein wesentlicher Vorteil von bzegrep gegenüber bzgrep ist die native Unterstützung erweiterter regulärer Ausdrücke (Extended Regular Expressions, ERE). Über das Pipe-Symbol (|) lassen sich mehrere Bedingungen wie ERROR oder FATAL in einer einzigen Abfrage zusammenfassen.
Die Trefferausgabe enthält prompt sowohl kritische Systemabstürze als auch reguläre Fehlermeldungen.
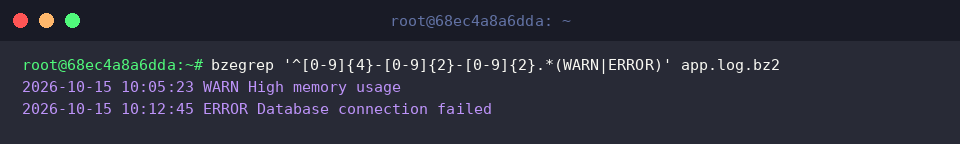
Auch anspruchsvollere Kriterien stellen kein Hindernis dar: Ein Regex-Muster, das einen einleitenden Zeitstempel mit anschließenden Warn- oder Fehlerindikatoren (WARN bzw. ERROR) verknüpft, filtert den Datenstrom hochpräzise.
Lediglich Zeilen, die exakt diesem strukturellen Schema entsprechen, erscheinen im Terminal.
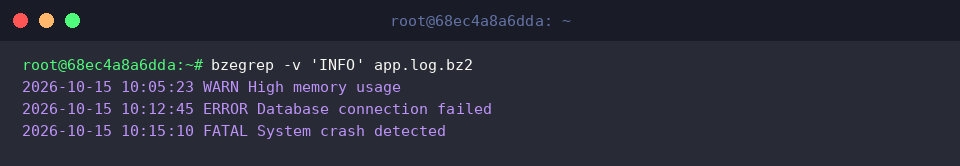
Möchte man Routineeinträge ausblenden, kehrt das Flag -v die Trefferlogik um. Durch den Ausschluss von INFO verbleiben ausschließlich diejenigen Ereignisse, die tatsächliche Aufmerksamkeit erfordern.
Durchsuchen mehrerer Archive und gezielte Trefferauswertung
Wir wechseln erneut mit cd /tmp/bzegrep-lab in unser Laborverzeichnis, um die nächsten Befehle vorzubereiten.
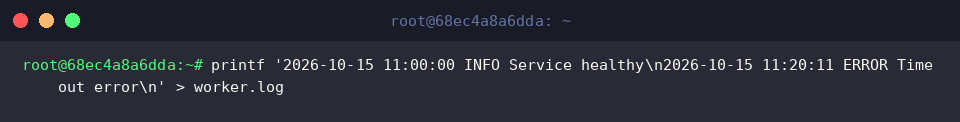
Für die gleichzeitige Analyse mehrerer Archive erstellen wir eine zweite Beispieldatei namens worker.log, die Protokolle eines Hintergrundprozesses abbildet.
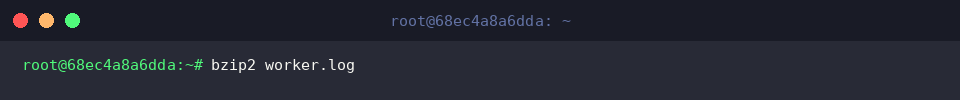
Diese Datei komprimieren wir direkt mit bzip2 worker.log zu einem weiteren bz2-Archiv.
Mithilfe von Wildcards wie *.bz2 durchsucht bzegrep sämtliche vorhandenen Archive in einem Durchgang. Die Option -H sorgt dafür, dass jeder ausgegebenen Trefferzeile der jeweilige Dateiname eindeutig vorangestellt wird.
Dadurch lässt sich sofort erkennen, aus welchem Archiv der jeweilige Fehlereintrag stammt.
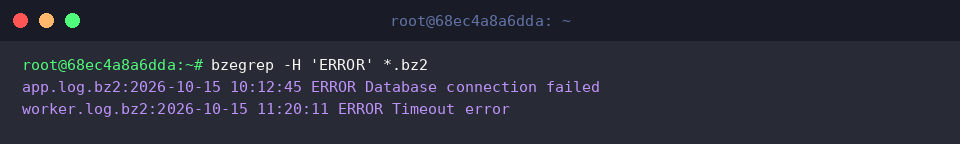
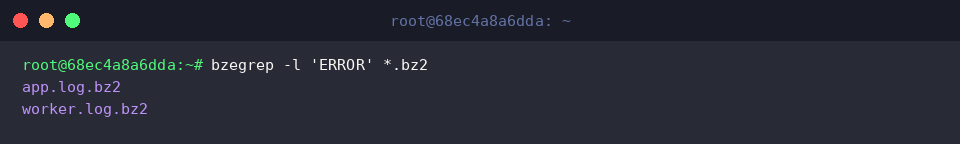
Steht nicht der Inhalt, sondern lediglich die Identifikation betroffener Dateien im Fokus, hilft der Parameter -l.
Das System gibt daraufhin ausschließlich die Namen der Archive aus, in denen das Suchmuster ERROR auftrat.
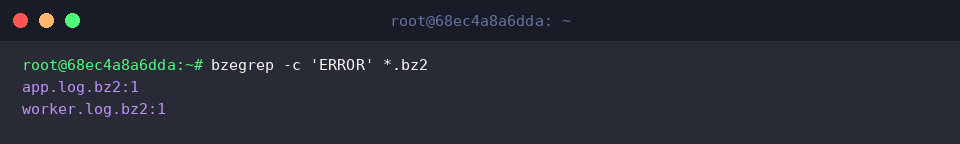
Zur quantitativen Auswertung eignet sich der Zählschalter -c.
Anstelle ganzer Protokollzeilen ermittelt bzegrep damit pro Archiv die exakte Trefferanzahl für ERROR.
Damit bietet bzegrep unter Linux ein ungemein zeitsparendes Instrumentarium für die Systemadministration. Das Durchforsten komprimierter Protokolldaten ohne vorgeschaltetes Dekomprimieren schont Systemressourcen und beschleunigt die Fehlereingrenzung in Produktionsumgebungen spürbar.