


Einleitung: Effiziente Textsuche in komprimierten bz2-Archiven
Mit dem Befehl bzfgrep lassen sich feste Zeichenketten (Fixed Strings) direkt in bzip2-komprimierten Archiven (.bz2) lokalisieren, ohne die Dateien vorher mühsam auf das Dateisystem zu entpacken. Insbesondere bei umfangreichen Server-Logs und historischen Archivbeständen schont dieses Vorgehen wertvollen Speicherplatz und minimiert zeitraubende Schreib- und Lesevorgänge spürbar. Dieser Leitfaden demonstriert praxisnahe Einsatzszenarien für den Sysadmin-Alltag.
Paketprüfung und Vorbereitung einer komprimierten Testdatei
Um sicherzustellen, dass das Werkzeug bereitsteht, prüfen Administratoren zunächst die Verfügbarkeit von bzfgrep auf dem System und installieren bei Bedarf das Basispaket bzip2.
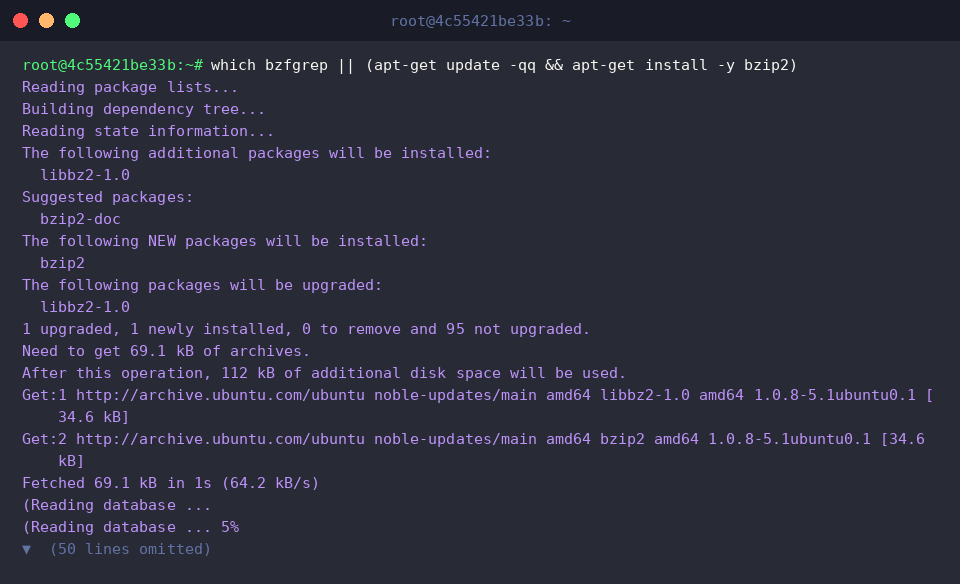
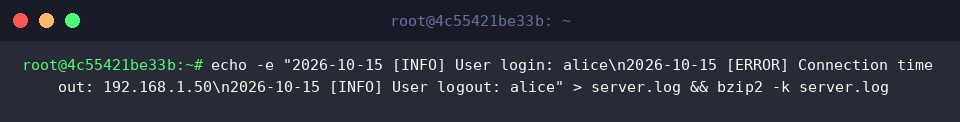
Für den anschließenden Suchtest erzeugen wir eine beispielhafte Protokolldatei mit typischen Meldungen. Die Option -k beim Aufruf von bzip2 stellt sicher, dass die ursprüngliche Textdatei nach der Kompression erhalten bleibt:
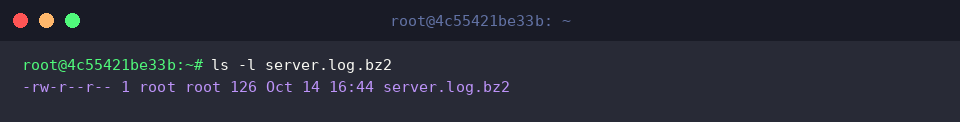
Ein kurzer Blick auf Dateigröße und Dateirechte über ls -l server.log.bz2 bestätigt die erfolgreiche Bereitstellung des komprimierten Testarchivs.
Grundlagen der Mustersuche mit bzfgrep ohne Dekompression
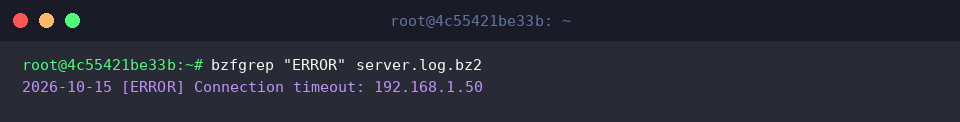
Mittels bzfgrep greift man unmittelbar auf den Inhalt von server.log.bz2 zu, um sämtliche Zeilen mit dem Schlüsselwort ERROR herauszufiltern. Der Dekompressionsschritt entfällt vollständig; die Terminalausgabe liefert sofort den relevanten Fehlerhinweis zum Netzwerk-Timeout:
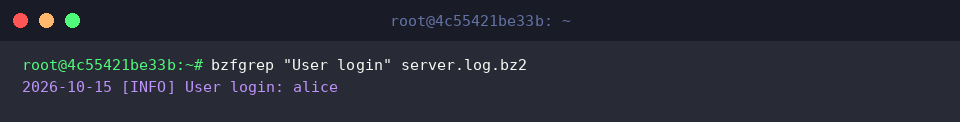
Enthält der Suchbegriff Leerzeichen wie bei User login, wird die Zeichenfolge in Anführungszeichen gefasst. Da bzfgrep den Ausdruck strikt als feste Zeichenkette interpretiert und Sonderzeichen nicht als reguläre Ausdrücke wertet, erscheint der passende Anmeldedatensatz von Nutzerin alice ohne jegliche Verarbeitungsverzögerung:
Gezielte Filterung: Schalter für Schreibweise (-i), Zeilennummern (-n) und Zählung (-c)
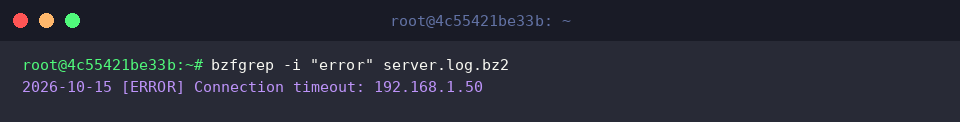
Möchte man Treffer unabhängig von Groß- oder Kleinschreibung erfassen, kommt der Parameter -i zum Einsatz. Dadurch identifiziert bzfgrep auch kleingeschriebene Begriffe wie error und gibt den großgeschriebenen Eintrag [ERROR] aus der Protokolldatei zuverlässig aus:
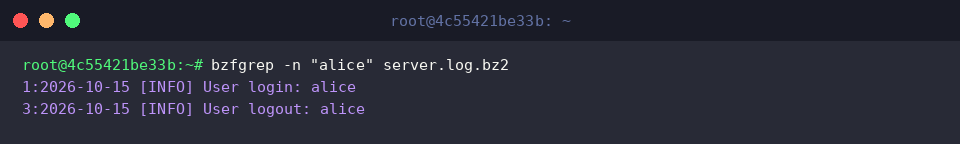
Gerade bei langen Trace-Logs ist die exakte Position entscheidend: Das Flag -n blendet die Zeilennummer der Originaldatei direkt vor dem Treffer ein, sodass sich Fundstellen wie der Benutzername alice unmittelbar im Kontext verorten lassen:
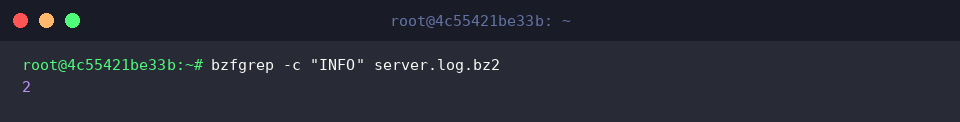
Wenn nicht der Zeilentext selbst, sondern lediglich die Gesamtzahl relevanter Ereignisse interessiert, aggregiert die Option -c das Ergebnis. Eine Abfrage nach INFO in server.log.bz2 liefert sekundenschnell den Zählerstand von 2 Treffern:
Paralleles Durchsuchen mehrerer Archive und Dateinamen-Anzeige (-l, -H)
Um das Verhalten über mehrere Archive hinweg zu demonstrieren, legen wir ein weiteres Testprotokoll an und komprimieren dieses direkt via bzip2:
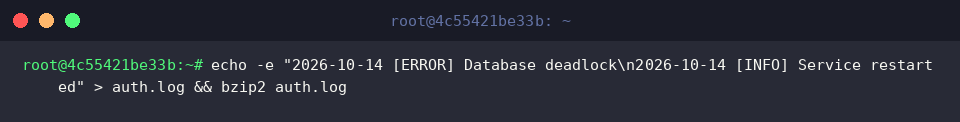
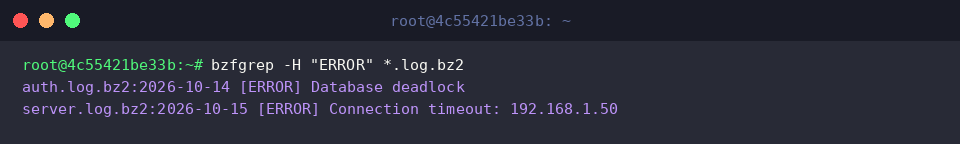
Bei Abfragen über Wildcards (*.log.bz2) sorgt der Schalter -H für klare Verhältnisse: Jeder ausgegebenen Zeile wird der zugehörige Archivname vorangestellt. Auf diese Weise lässt sich auf einen Blick unterscheiden, ob der ERROR-Eintrag aus auth.log.bz2 oder server.log.bz2 stammt:
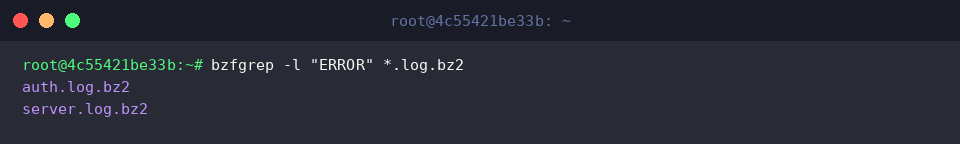
Soll hingegen lediglich herausgefunden werden, welche Archive überhaupt betroffene Datensätze enthalten, unterdrückt -l die Zeilenausgabe und listet ausschließlich die entsprechenden Dateinamen auf. Dies isoliert betroffene Dateien wie auth.log.bz2 und server.log.bz2 effizient für anschließende Analyseschritte:
Damit steht Linux-Administratoren mit bzfgrep ein schlankes, ressourcenschonendes Werkzeug zur Verfügung, um komprimierte Protokollarchive ohne vorangehende Extraktion zielgenau zu analysieren. Durch die Kombination mit praxisbewährten Parametern lassen sich Diagnoseprozesse in Produktionsumgebungen deutlich beschleunigen.