


Einleitung und Problemstellung
Unleserliche Zeichenfolgen („Mojibake“) in Textdateien oder Serverlogs stellen Systemadministratoren unter Linux regelmäßig vor Herausforderungen. Bevor sich beschädigte Zeichensätze zielgerichtet reparieren lassen, muss das zugrundeliegende Encoding zweifelsfrei identifiziert werden. In diesem Praxishandbuch wird Schritt für Schritt demonstriert, wie Sie das Dienstprogramm chardetect einrichten, unbekannte Kodierungen zuverlässig analysieren und Dateiinhalte anschließend automatisiert konvertieren.
chardetect-Toolchain einrichten und Optionen verstehen
Zur Vorbereitung aktualisieren wir die APT-Paketquellen des Systems und richten das Paket python3-chardet mitsamt Hilfswerkzeugen ein:
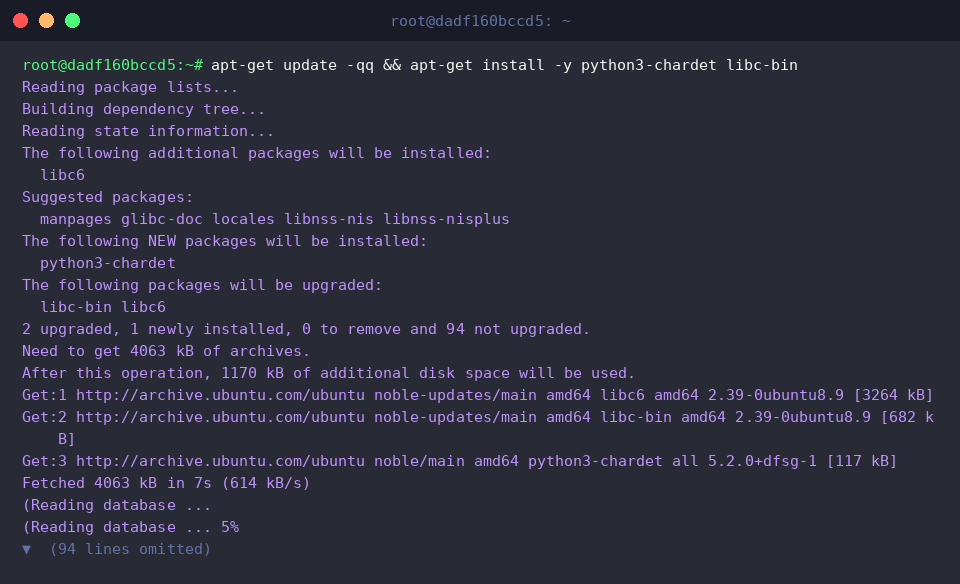
Über das CLI-Werkzeug chardetect wird der verwendete Zeichensatz (Charset) von Textdateien oder Rohdatenströmen inklusive einer statistischen Wahrscheinlichkeit (Confidence-Score) ermittelt.
Ein schneller Versionsabgleich gelingt über den Parameter --version.
⚙️ [Zentrale Steuerparameter]
-l, --line-per-line : Analysiert nicht das gesamte Dokument am Stück, sondern prüft jede Textzeile separat.--minimal : Unterdrückt Detailwerte und gibt lediglich die Kurzbezeichnung der ermittelten Kodierung aus.-h, --help : Ruft die integrierte Kurzanleitung mit sämtlichen Steuerflags auf.--version : Gibt Versions- sowie Release-Informationen aus und beendet das Programm unmittelbar.
Erstellung von Testdateien und Verifikation verschiedener Kodierungen
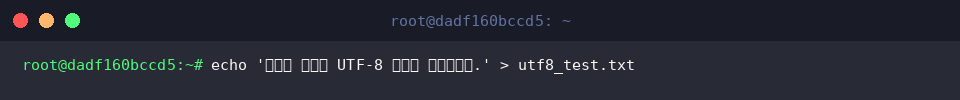
Um das Erkennungsverhalten praktisch zu demonstrieren, erzeugen wir mittels echo zunächst ein Dokument im Standardformat UTF-8 namens utf8_test.txt:
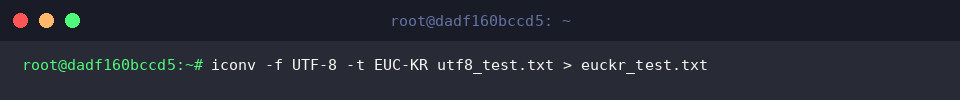
Für Vergleichszwecke wird nun ein abweichender Zeichensatz benötigt. Mittels iconv überführen wir die UTF-8-Zeichenfolge in das ostasiatische Legacy-Format EUC-KR und speichern das Ergebnis in euckr_test.txt ab:
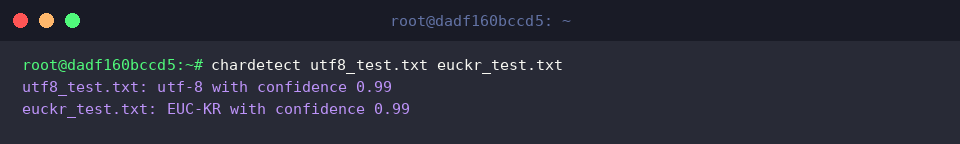
Werden beide Testdokumente gemeinsam an chardetect übergeben, ermittelt der Heuristik-Algorithmus jeweils die Spezifikation und den Genauigkeitswert:
In der Ausgabe ordnet das Werkzeug utf8_test.txt einwandfrei als UTF-8 und euckr_test.txt als EUC-KR ein – jeweils mit einem Konfidenzwert von überzeugenden 99 %.
Pipeline-Integration via stdin und Verzeichnis-Batch-Analyse
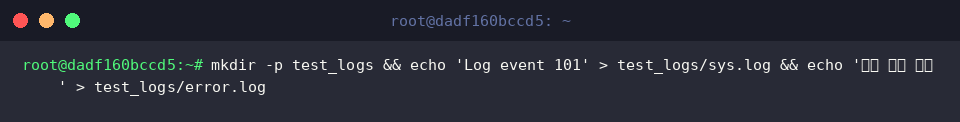
Im administrativen Alltag müssen oft dynamisch erzeugte Logs geprüft werden. Folgender Befehl legt einen Testordner test_logs an und füllt diesen mit zwei Beispieldateien unterschiedlichen Inhalts: mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log.
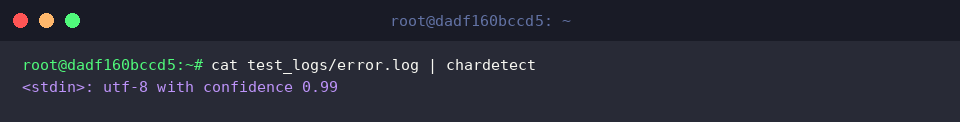
Über das Pipe-Zeichen (|) lässt sich der Inhalt beliebiger Dateien via cat direkt an den Standard-Input (stdin) von chardetect weiterreichen.
Das Tool interpretiert den Datenstrom als Kennung <stdin> und bestätigt die UTF-8-Kodierung mit 99 % Zuverlässigkeit.
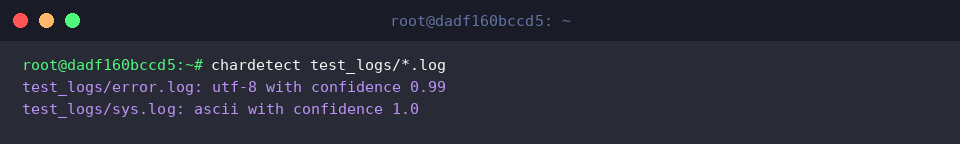
Bei größeren Mengen an Protokolldateien spart die Verwendung von Shell-Wildcards (*) enorm viel Zeit. Ein einziger Aufruf genügt, um das gesamte Verzeichnis test_logs abzuarbeiten:
Hierbei stuft chardetect die rein aus lateinischen Schriftzeichen bestehende sys.log treffend als ASCII ein, während die mit Multibyte-Zeichen versehene Datei error.log als UTF-8 deklariert wird.
Funktionsweise der Bytemuster-Analyse und Migration via iconv
Unter der Haube stützt sich das CLI-Programm auf die Python-Bibliothek chardet. Ein gezielter Einzeiler offenbart, wie die zugrundeliegenden Bytefolgen ausgewertet werden:
Die Methode analysiert die rohe Binärstruktur der Datei und liefert ein Python-Dictionary mit dem identifizierten Zeichensatz (EUC-KR), dem Konfidenzkoeffizienten (0.99) sowie dem zugehörigen Sprachkreis (Korean) zurück.
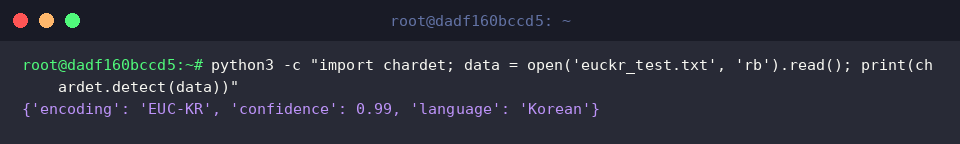
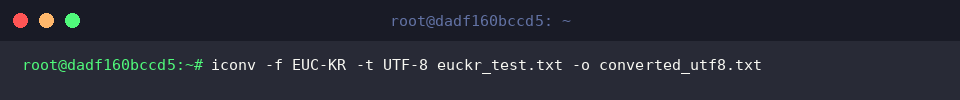
Sobald die ursprüngliche Kodierung feststeht, kann die Datei verlustfrei migriert werden. Hierfür nutzen wir iconv, um euckr_test.txt in modernes UTF-8 zu überführen:
Dank -f EUC-KR (Quellzeichensatz) und -t UTF-8 (Zielzeichensatz) speichert das Flag -o converted_utf8.txt den bereinigten Text ohne Datenverlust ab.
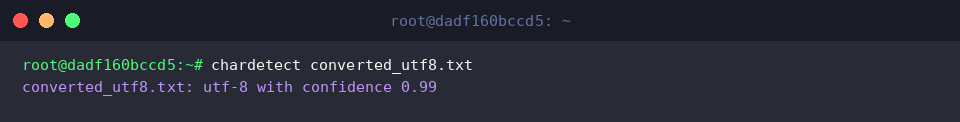
Ein abschließender Kontrolllauf über das neu generierte Dokument converted_utf8.txt belegt den Erfolg des Vorgangs:chardetect bestätigt die erfolgreiche Transformation auf UTF-8 mit einem Spitzenwert von 99 % Zuverlässigkeit.
Mit dem Zusammenspiel aus heuristischer Analyse via chardetect und gezielter Re-Kodierung per iconv steht Ihnen ein hochgradig verlässliches Instrumentarium zur Verfügung, um beschädigte Zeichensätze auf Linux-Servern schnell aufzuspüren und sauber zu reparieren.