


Überblick
Das Linux-Dienstprogramm cmp ermöglicht eine extrem performante Überprüfung zweier Dateien auf Byte-Ebene. Dieser Leitfaden demonstriert praxisnah die elementare Bedienung sowie wichtige Parameter. Neben regulären Textdokumenten eignet sich das Tool vor allem für Binärformate sowie die Statuscode-Auswertung in automatisierten Shell-Skripten.
Basisprüfung: Erste Diskrepanz nach Byte und Zeile lokalisieren
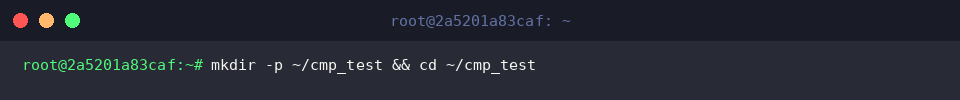
Für die folgenden Testläufe richten wir zunächst ein isoliertes Arbeitsverzeichnis ein und wechseln direkt dorthin: mkdir -p ~/cmp_test && cd ~/cmp_test.
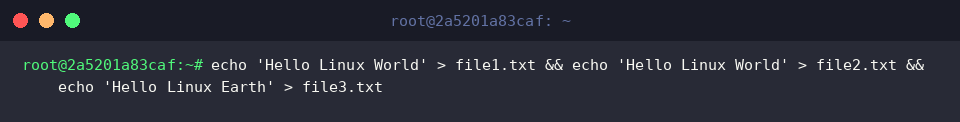
Mittels echo erzeugen wir drei Testdateien: file1.txt und file2.txt mit identischem Inhalt sowie file3.txt mit einer gezielten Abweichung am Zeilenende.
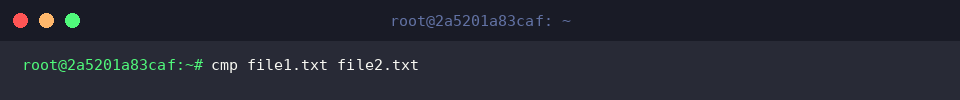
Das Programm vergleicht Datenströme sequenziell Byte für Byte. Sind beide Quellen vollkommen deckungsgleich, beendet sich der Prozess geräuschlos ohne jegliche Terminalausgabe.
⚙️ [Zentrale Parameter im Überblick]
-b : Zeigt bei Abweichungen zusätzlich den Oktalwert sowie das entsprechende Zeichen an.-l : Gibt eine vollständige tabellarische Aufstellung aller differierenden Bytes samt Offset aus.-n : Begrenzt den Prüfvorgang strikt auf eine festgelegte Anzahl an Bytes.-i : Überspringt zu Beginn beider Dateien eine definierte Byte-Menge vor dem Vergleich.-s : Unterdrückt sämtliche Bildschirmausgaben und liefert ausschließlich den Exit-Status (0 oder 1).
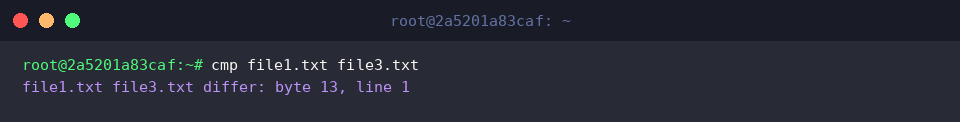
Führen wir nun die Prüfung auf ungleichen Dateien aus: cmp file1.txt file3.txt.
Sobald der Algorithmus auf eine Diskrepanz stößt, bricht er standardmäßig ab und meldet die exakte Position (Byte- und Zeilennummer).
Detaillierte Byte-Analyse: Alle Abweichungen auflisten (-l, -b)
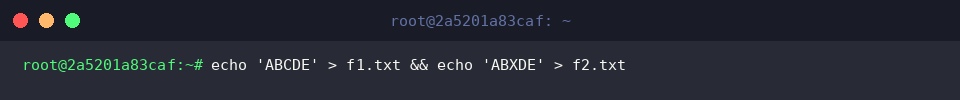
Um das Verhalten bei partiellen Differenzen genauer zu analysieren, generieren wir zwei kurze Zeichenfolgen in f1.txt und f2.txt.
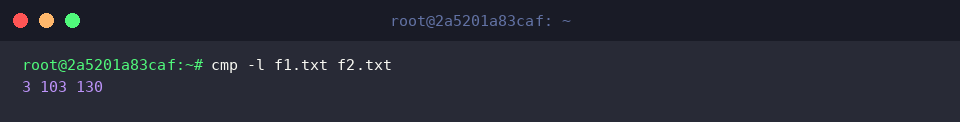
Mit dem Schalter -l (cmp -l f1.txt f2.txt) veranlassen wir das Werkzeug, die Prüfung nicht vorzeitig zu stoppen, sondern jeden abweichenden Offset nebst Oktalwerten beider Quellen aufzulisten.
Im Beispiel divergiert das 3. Byte: Datei 1 enthält den Oktalwert 103 (C), Datei 2 den Wert 130 (X).
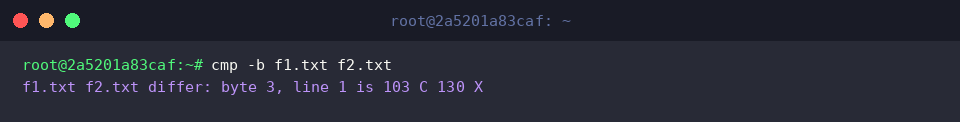
Zusätzliche Lesbarkeit verschafft der Schalter -b: cmp -b f1.txt f2.txt blendet neben den Oktalcodes direkt die lesbaren Zeichen ein.
Dadurch lässt sich sofort erkennen, dass an Position 3 ein Austausch von C zu X stattfand.
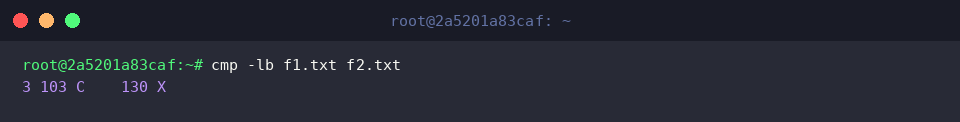
Kombiniert man beide Optionen zu cmp -lb f1.txt f2.txt, liefert das Tool eine lückenlose Übersicht: Byte-Position, numerische Kodierung und ASCII-Darstellung stehen übersichtlich nebeneinander.
Automatisierung in Skripten: Silent-Modus und Exit-Codes (-s)
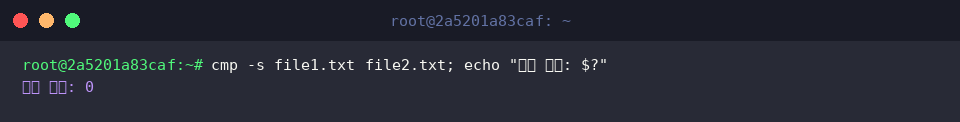
In CI/CD-Pipelines oder Shell-Skripten ist Bildschirmausgabe meist unerwünscht. Die Option -s schaltet das Kommando stumm und signalisiert das Ergebnis rein über den Rückgabewert $?.
Bei absolut identischen Dateien wird der Erfolgsstatus 0 zurückgegeben:
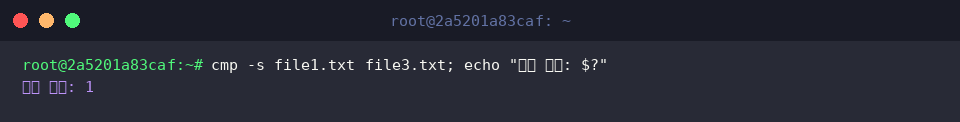
Unterscheiden sich die Dateien hingegen an mindestens einer Stelle, resultiert die Prüfung im Rückgabewert 1:
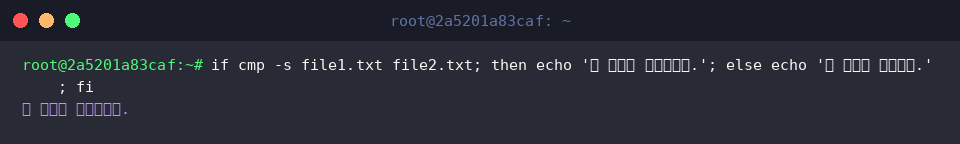
Dadurch lässt sich cmp -s hervorragend als Bedingung in if-Verzweigungen einbetten, um Workflows abhängig von Dateiinhalten dynamisch zu steuern.
Da beide Datenbestände übereinstimmen, schlägt die Verzweigung erfolgreich an:
Prüfbereich einschränken: Offset (-i) und Byte-Limit (-n) setzen
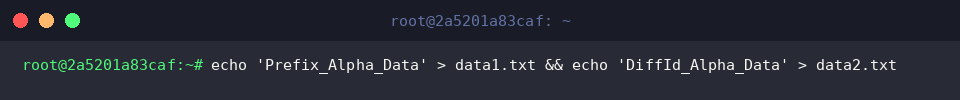
Häufig besitzen Dateien variable Metadaten-Header, während der Nutzdatenbereich identisch ist. Hierfür erstellen wir data1.txt und data2.txt mit unterschiedlichen Präfixen, aber übereinstimmendem Schlussteil.
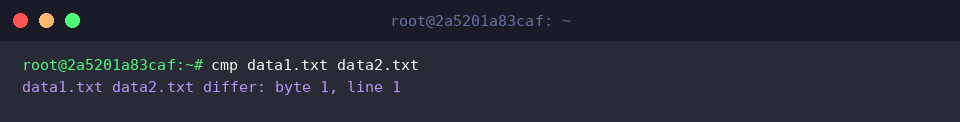
Ein regulärer Aufruf via cmp data1.txt data2.txt schlägt erwartungsgemäß sofort beim allerersten Zeichen fehl:
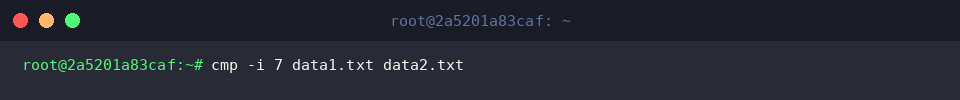
Über den Parameter -i 7 instruieren wir den Befehl, die einleitenden 7 Bytes vollständig zu ignorieren.
Da das verbleibende Segment (Alpha_Data) deckungsgleich ist, terminiert der Aufruf ohne Fehlermeldung:
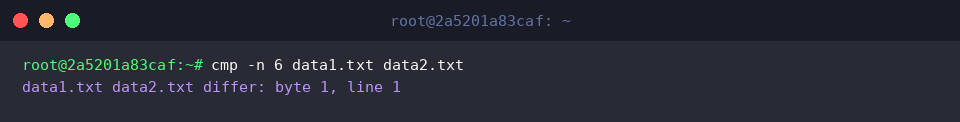
Möchte man umgekehrt nur den Kopfbereich untersuchen, greift man zu -n. Mit cmp -n 6 data1.txt data2.txt beschränken wir die Analyse auf die ersten 6 Bytes.
Da der Unterschied direkt am Dateianfang liegt, meldet das System die Abweichung an Byte 1 ordnungsgemäß:
Damit haben wir die Kernfunktionen des Linux-Werkzeugs cmp sowie praxisorientierte Anwendungsfälle detailliert durchleuchtet.
Besonders beim Validieren umfangreicher Backups, Firmware-Images oder kompilierter Binärdateien erweist sich dieses Tool als unverzichtbarer Geschwindigkeitsvorteil gegenüber zeilenbasierten Alternativen.