


Überblick
Beim Administrieren von Linux-Systemen gehört der direkte Abgleich zweier Textdateien zum täglichen Handwerk. Das Standardwerkzeug comm bietet hierfür eine extrem performante Lösung, um Übereinstimmungen und Abweichungen zeilenbasiert aufzudecken. Diese Anleitung vermittelt praxisnah den Aufbau der dreispaltigen Standardausgabe, gezielte Mengenschnitt-Filterungen per Schalter sowie fortgeschrittene Techniken für unordentliche Datenbestände im Produktivalltag.
1. Funktionsweise und die dreispaltige Ausgabe des comm-Befehls
Für einen sauberen Testaufbau richten wir zunächst eine isolierte Umgebung im Benutzerverzeichnis ein und wechseln direkt dorthin:
mkdir -p ~/comm_lab && cd ~/comm_lab
Als Referenzbasis erzeugen wir die erste Textdatei fruits_a.txt mit alphabetisch vorsortierten Zeileneinträgen:
printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt
Im Anschluss erstellen wir das Gegenstück fruits_b.txt, welches teils identische und teils neue Einträge umfasst:
printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt
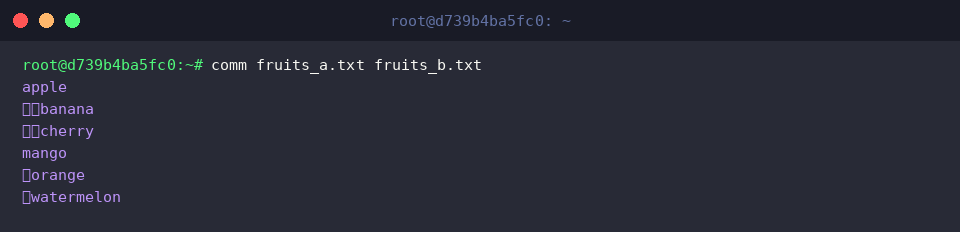
Das Dienstprogramm comm führt einen zeilenweisen Abgleich zweier lexikografisch sortierter Dateien durch und strukturiert das Resultat standardmäßig in drei Tabulator-getrennte Spalten:
- Spalte 1 (ohne Einrückung): Zeilen, die ausschließlich in Datei 1 vorkommen.
- Spalte 2 (ein Tabulator eingerückt): Zeilen, die lediglich in Datei 2 existieren.
- Spalte 3 (zwei Tabulatoren eingerückt): Einträge, die in beiden Quellen identisch vorliegen.
⚙️ [Wesentliche Parameter]
-1 : Unterdrückt Spalte 1 (versteckt exklusive Einträge der ersten Datei).-2 : Unterdrückt Spalte 2 (versteckt exklusive Einträge der zweiten Datei).-3 : Unterdrückt Spalte 3 (blendet gemeinsame Schnittmengen aus).--check-order : Forciert die Überprüfung, ob beide Eingabedateien strikt sortiert vorliegen.--nocheck-order : Deaktiviert die interne Überprüfung der Sortierreihenfolge.--output-delimiter=STR : Ersetzt den standardmäßigen Tabulator-Trennstrich durch eine frei wählbare Zeichenkette (STR).
2. Mengenlehre im Terminal: Schnitt- und Differenzmengen filtern
Bevor wir mit den numerischen Optionen experimentieren, stellen wir sicher, dass wir uns im Testordner befinden:
cd ~/comm_lab
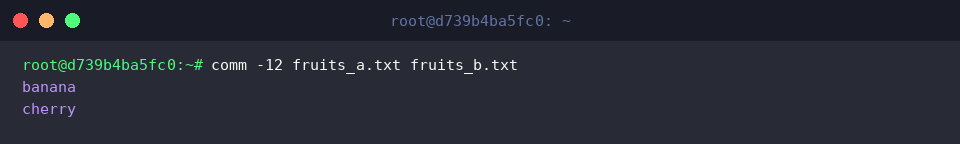
Indem wir die Optionen -1 und -2 kombinieren (comm -12), werden die ersten beiden Spalten ausgeblendet. Zurück bleibt ausschließlich die Schnittmenge – also Zeilen, die in beiden Textdateien vorkommen:
comm -12 fruits_a.txt fruits_b.txt
Als gemeinsame Schnittmenge liefert das Terminal banana sowie cherry.
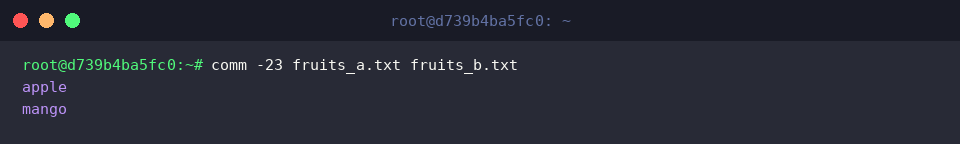
Möchten wir ermitteln, welche Datenpunkte exklusiv im ersten Dokument verblieben sind, maskieren wir Spalte 2 und Spalte 3 mittels comm -23:
comm -23 fruits_a.txt fruits_b.txt
Das Ergebnis filtert die Differenz heraus: apple und mango tauchen nur in fruits_a.txt auf.
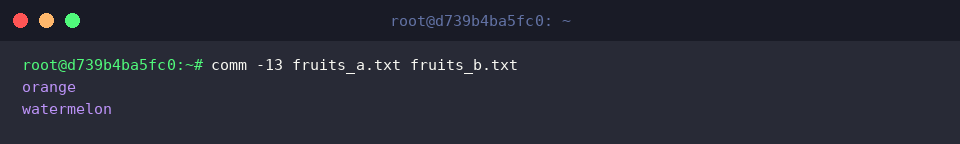
Umgekehrt lässt sich die Exklusivmenge der zweiten Datei ermitteln, indem Spalte 1 und 3 per -13 ignoriert werden:
comm -13 fruits_a.txt fruits_b.txt
Auf dem Bildschirm erscheinen somit nur orange und watermelon.
3. Unsortierte Datenströme abgleichen: Prozesssubstitution in der Bash
Wir vergewissern uns erneut des aktuellen Pfads:
cd ~/comm_lab
Da comm zwingend eine alphabetische Reihung voraussetzt, simulieren wir nun den Umgang mit unsortiertem Rohmaterial. Wir schreiben willkürlich angeordnete Werte in unsorted_a.txt:
printf "zebra\napple\ngrape\n" > unsorted_a.txt
Ebenso verfahren wir mit der Gegenseite unsorted_b.txt:
printf "apple\norange\nzebra\n" > unsorted_b.txt
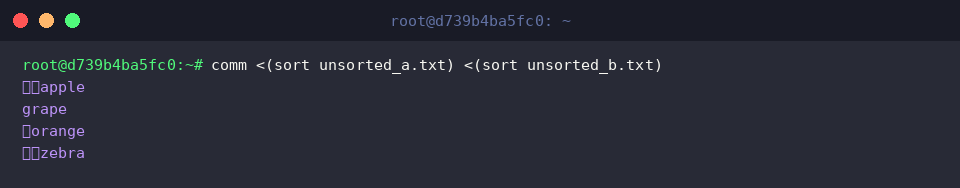
Anstatt permanente temporäre Zwischendateien auf der Festplatte anzulegen, greifen wir auf die Bash-Prozesssubstitution (<(...)) zurück. Diese leitet die sortierten Datenströme fliegend über Dateideskriptoren an comm weiter:
comm <(sort unsorted_a.txt) <(sort unsorted_b.txt)
Trotz unsortierter Quelldateien analysiert comm die Daten ohne Warnmeldungen: grape verbleibt in Spalte 1, orange in Spalte 2, während apple und zebra korrekt als Übereinstimmung in Spalte 3 landen.
Das Verfahren lässt sich nahtlos mit den Filterflags verknüpfen. Um rasch die gemeinsamen Werte zweier Rohdateien zu isolieren, koppeln wir Prozesssubstitution mit -12:
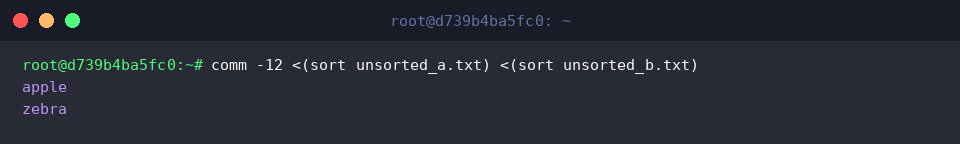
comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt)
Die gemeinsame Schnittmenge aus apple und zebra wird unverzüglich und ressourcenschonend auf stdout ausgegeben.
4. Paketlisten im Systemvergleich und Fallstricke bei Groß-/Kleinschreibung
Wir wechseln wieder in das Arbeitsverzeichnis:
cd ~/comm_lab
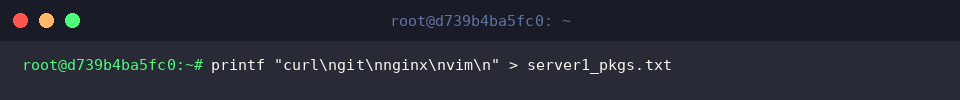
Ein typisches Sysadmin-Szenario ist der Konfigurationsdrift zwischen zwei Servern. Wir simulieren die Paketliste eines Quellknotens server1_pkgs.txt:
printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt
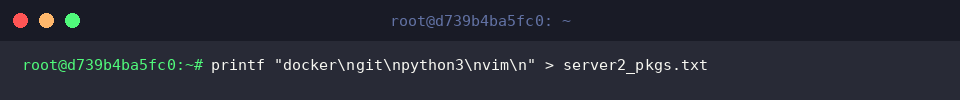
Auf dem Vergleichsserver server2_pkgs.txt liegen teilweise abweichende Pakete vor:
printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt
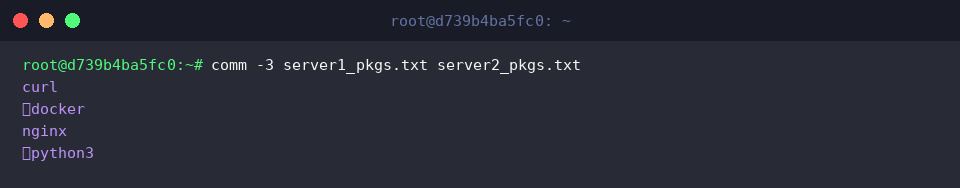
Um sofort zu sehen, worin sich beide Systeme voneinander unterscheiden, blenden wir die identischen Pakete mit -3 komplett aus:
comm -3 server1_pkgs.txt server2_pkgs.txt
Die gemeinsame Basis (git, vim) wird ausgefiltert; übrig bleiben nur die spezifischen Installationen: curl und nginx auf Server 1 gegenüber docker und python3 auf Server 2.
Ein wichtiger Aspekt bei Textvergleichen ist das Verhalten gegenüber Groß- und Kleinschreibung. Wir legen zwei Testdateien mit gemischter Schreibweise an:
printf "Apple\nBANANA\ncherry\n" > mixed_a.txt
printf "apple\nbanana\nCHERRY\n" > mixed_b.txt
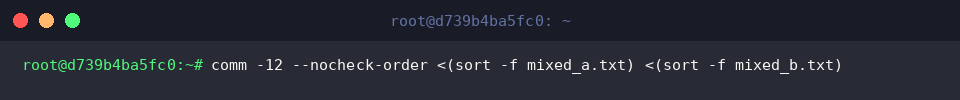
Sortieren wir beide Listen case-insensitiv via sort -f, müssen wir comm mit --nocheck-order anweisen, die strikte Byte-Sortierprüfung zu überspringen:
comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt)
Obwohl die Reihenfolge scheinbar übereinstimmt, liefert der Aufruf keinerlei Ausgabe. Der Grund: comm vergleicht Strings immer auf exakte Bytewerte (ASCII/UTF-8). Da Apple ungleich apple ist, existiert trotz passender Sortierung keine exakte Zeilenübereinstimmung.
Mit diesen Schritten beherrschen Sie die vielseitigen Einsatzmöglichkeiten des comm-Befehls. Ob zur schnellen Systemdiagnose, Logfile-Analyse oder in komplexen Shell-Pipelines: Durch das Zusammenspiel aus gezielter Spaltenunterdrückung und Prozesssubstitution steht Ihnen ein mächtiges Diagnosewerkzeug zur Verfügung.