


Einführung: Kontextbezogenes Zerlegen von Textdateien
Wer im Linux-Alltag umfangreiche Protokolldateien oder Datensätze aufteilen möchte, greift häufig zum Standardwerkzeug split. Sobald eine Zerlegung jedoch nicht stur nach Dateigröße oder Zeilenanzahl erfolgen soll, sondern anhand inhaltlicher Strukturen, stößt dieses Tool an seine Grenzen. Hier kommt das Dienstprogramm csplit (Context Split) ins Spiel: Es trennt Textdokumente hochpräzise auf Basis von Zeilennummern oder regulären Ausdrücken in handliche Abschnitte. In diesem Leitfaden betrachten wir die wichtigsten Einsatzszenarien direkt an praktischen Beispielen.
Textdateien anhand fester Zeilennummern aufteilen
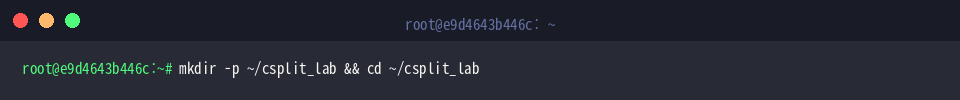
Für unsere Tests richten wir zunächst eine saubere Arbeitsumgebung ein. Mit folgendem Aufruf erstellen wir das Verzeichnis ~/csplit_lab und wechseln direkt hinein:
mkdir -p ~/csplit_lab && cd ~/csplit_lab
Anschließend erzeugen wir eine Beispieldatei mit 15 Datensätzen via seq -f "Line %g: System status normal" 1 15 > server_status.txt.
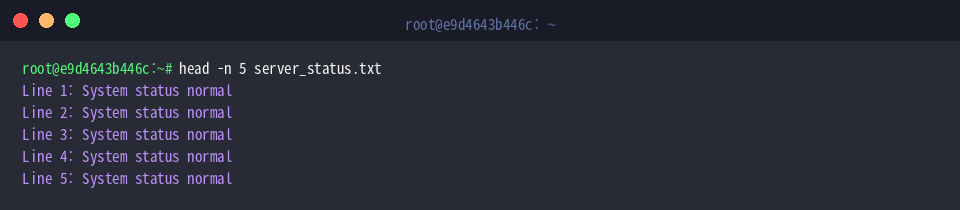
Ein kurzer Blick auf die ersten Zeilen bestätigt den Aufbau der soeben angelegten Datei:
head -n 5 server_status.txt
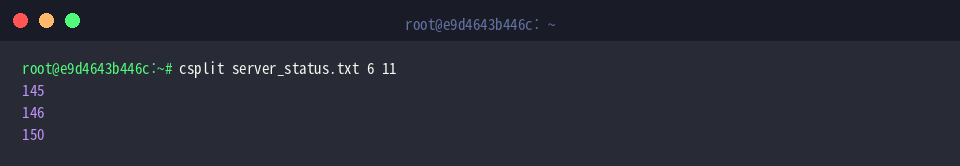
Das Dienstprogramm teilt Eingabedaten entlang definierter Markierungen auf. Führen wir beispielsweise csplit server_status.txt 6 11 aus, dienen Zeile 6 und Zeile 11 als Schnittpunkte. Die Quelldatei wird dadurch in drei Segmente aufgeteilt: Zeilen 1 bis 5, 6 bis 10 sowie 11 bis 15.
Die von csplit ausgegebenen Zahlenwerte spiegeln exakt die Dateigröße der generierten Fragmente in Bytes wider.
⚙️ [Zentrale Parameter]
-f PREFIX : Überschreibt das standardmäßige Dateinamenspräfix (xx) durch eine benutzerdefinierte Zeichenkette.-b FORMAT : Definiert das Nummerierungsformat der Zählsuffixe gemäß den printf-Spezifikationen.-n DIGITS : Bestimmt die Stellenanzahl des numerischen Zählers (Voreinstellung: 2).-s : Schaltet Statusausgaben stumm und unterdrückt die Anzeige der Dateigrößen im Terminal.-z : Verhindert die Generierung von leeren Ausgabedateien mit 0 Bytes.-k : Behält bereits geschriebene Teildateien im Fehlerfall auf der Festplatte, anstatt sie zu löschen.
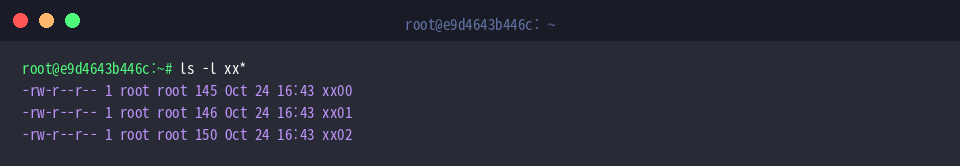
Prüfen wir die entstandenen Dateien mit ls -l xx*.
Das System hat standardmäßig drei Ausgabedateien (xx00, xx01, xx02) angelegt, deren Bytezahlen genau den zuvor gemeldeten Fragmentgrößen entsprechen:
Automatisches Segmentieren per regulärem Ausdruck
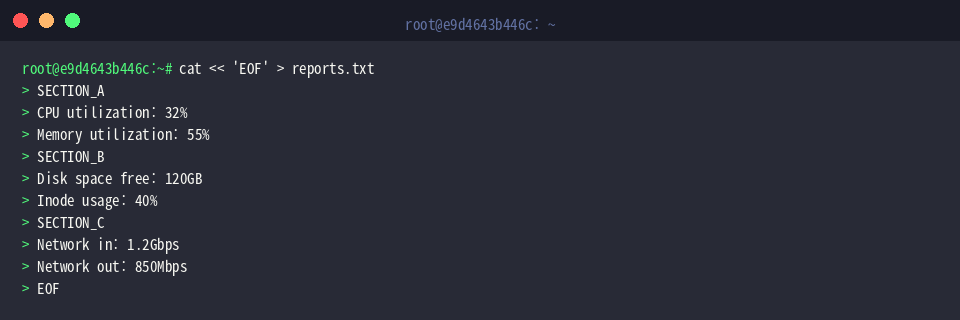
Besonders mächtig ist csplit, wenn Abschnitte anhand von Textmustern dynamisch erkannt werden sollen. Erzeugen wir dafür eine strukturierte Datei namens reports.txt:
cat << 'EOF' > reports.txt
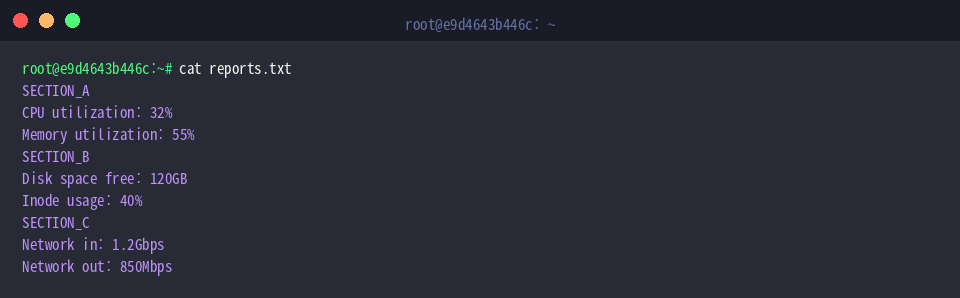
Überprüfen wir den Inhalt der Datei mit cat reports.txt.
Darin befinden sich drei voneinander getrennte Systemblöcke: SECTION_A, SECTION_B und SECTION_C.
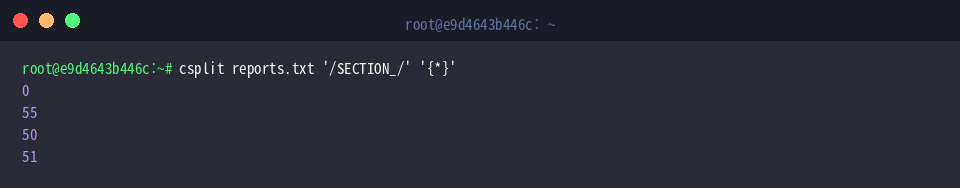
Um die Abschnitte automatisiert voneinander zu isolieren, führen wir csplit reports.txt '/SECTION_/' '{*}' aus.
Das Muster /SECTION_/ legt die Trennkante fest, während der Modifikator { * } das Tool anweist, diese Suche bis zum Dateiende beliebig oft zu wiederholen.
Auf der Konsole werden nacheinander die Bytegrößen sämtlicher Ausgabedateien aufgeführt – beginnend mit einem 0-Byte-Fragment für Daten, die eventuell vor dem allerersten Treffer lagen.
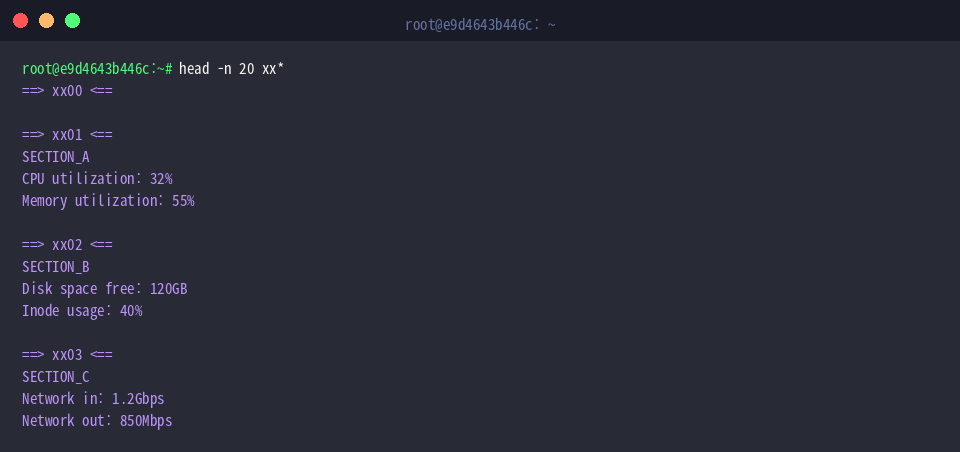
Werfen wir nun einen Blick in die erzeugten Fragmente:
head -n 20 xx*
Das Listing zeigt deutlich die Aufteilung: xx00 bleibt als Leerdatei vor dem ersten Treffer bestehen, während xx01, xx02 und xx03 jeweils die Datenblöcke der Abschnitte A, B und C enthalten.
Eigene Dateinamen: Präfixe und Ziffernlänge anpassen
Standardnamen wie xx00 sind in automatisierten Skripten oft unpraktisch. Bereiten wir eine Serverprotokolldatei vor, um benutzerdefinierte Namenskonventionen zu testen:
cat << 'EOF' > app.log
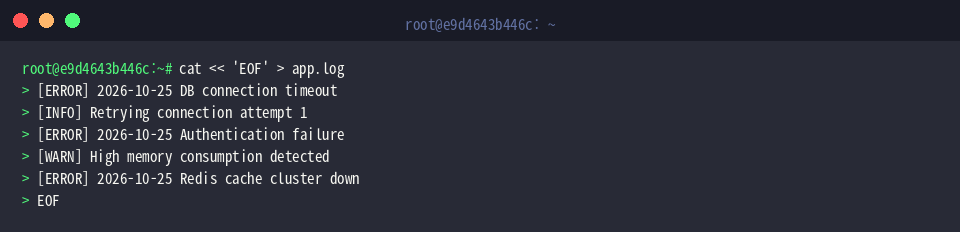
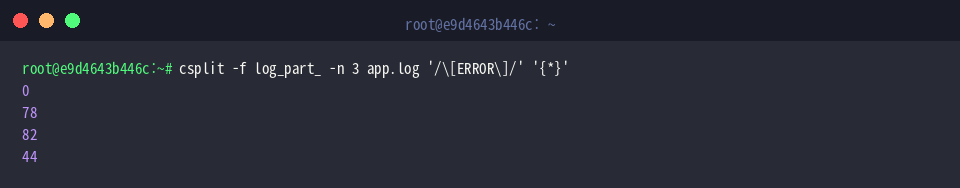
Mit dem Aufruf csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}' teilen wir die Logdatei an jeder Zeile mit dem Vermerk [ERROR].
Hierbei sorgt -f log_part_ für einen aussagekräftigen Dateinamenanfang, während -n 3 den Zähler auf dreistellige Nummern erweitert (z. B. 000, 001).
Die Ausgabe spiegelt wiederum die Dateigrößen in Bytes wider.
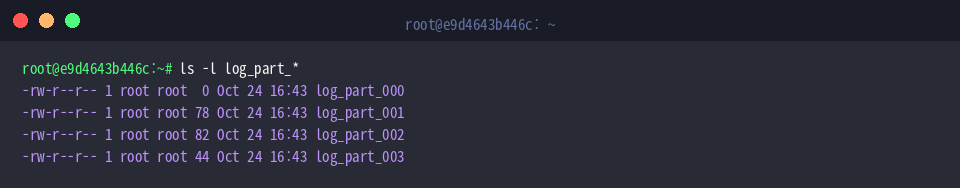
Eine Überprüfung via ls -l log_part_* bestätigt das gewünschte Namensschema:
Die Dateien heißen nun strukturiert log_part_000 bis log_part_003.
Saubere Workflows: Leere Dateien verhindern (-z) und Fehlertoleranz (-k)
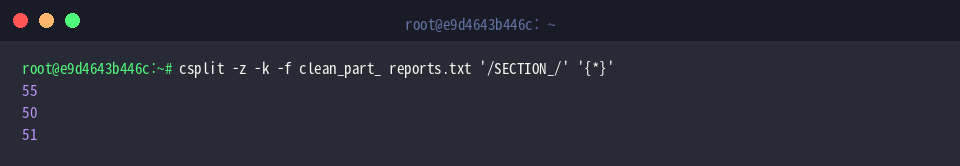
In Produktionsumgebungen möchte man überflüssige 0-Byte-Dateien im Vorfeld vermeiden und sicherstellen, dass bei Zwischenfällen keine Teilergebnisse verloren gehen. Der Befehl csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' kombiniert beide Anforderungen:
Dank -z entfällt das leere Fragment vor dem ersten Treffer, während -k garantiert, dass bereits geschriebene Segmente auch im Falle eines Abbruchs erhalten bleiben.
Folglich gibt das Programm nur noch die Größen der drei tatsächlich befüllten Dateien aus (55, 50 und 51 Bytes).
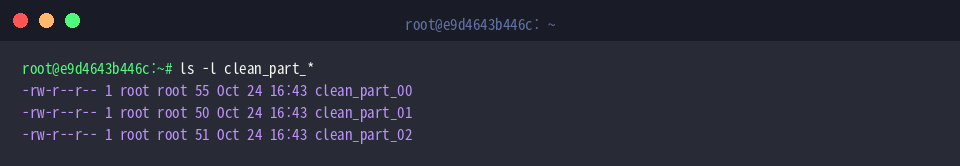
Ein Kontrollaufruf mit ls -l clean_part_* verdeutlicht den Unterschied zu vorherigen Durchläufen:
Statt vier Dateien existieren nur die drei relevanten Abschnitte clean_part_00 bis clean_part_02.
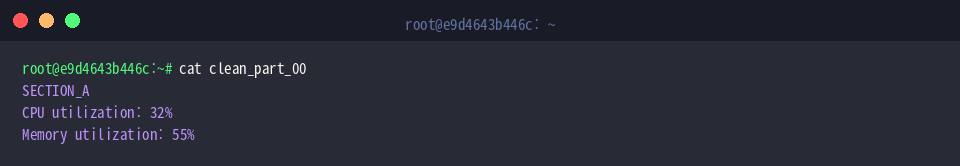
Dass keine Daten verloren gingen, belegen wir durch cat clean_part_00.
Die erste Teildatei startet direkt mit SECTION_A und beinhaltet sämtliche zugehörigen Messwerte.
Nach Abschluss aller Tests lässt sich das temporäre Laborverzeichnis mit folgendem Befehl rückstandslos entfernen:
rm -rf ~/csplit_lab
Damit haben Sie die wichtigsten Techniken kennengelernt, um strukturierte Text- und Logdateien unter Linux gezielt zu parsen. Dank regulärer Ausdrücke und praktischer Parameter wie -z und -f erweist sich csplit bei der automatisierten Log-Analyse als unverzichtbares Werkzeug für Systemadministratoren und DevOps-Engineers.