


Einführung in die strukturierte Textanalyse mit cut
Bei der täglichen Systemadministration unter Linux fallen regelmäßig strukturierte Datensätze oder umfangreiche Logdateien an, aus denen gezielt Informationen herausgefiltert werden müssen. Der Coreutils-Klassiker cut bietet hierfür eine unkomplizierte und performante Lösung. Dieser Leitfaden führt Sie durch praktische Szenarien unter Ubuntu und veranschaulicht, wie Sie Datensätze anhand von Trennzeichen, Spaltenindizes, Zeichenpositionen und Bytegrenzen zerlegen.
Vorbereitung der Testumgebung und Beispieldatensätze
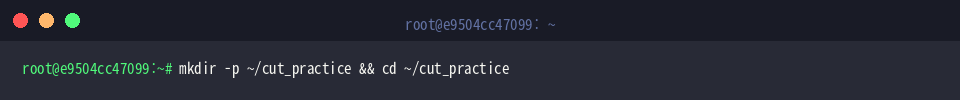
Zur sauberen Durchführung der Praxisschritte richten wir zunächst einen separaten Arbeitsordner ein. Mit dem Befehl mkdir -p ~/cut_practice && cd ~/cut_practice erstellen wir das Verzeichnis und betreten es umgehend.
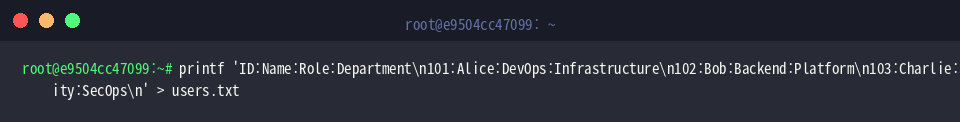
Für Demonstrationen mit doppelpunktgetrennten Werten (ähnlich dem Format von /etc/passwd) generieren wir via printf eine Testdatei namens users.txt.
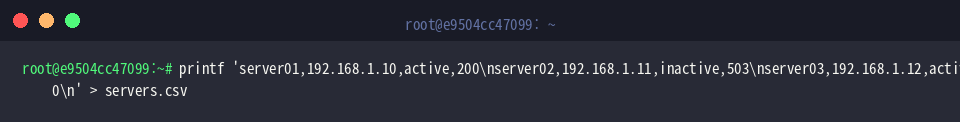
Klassische Tabellenstrukturen lassen sich hervorragend an CSV-Dateien testen. Über folgenden Befehl legen wir servers.csv an, um typische Servermetriken mit Kommas als Delimiter abzubilden.
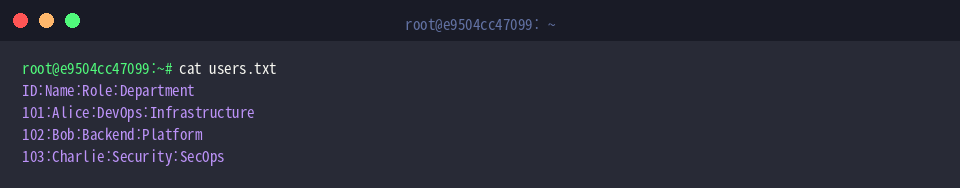
Mittels cat users.txt kontrollieren wir nun den strukturellen Aufbau und das Trennzeichenformat der soeben angelegten Benutzerdaten.
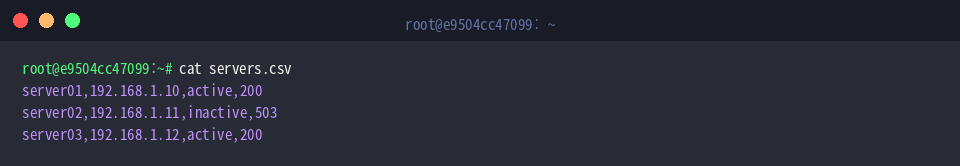
Analog validieren wir mit cat servers.csv, ob die Systemzustände und IP-Einträge fehlerfrei mit Kommas formatiert vorliegen.
Spalten gezielt isolieren via Delimiter (-d) und Feldauswahl (-f)
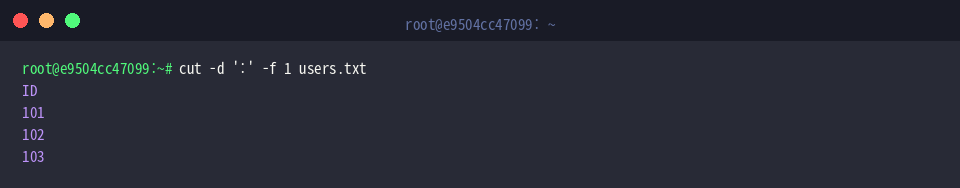
Soll aus users.txt lediglich der numerische Bezeichner herausgegriffen werden, instruieren wir das Dienstprogramm per cut -d ':' -f 1 users.txt. Das Argument -d ':' setzt den Doppelpunkt als Trennzeichen fest, während -f 1 exklusiv das erste Feld adressiert.
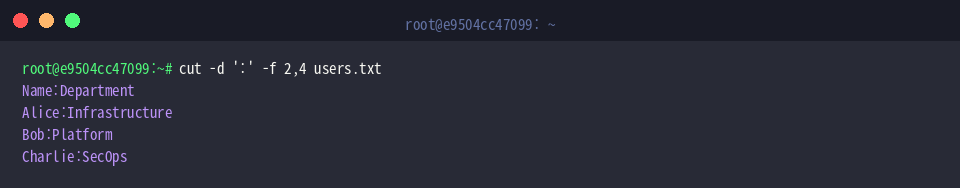
Zur Extraktion nicht zusammenhängender Attribute übergeben wir mehrere Indexnummern kommagetrennt. Der Aufruf cut -d ':' -f 2,4 users.txt filtert zeitgleich Benutzernamen und Abteilungszugehörigkeit heraus.
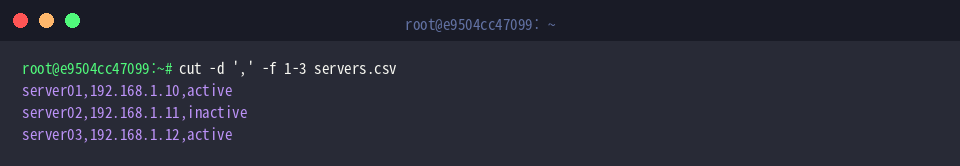
Fortlaufende Spaltenbereiche lassen sich mittels Bindestrich erfassen. Mit cut -d ',' -f 1-3 servers.csv greifen wir die Spalten 1 bis 3 aus der CSV-Datei ab, was Servername, IP-Adresse und Betriebszustand umfasst.
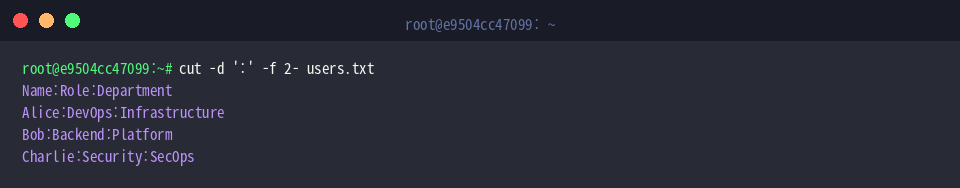
Möchte man alle Werte ab einer spezifischen Spalte bis zum jeweiligen Zeilenende ausgeben, lässt sich ein offener Bereich angeben. Das Kommando cut -d ':' -f 2- users.txt blendet die einleitende ID aus und liefert die restlichen Detailfelder.
Feste Positionsbereiche ausschneiden nach Zeichen (-c) und Bytes (-b)
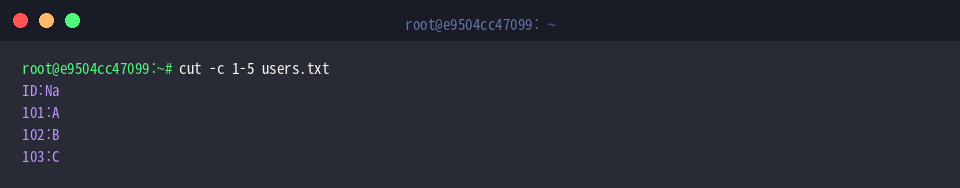
Arbeitet man mit formatierter Textausgabe ohne eindeutiges Trennzeichen, erlaubt -c das Schneiden nach Zeichenpositionen. Mit cut -c 1-5 users.txt extrahieren wir strikt die ersten fünf Zeichen jeder Textzeile.
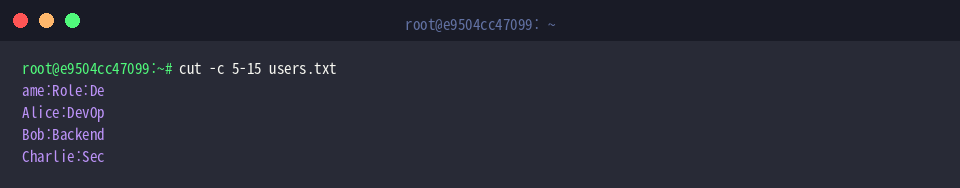
Positionsfilter können flexibel auf beliebige Abschnitte angewendet werden. Durch die Anweisung cut -c 5-15 users.txt wird das Textsegment zwischen Zeichen 5 und 15 isoliert dargestellt.
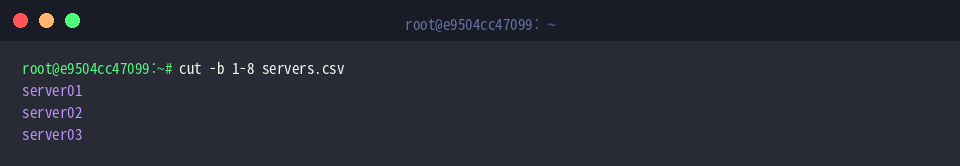
Wenn Datenströme anhand ihrer Bytegröße zerlegt werden sollen, kommt der Schalter -b zum Einsatz. Über cut -b 1-8 servers.csv erfassen wir die ersten 8 Bytes und erhalten so die Host-Kennung der Serverzeilen.
Erweiterte Techniken: Trennzeichen umformatieren und Felder invertieren
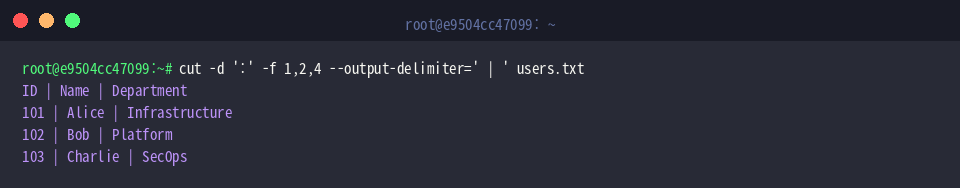
Um die Ausgabe übersichtlicher zu gestalten, lässt sich das Trennzeichen mit --output-delimiter modifizieren. Durch cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt ersetzen wir den ursprünglichen Doppelpunkt durch lesbare Pipe-Trenner.
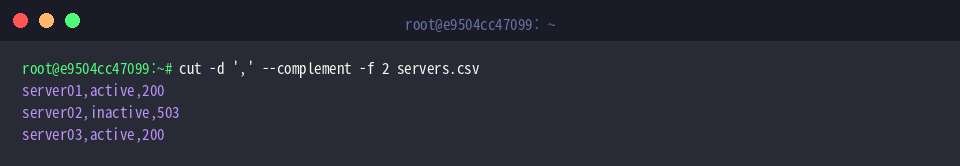
Soll eine spezifische Spalte bewusst verworfen werden, invertiert --complement die Filterlogik. Das Kommando cut -d ',' --complement -f 2 servers.csv schneidet die zweite Spalte heraus und belässt sämtliche restlichen Einträge (1, 3 und 4) in der Textausgabe.
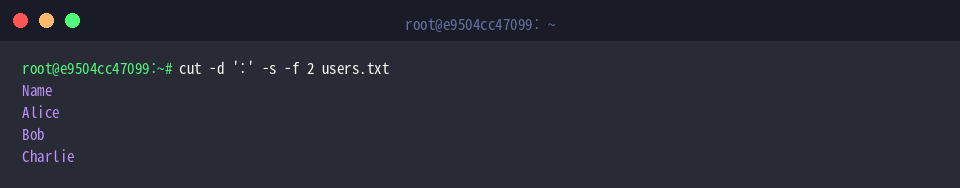
Zeilen, die das angegebene Trennzeichen überhaupt nicht enthalten, werden standardmäßig unberührt ausgegeben. Um diesen Effekt zu unterdrücken und unpassende Zeilen zu überspringen, kombiniert man den Filter mit -s (--only-delimited), wie in cut -d ':' -s -f 2 users.txt.
Mit diesen Kernoptionen steht Ihnen unter Ubuntu ein mächtiges Werkzeug zur Verfügung, um Parsing-Vorgänge in Shell-Skripten deutlich zu beschleunigen und Logdateien direkt auf der CLI effizient aufzubereiten.