


Introducción
Al escribir scripts de shell Bash en Linux, el comando read es esencial para manejar entradas interactivas del usuario y analizar datos de texto. Esta guía cubre todo lo necesario para dominarlo por completo: desde el procesamiento básico de entradas hasta el enmascaramiento de contraseñas (-s), tiempos de espera (-t), división por delimitadores (IFS) y el procesamiento línea por línea de archivos mediante bucles while, una de las técnicas más utilizadas en entornos de producción.
1. Fundamentos del comando read, prompt (-p) y configuración de valores predeterminados
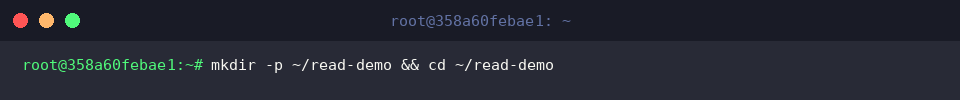
Para crear y acceder a un espacio de trabajo dedicado a las prácticas del comando read, ejecute el comando mkdir -p ~/read-demo && cd ~/read-demo.
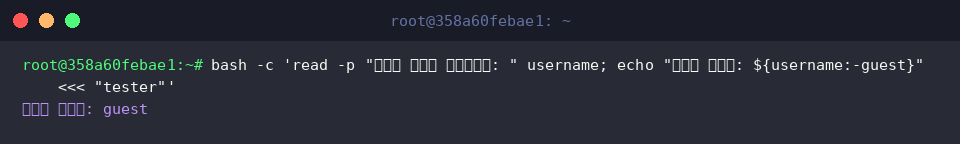
El comando read lee una línea desde la entrada estándar y la almacena en una variable. Con la opción -p se puede mostrar un mensaje indicador (prompt) al usuario, y con la sintaxis ${nombre_variable:-valor_predeterminado} es posible asignar un valor por defecto si la variable está vacía.
En el resultado de la ejecución, al no enviarse ninguna entrada directa al comando read, la variable username permaneció vacía y se mostró el valor predeterminado guest de acuerdo con la sintaxis ${username:-guest}.
⚙️ [Opciones principales]
-p : Especifica la cadena de texto del prompt que se mostrará en pantalla antes de recibir la entrada.-s : Activa el modo silencioso/secreto, ocultando los caracteres ingresados en la pantalla al recibir datos sensibles como contraseñas.-t : Establece un tiempo límite de espera (en segundos); la entrada finaliza si transcurre dicho tiempo.-n : Limita la entrada al número de caracteres especificado y finaliza de inmediato sin necesidad de presionar la tecla Enter.-r : Trata las barras invertidas (\) como caracteres literales sin interpretarlas como caracteres de escape.-a : Divide las palabras ingresadas tomando los espacios como referencia y las almacena secuencialmente en una variable de tipo arreglo (array).-d : Especifica un carácter delimitador personalizado para finalizar la entrada en lugar del salto de línea.
2. Enmascaramiento de contraseñas (-s) y control de tiempo de espera (-t)
Para continuar con la práctica, ejecute el comando cd ~/read-demo para ingresar al directorio ~/read-demo creado previamente.
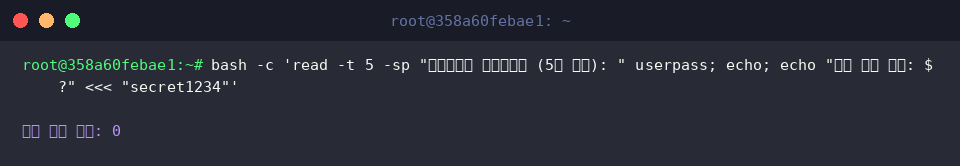
Se recibe la entrada enmascarando los caracteres en pantalla con la opción -s y aplicando un tiempo límite de 5 segundos con la opción -t 5.
Dado que la contraseña se ingresó correctamente dentro del tiempo límite, el código de salida ($?) devolvió 0.
3. Uso de delimitadores (IFS) y la opción -a para asignación múltiple y arreglos
Para continuar con la práctica, ejecute el comando cd ~/read-demo para ingresar al directorio ~/read-demo creado previamente.
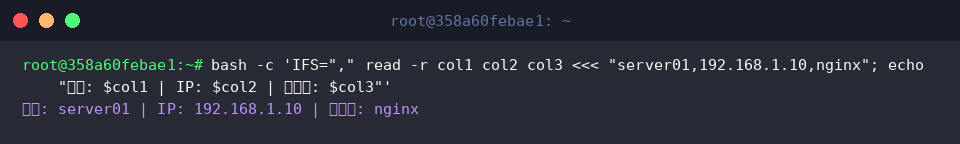
Al definir el separador de campos interno (IFS) como una coma (,), el comando read procesa una cadena en formato CSV suministrada mediante Here-String (<<<) y la divide almacenando los datos en las variables col1, col2 y col3.
En el resultado de la ejecución, el nombre del servidor, la dirección IP y el nombre del servicio incluidos en la cadena se distribuyeron y mostraron correctamente en cada variable según el delimitador especificado.
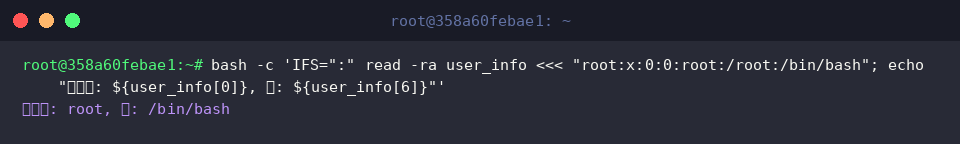
Al configurar el delimitador (IFS) con dos puntos (:) y utilizar la opción -a, se divide una cadena con formato /etc/passwd y se almacena en el arreglo user_info.
El índice 0 del arreglo, correspondiente al nombre de la cuenta (root), y el índice 6, correspondiente a la ruta del shell de inicio de sesión (/bin/bash), se extrajeron y mostraron adecuadamente.
4. Clave práctica: procesamiento de archivos grandes línea por línea con bucles while y read -r
Para continuar con la práctica, ejecute el comando cd ~/read-demo para ingresar al directorio ~/read-demo creado previamente.
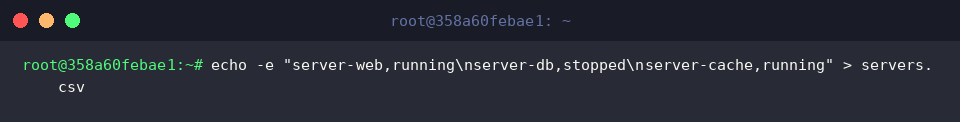
Para la práctica de procesamiento línea por línea, cree el archivo de muestra servers.csv, el cual contiene nombres de servidores y sus estados de ejecución separados por comas.
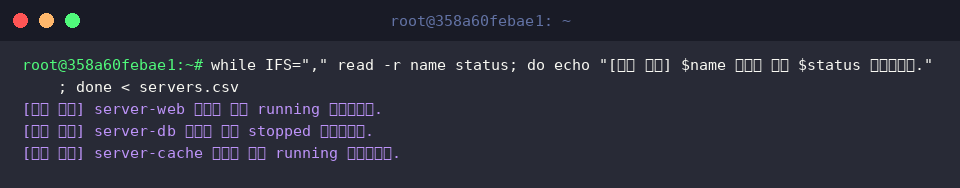
Al combinar un bucle while con el comando read -r y definir el separador interno (IFS) como una coma (,), se lee de forma segura cada línea del archivo servers.csv.
Como resultado, el nombre y la información de estado de cada servidor registrados en el archivo se asignaron de forma correcta a las variables name y status, imprimiéndose según el formato establecido.
Hasta aquí hemos revisado desde el uso básico del comando read en scripts de shell de Linux hasta técnicas prácticas esenciales como la lectura de archivos línea por línea.
Le recomendamos poner en práctica las diversas opciones y ejemplos presentados para desarrollar scripts de automatización interactivos adaptados a sus necesidades.