


Introducción
En entornos Linux, el comando grep es una herramienta imprescindible para analizar archivos de texto de gran tamaño o logs del sistema. En este artículo, exploraremos las técnicas esenciales en la terminal de Ubuntu para ejecutar grep, localizar rápidamente las cadenas deseadas e interpretar con precisión los resultados obtenidos en situaciones reales de trabajo.
Búsqueda básica de cadenas y opción para ignorar mayúsculas/minúsculas (-i)
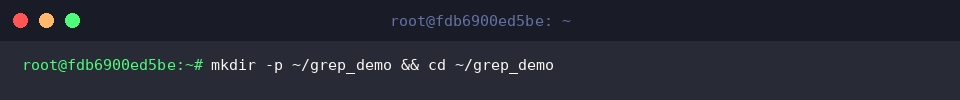
Para crear y acceder a un espacio de trabajo aislado destinado a la práctica del comando grep, ejecutamos el comando mkdir -p ~/grep_demo && cd ~/grep_demo.
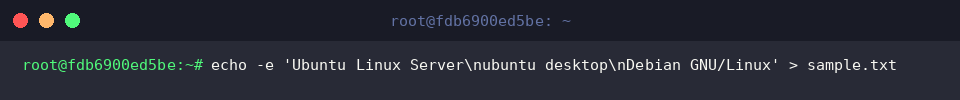
Para generar un archivo de texto con cadenas de ejemplo que utilizaremos en las pruebas de búsqueda, ejecutamos el comando echo -e 'Ubuntu Linux Server\nubuntu desktop\nDebian GNU/Linux' > sample.txt.
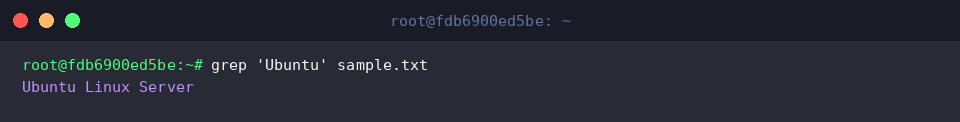
El comando grep busca patrones o cadenas específicas dentro de archivos o texto y muestra las líneas que coinciden.
De forma predeterminada, distingue estrictamente entre mayúsculas y minúsculas, por lo que solo se encontrarán las líneas que contengan exactamente Ubuntu.
⚙️ [Opciones principales]
-i : Ignora la distinción entre mayúsculas y minúsculas al buscar el patrón coincidente.-v : Invierte la búsqueda mostrando únicamente las líneas que no coinciden con el patrón especificado.-n : Muestra junto con el resultado el número de línea donde se encuentra la coincidencia.-c : Cuenta e imprime únicamente el número total de líneas coincidentes.-r : Busca de manera recursiva en todos los archivos dentro de los subdirectorios.-l : Lista únicamente los nombres de los archivos que contienen coincidencias.-E : Realiza la búsqueda utilizando expresiones regulares extendidas (ERE).
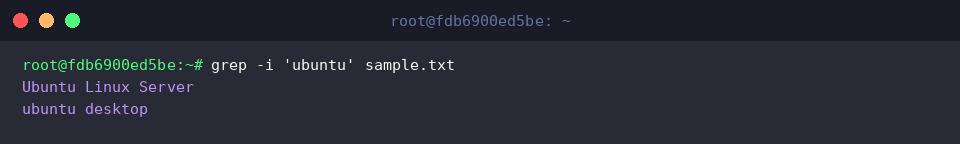
Al agregar la opción -i, la búsqueda no distingue entre mayúsculas y minúsculas.
Por lo tanto, se mostrarán tanto las líneas que contienen Ubuntu con mayúscula inicial como aquellas con ubuntu en minúsculas.
Mostrar números de línea (-n) e invertir la coincidencia (-v)
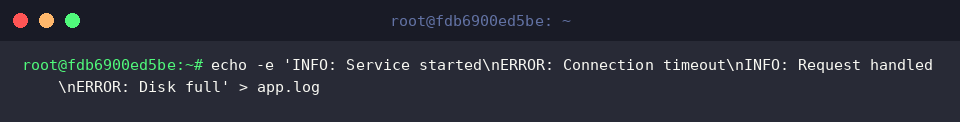
Para generar datos de logs simulados que usaremos en la práctica de análisis de logs, ejecutamos el comando echo -e 'INFO: Service started\nERROR: Connection timeout\nINFO: Request handled\nERROR: Disk full' > app.log.
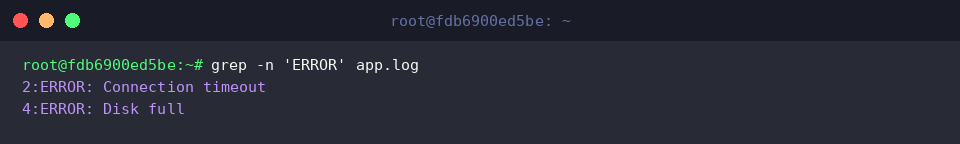
Al utilizar la opción -n, se muestra el número de línea correspondiente junto con las líneas que coinciden con el patrón buscado.
Esto permite ver tanto el contenido como el número de línea donde aparece la cadena ERROR, facilitando la identificación rápida del lugar donde ocurrió el problema.
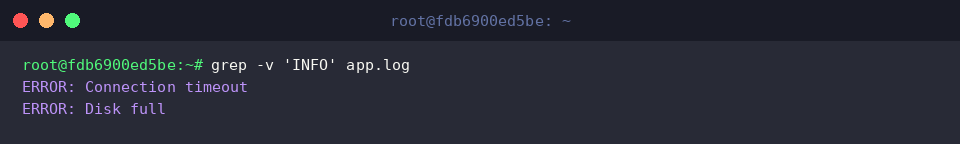
Al utilizar la opción -v, se invierte la búsqueda para mostrar únicamente las líneas que no coinciden con el patrón indicado.
Esto permite filtrar y revisar únicamente las líneas relacionadas con errores, excluyendo las entradas INFO que representan un estado normal.
Búsqueda recursiva en subdirectorios (-r) y mostrar solo nombres de archivo (-l)
Para preparar la práctica de búsqueda recursiva, creamos una estructura de subdirectorios de almacenamiento ejecutando el comando mkdir -p ~/grep_demo/logs/archive.
Para generar un archivo de log de error de base de datos para la prueba, ejecutamos el comando echo 'database error' > ~/grep_demo/logs/db.log.
Para generar un archivo de log de caché que representa operaciones normales, ejecutamos el comando echo 'cache hit' > ~/grep_demo/logs/cache.log.
Para probar la exploración en subdirectorios creando un log de errores antiguos, ejecutamos el comando echo 'fatal error occurred' > ~/grep_demo/logs/archive/old.log.
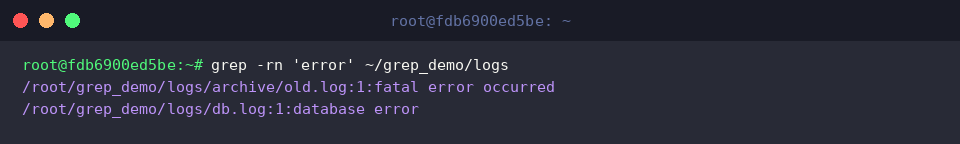
Al combinar las opciones -r y -n, la búsqueda desciende recursivamente por los subdirectorios y muestra los números de línea junto con las coincidencias encontradas.
Se mostrarán las rutas de los archivos, los números de línea y el contenido correspondiente a la cadena error en los archivos situados tanto en el directorio logs como en el subdirectorio archive.
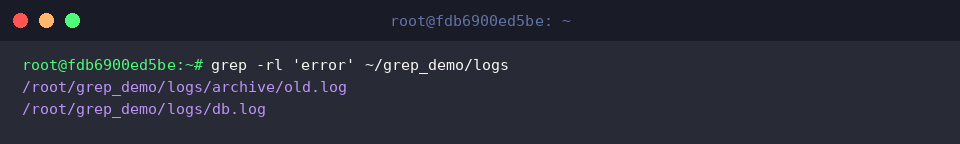
Si añadimos la opción -l y ejecutamos el comando como -rl, en lugar de mostrar las líneas coincidentes, se imprimirá únicamente la lista de rutas de los archivos que contienen el patrón.
Esto resulta muy útil para identificar de forma rápida qué archivos presentan un error entre una gran cantidad de archivos de registro.
Visualización del contexto circundante (-A, -B, -C) y resaltado en color
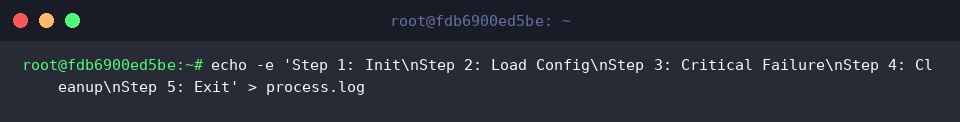
Para practicar el seguimiento del progreso de un proceso paso a paso y la revisión del contexto de un error, generamos un archivo de log de muestra ejecutando el comando echo -e 'Step 1: Init\nStep 2: Load Config\nStep 3: Critical Failure\nStep 4: Cleanup\nStep 5: Exit' > process.log.
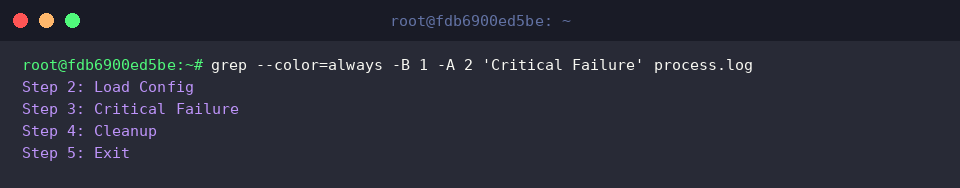
Al usar las opciones -B y -A, se muestran junto con la coincidencia un número determinado de líneas anteriores (Before) y posteriores (After).
Con la opción --color=always se resalta en color la frase coincidente Critical Failure, permitiendo observar 1 línea previa y 2 líneas posteriores para comprender el flujo de trabajo antes y después de que ocurra el fallo.
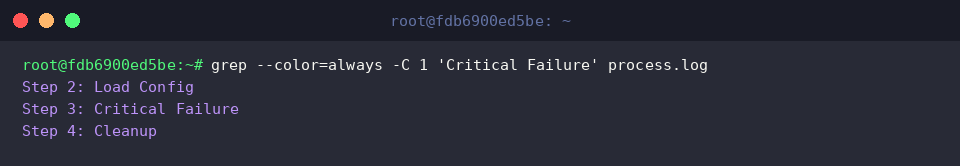
Al usar la opción -C, se imprime de una sola vez la misma cantidad de líneas tanto antes como después de la coincidencia (Context).
Al mostrarse simultáneamente 1 línea inmediatamente anterior y 1 línea posterior a la línea que contiene Critical Failure, se puede examinar el contexto esencial de forma mucho más concisa.
Hasta aquí hemos revisado los aspectos esenciales del comando grep en Ubuntu, desde sus opciones básicas de búsqueda hasta su aplicación práctica en el análisis de logs.
Le recomendamos aplicar activamente estos patrones en su trabajo diario en la terminal para elevar su productividad al siguiente nivel.