


Introducción
En entornos Linux, awk es la herramienta más potente para procesar y filtrar de forma eficiente grandes archivos de texto o datos de registro (logs). Descubra la sintaxis esencial y las aplicaciones prácticas que le permitirán extraer columnas específicas, aplicar filtros condicionales e incluso sumar datos con una sola línea de comandos, sin necesidad de escribir scripts complejos.
1. Principio básico de funcionamiento de awk y extracción de columnas específicas
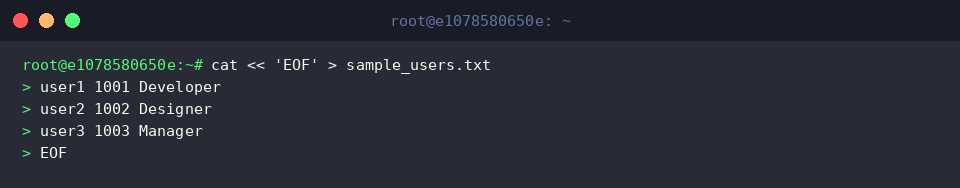
Para practicar con el comando awk, creamos un archivo de texto de ejemplo con nombres de usuario, ID e información laboral separados por espacios.
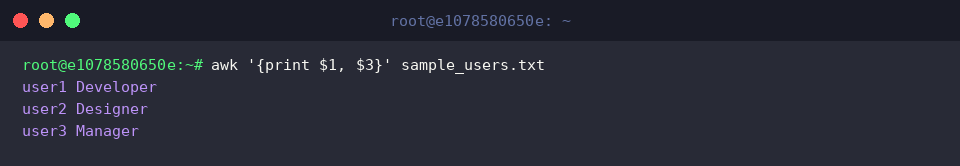
Utilizando el comando awk, extraemos e imprimimos de cada línea del archivo el primer campo ($1), correspondiente al nombre de usuario, y el tercer campo ($3), correspondiente al puesto de trabajo, usando el espacio como separador.
Por defecto, si no se especifica un delimitador, awk divide los campos basándose en espacios en blanco o tabulaciones continuas.
⚙️ [Opciones principales]
-F fs : Especifica el separador de campos de entrada (Field Separator).-v var=val : Asigna una variable y su valor inicial para usar dentro del script awk antes de su ejecución.-f progfile : Especifica la ruta del archivo que contiene el código del script awk a ejecutar.
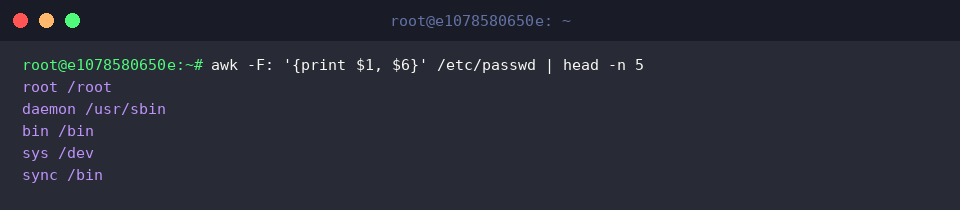
En el archivo /etc/passwd, cuyos campos están delimitados por dos puntos (:), especificamos el delimitador con la opción -F: y extraemos únicamente el primer campo ($1), correspondiente al nombre de la cuenta, y el sexto campo ($6), correspondiente a la ruta del directorio personal (home), para revisar las primeras 5 líneas.
2. Filtrado de datos personalizado mediante condicionales y operadores
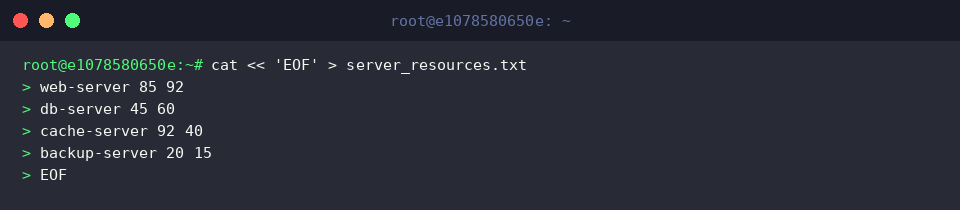
Creamos el archivo de práctica server_resources.txt, que contiene datos sobre el uso de CPU y memoria de diferentes servidores.
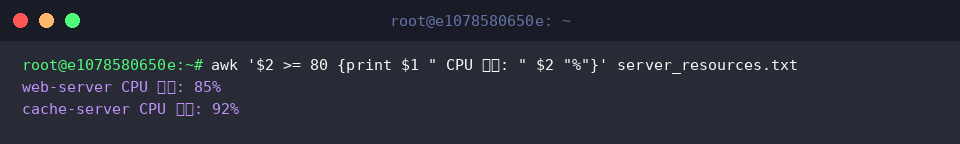
Filtramos mediante una expresión condicional aquellos casos donde el segundo campo ($2), correspondiente al uso de CPU, sea igual o superior al 80%, e imprimimos el nombre del servidor junto con un mensaje de advertencia.
Esta técnica resulta muy útil para identificar recursos del sistema que han superado un umbral crítico.
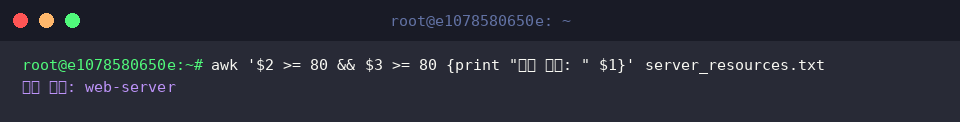
Utilizamos el operador lógico AND (&&) para filtrar e imprimir los servidores en estado crítico cuyo uso tanto de CPU ($2) como de memoria ($3) sea igual o superior al 80%.
La aplicación de condiciones compuestas permite aislar únicamente aquellos objetivos donde múltiples recursos han superado el umbral simultáneamente.
3. Estadísticas y sumas con variables integradas y bloques BEGIN/END
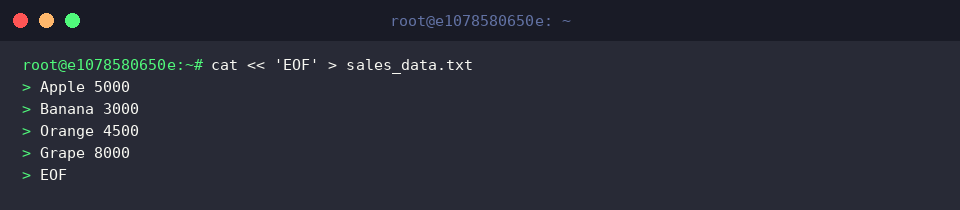
Para realizar prácticas de agregación y cálculo estadístico con awk, creamos el archivo de ejemplo sales_data.txt, que incluye nombres de artículos y montos de ventas.
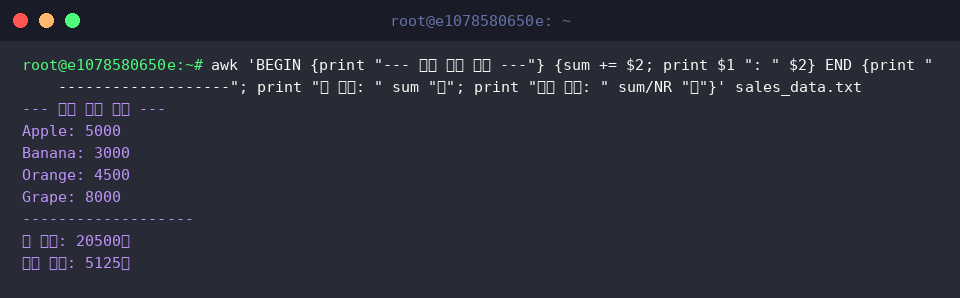
Con el bloque BEGIN, imprimimos un mensaje de inicio antes de procesar el cuerpo del archivo y acumulamos el valor del segundo campo ($2) de cada línea en la variable sum.
Una vez finalizado el procesamiento de todas las líneas del archivo, se ejecuta el bloque END, donde se calculan e imprimen las ventas totales y el promedio de ventas utilizando la variable interna NR (número total de registros).
4. Análisis práctico de registros de servidor web y filtrado de tráfico anómalo
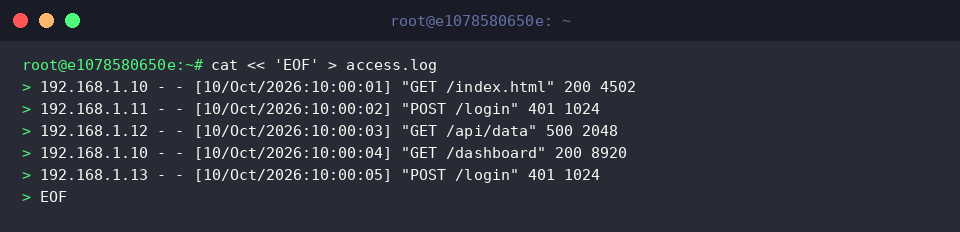
Para realizar prácticas de análisis de logs de servidor web y seguimiento de errores, creamos un archivo de registro de ejemplo access.log en formato estándar de Nginx y Apache.
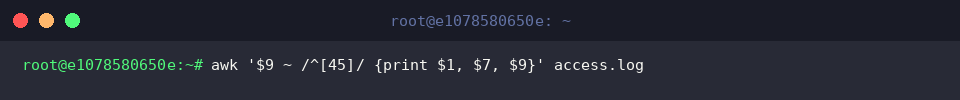
Utilizando el operador de coincidencia de expresiones regulares (~), filtramos las líneas correspondientes a errores de cliente 4xx y errores de servidor 5xx, identificando si el noveno campo ($9), que representa el código de estado HTTP, comienza con 4 o 5.
Al extraer únicamente la IP de conexión ($1), el URI solicitado ($7) y el código de estado ($9) de los registros coincidentes, es posible verificar con rapidez incidentes y patrones de tráfico anómalo.
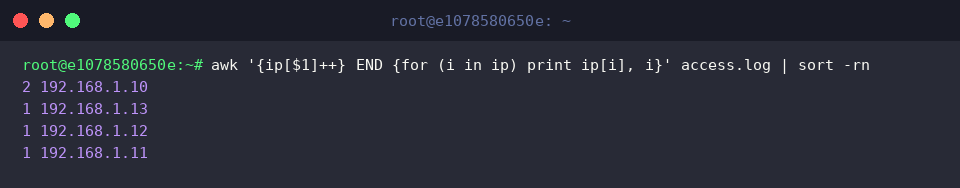
Aprovechando los arreglos asociativos de awk (ip[$1]++), contabilizamos el número de solicitudes por cada IP de origen; luego, mediante un bucle en el bloque END, imprimimos el total acumulado y utilizamos la canalización con sort -rn para ordenar los resultados de mayor a menor frecuencia.
Esta es una técnica habitual de análisis en entornos reales para identificar tráfico excesivo o intentos de acceso no autorizados provenientes de una IP específica.
Hasta aquí hemos revisado la sintaxis básica y los ejemplos prácticos esenciales del comando awk, una herramienta indispensable para resolver con facilidad tareas de procesamiento de texto y análisis masivo de logs en entornos Linux.
Aplique directamente en su trabajo cotidiano las distintas opciones y patrones presentados hoy para automatizar de manera mucho más eficiente la extracción y manipulación repetitiva de datos.