


Introducción
Quedarse sin almacenamiento disponible en un entorno de producción puede paralizar servicios críticos en cuestión de segundos. En esas situaciones de emergencia, localizar con exactitud qué carpetas o ficheros están devorando los bloques del sistema de archivos resulta indispensable. Lejos de repasar fríamente la documentación oficial del manual, este artículo propone un enfoque directo y práctico: aprenderemos a exprimir el comando du mediante ejemplos reales que resuelven los problemas habituales de almacenamiento en servidores Linux.
1. Configuración del entorno de pruebas y sintaxis esencial de du
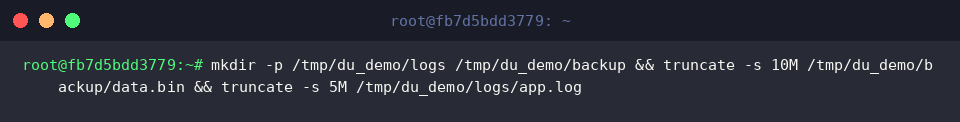
Para experimentar de forma segura sin comprometer datos reales, comenzamos preparando una estructura de directorios poblada con archivos ficticios de tamaño controlado mediante mkdir -p /tmp/du_demo/logs /tmp/du_demo/backup && truncate -s 10M /tmp/du_demo/backup/data.bin && truncate -s 5M /tmp/du_demo/logs/app.log.
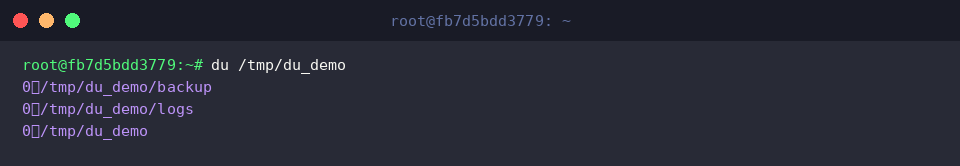
La utilidad du (disk usage) inspecciona el espacio asignado a directorios y sus contenidos recursivos, expresando por omisión las cifras en bloques de 1024 bytes.
Al invocarse sin modificadores, despliega la lista jerárquica de carpetas junto con su respectiva huella de almacenamiento numérico bruto.
⚙️ [Parámetros fundamentales]
-h : Convierte los valores crudos a unidades legibles para las personas (K, M, G).-a : Computa y muestra ficheros individuales, no solo estructuras de directorio.-s : Condensa el cómputo total en una sola línea sin desglosar el árbol interior.-d : Delimita la profundidad jerárquica de exploración de carpetas.-c : Agrega un renglón final con la sumatoria global calculada.-b : Presenta la longitud real en bytes (tamaño aparente) en vez del consumo en bloques de disco.
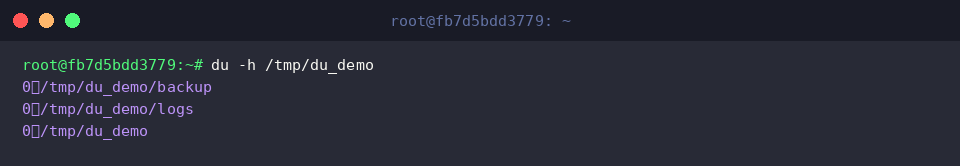
Al incorporar el modificador -h (--human-readable), los bloques de almacenamiento se transforman automáticamente en múltiplos comprensibles como KiB, MiB o GiB.
Este ajuste visual agiliza enormemente el diagnóstico preliminar al evitar tener que interpretar cifras kilométricas de bloques de memoria.
2. Delimitación de niveles jerárquicos y consolidación de totales (-d, -s, -c)
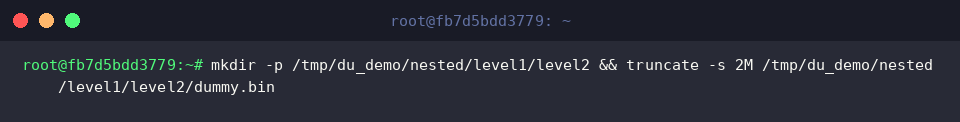
Para evaluar cómo restringir la recursividad en árboles de directorios profundos, creamos varias capas anidadas ejecutando mkdir -p /tmp/du_demo/nested/level1/level2 && truncate -s 2M /tmp/du_demo/nested/level1/level2/dummy.bin.
El parámetro -d 1 (--max-depth=1) restringe el análisis estrictamente al primer nivel de carpetas inmediatas bajo la ruta indicada.
Esta restricción es perfecta para evitar que la terminal se inunde con cientos de subdirectorios irrelevantes, permitiendo evaluar el peso de cada división principal al instante.
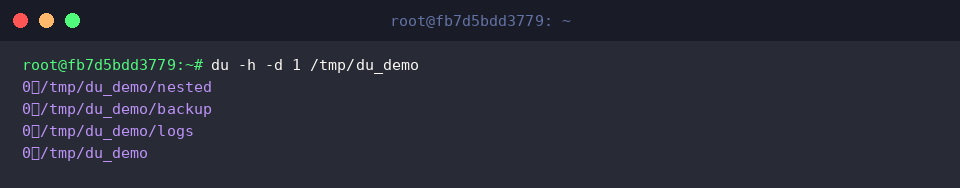
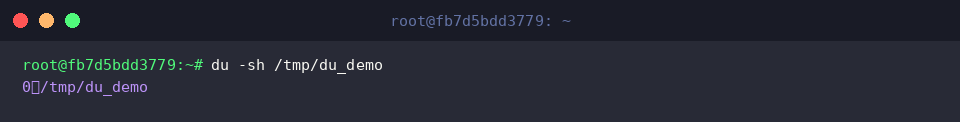
Cuando solo se requiere conocer la ocupación global sin entrar en detalles de sus subelementos, la opción -s (--summarize) comprime todo el cálculo a una única fila resumen.
Al combinarlo con -h, obtenemos una visualización inmediata y limpia del peso total acumulado por el directorio evaluado.
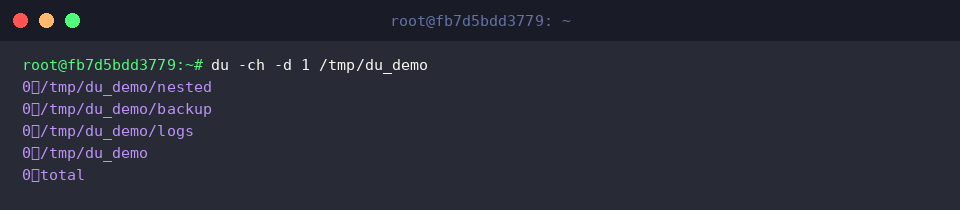
Añadir el flag -c (--total) añade un balance global al final del listado bajo la etiqueta total.
Resulta sumamente práctico cuando deseamos examinar el desglose por componente y al mismo tiempo verificar el cómputo consolidado de todo el lote.
3. Inspección detallada de archivos y omisión selectiva (-a, –exclude)
Con el fin de simular filtros sobre extensiones transitorias o de depuración, generamos un par de archivos residuales ejecutando touch /tmp/du_demo/temp1.tmp /tmp/du_demo/temp2.tmp.
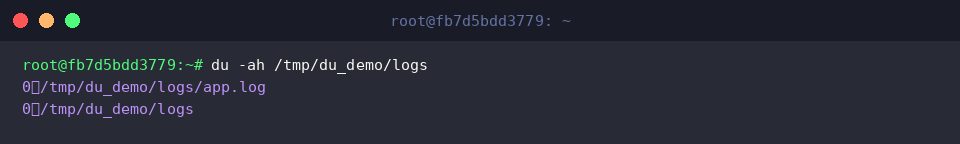
De forma predeterminada, du ignora los ficheros individuales y solo lista carpetas; no obstante, el argumento -a (--all) fuerza el reporte de cada archivo presente en la jerarquía.
Combinado con -h, este ajuste facilita una radiografía pormenorizada del peso exacto de cada archivo ubicado, por ejemplo, dentro de /tmp/du_demo/logs.
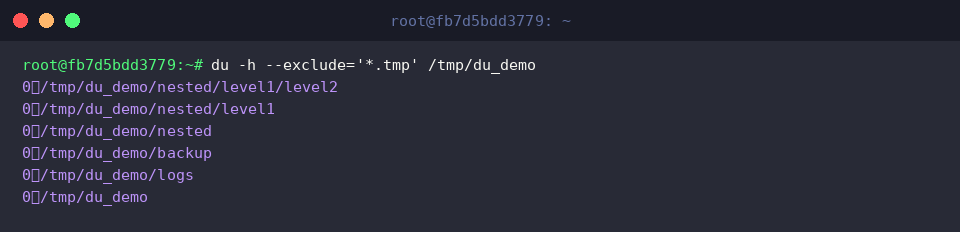
La directiva --exclude descarta del cómputo aquellos patrones o extensiones que no nos interesa auditar.
Por ejemplo, indicando --exclude='*.tmp' le ordenamos al motor de búsqueda que ignore por completo los archivos temporales (.tmp), reportando únicamente el uso atribuible a datos definitivos.
4. Escenarios avanzados en producción: ordenamiento jerárquico y detección de cuellos de botella
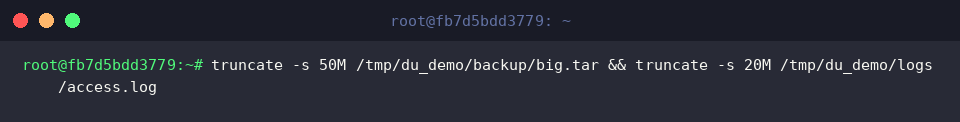
Para ilustrar una búsqueda forense de archivos gigantescos que saturan particiones, creamos un par de archivos pesados adicionales ejecutando truncate -s 50M /tmp/du_demo/backup/big.tar && truncate -s 20M /tmp/du_demo/logs/access.log.
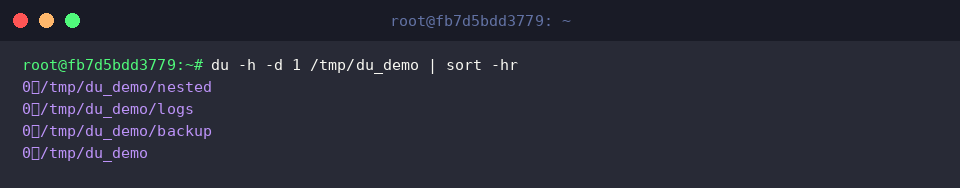
Canalizando la salida de du -h -d 1 /tmp/du_demo hacia sort -hr mediante una tubería (|), organizamos las carpetas de primer nivel en orden descendente según su volumen real.
Este flujo de trabajo revela en milisegundos qué sector del sistema de archivos está concentrando la mayor proporción de espacio consumido.
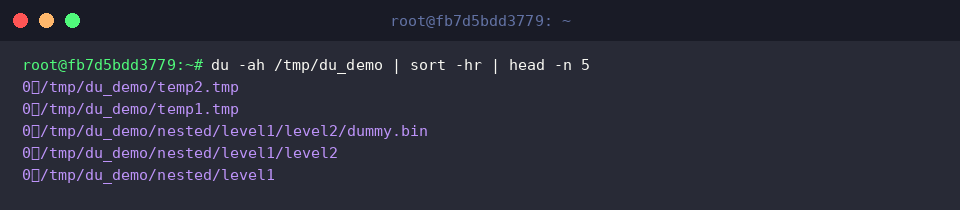
Si ampliamos el alcance combinando du -ah /tmp/du_demo, encadenamos el resultado con sort -hr y acotamos la visualización a los primeros hallazgos mediante head -n 5, aislaremos los 5 archivos o directorios más masivos de la ruta.
Esta canalización es el recurso estándar de todo administrador de sistemas a la hora de cazar culpables ante una alerta crítica de almacenamiento.
Una vez completadas las pruebas, conviene purgar el árbol de trabajo temporal ejecutando rm -rf /tmp/du_demo para mantener limpio el entorno de almacenamiento.
Con este recorrido táctico hemos explorado los modificadores clave y las cadenas de comandos más potentes asociadas a du en servidores Linux.
Integrar estas combinaciones en tus tareas habituales de mantenimiento garantizará una administración preventiva y certera de tus particiones de almacenamiento.