


Introducción
En servidores Linux en producción, comprimir registros históricos con bzip2 representa un método habitual para optimizar el almacenamiento; sin embargo, descomprimir ficheros voluminosos cada vez que surge un incidente resulta ineficiente y desgasta recursos de E/S. La herramienta de terminal bzgrep suprime este cuello de botella, posibilitando el filtrado inmediato de cadenas de texto directamente dentro de archivos comprimidos .bz2. En este tutorial analizaremos desde el aprovisionamiento de un entorno de pruebas hasta el escaneo sin distinción de mayúsculas, la visualización de líneas y la búsqueda combinada entre múltiples contenedores comprimidos.
1. Preparación del entorno y generación de muestras con bzip2
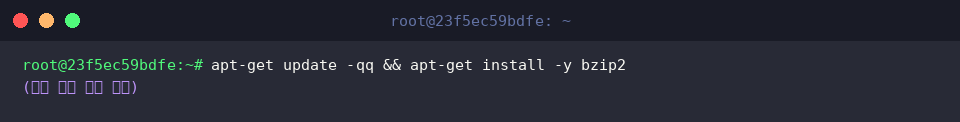
Para disponer de las utilidades de gestión y descompresión al vuelo en Debian/Ubuntu, iniciamos el aprovisionamiento del paquete bzip2 mediante apt-get update -qq && apt-get install -y bzip2.
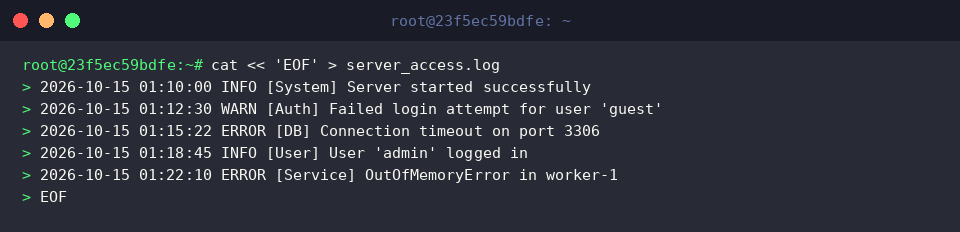
A continuación, creamos una estructura de eventos ficticios simulando un registro de servidor web denominado server_access.log ejecutando una redirección con cat.
Con el fin de empaquetar el log sin eliminar la fuente original de texto, recurrimos al modificador -k invocando bzip2 -k server_access.log.
Para cerciorarse de que el artefacto binario .bz2 se ha creado satisfactoriamente y verificar su peso en disco, ejecutamos ls -lh server_access.log.bz2.
2. Consultas directas con bzgrep y modo insensible a mayúsculas (-i)
Para rastrear cadenas específicas evitando el paso previo de descompresión en disco, disparamos bzgrep "ERROR" server_access.log.bz2.
El comportamiento estándar del comando evalúa la concordancia estricta entre mayúsculas y minúsculas, aislando únicamente los registros que contengan el término exacto ERROR.
Cuando se requiere abarcar variaciones tipográficas sin importar cómo esté escrita la palabra, añadimos el modificador -i mediante bzgrep -i "error" server_access.log.bz2.
Esta alternativa neutraliza la distinción tipográfica y recopila todas las coincidencias asociadas en una sola salida en pantalla.
3. Identificación de números de línea (-n), cómputo (-c) y filtrado inverso (-v)
Para determinar en qué posición exacta dentro del archivo se desencadenó un fallo, adjuntamos la opción -n corriendo bzgrep -n "ERROR" server_access.log.bz2.
La consola antepondrá el número de renglón a cada coincidencia, acelerando el diagnóstico sobre archivos masivos.
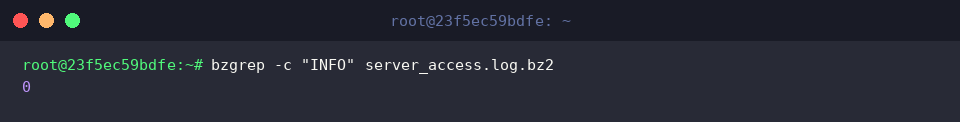
Si en lugar de examinar cada línea requerimos únicamente un recuento cuantitativo del total de eventos, la bandera -c calcula la suma con bzgrep -c "INFO" server_access.log.bz2.
Esto proporciona una métrica numérica instantánea sobre la frecuencia de un estado determinado sin extraer el contenido.
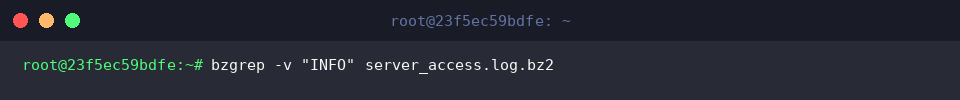
Cuando el objetivo consiste en purgar registros rutinarios para destacar únicamente las anomalías, la exclusión de patrones se efectúa con -v mediante bzgrep -v "INFO" server_access.log.bz2.
El sistema discrimina las entradas informativas y proyecta exclusivamente los eventos atípicos o advertencias restantes.
4. Escaneo colectivo entre múltiples archivos .bz2 y expresiones regulares
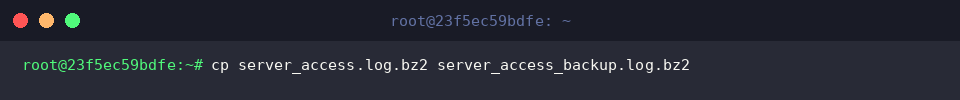
Con vistas a reproducir un escenario donde conviven múltiples rotaciones de logs, generamos una réplica de prueba mediante cp server_access.log.bz2 server_access_backup.log.bz2.
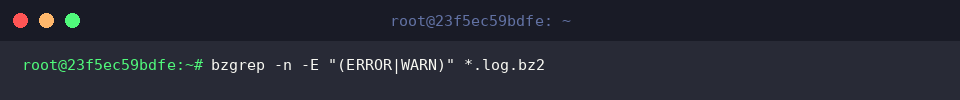
Integrando comodines del shell (*.log.bz2) junto al motor de expresiones regulares extendidas (-E), ejecutamos bzgrep -n -E "(ERROR|WARN)" *.log.bz2.
Esta instrucción barre transversalmente todos los archivos empaquetados en el directorio para localizar coincidencias combinadas de ERROR o WARN.
Al incorporar el indicador de línea (-n), cada línea devuelta reporta tanto el nombre del fichero como la ubicación de la falla, facilitando auditorías forenses distribuidas.
La utilidad bzgrep agiliza sustancialmente la inspección de respaldos y registros rotados en infraestructuras Linux. Al evitar descompresiones temporales, los administradores de sistemas ahorran valioso tiempo de ejecución y protegen el almacenamiento local de sobrecargas innecesarias.