


Introducción a la arquitectura de GNU Coreutils
En cualquier entorno Unix-like, el paquete GNU coreutils representa el cimiento operativo sobre el cual interactúan administradores e ingenieros de sistemas. En lugar de limitarse a memorizar modificadores de comandos comunes, este artículo examina cómo la terminal se comunica directamente con las capas del kernel de Linux: desde la estructura interna de inodos y descriptores de flujo estándar hasta la gestión de operaciones de I/O en bloque y tablas de enlaces.
Inspección de inodos y metadatos del sistema de archivos con ls y stat
Para disponer de un espacio de pruebas aislado y libre de interferencias, creamos una estructura de directorios temporal y accedemos a ella mediante mkdir -p /tmp/coreutils_demo/files && cd /tmp/coreutils_demo/files.
A continuación, generamos una fuente de datos inicial redirigiendo una cadena de texto hacia un archivo plano con echo 'GNU Coreutils Deep Dive' > sample.txt.
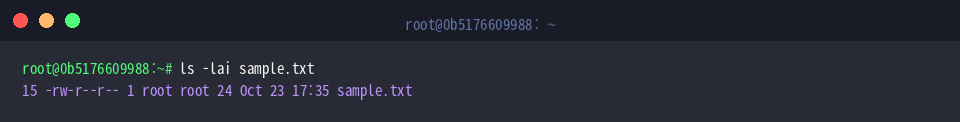
La utilidad ls constituye el mecanismo por defecto para explorar el contenido de directorios. Al combinar los modificadores -lai, obtenemos una radiografía completa del elemento: permisos en notación clásica, propietario, tamaño en bytes y, de forma crucial, el número de inodo. En la salida mostrada, el identificador 15 al inicio de la línea representa el índice único con el que la tabla del sistema de archivos rastrea este nodo.
⚙️ [Parámetros destacados]
-a : Despliega la totalidad de las entradas existentes, incluyendo archivos ocultos que inician con punto (.).-l : Presenta la información en formato extendido (permisos, propietario, grupo, tamaño y fecha de modificación).-i : Incorpora el número de inodo asignado por el sistema de archivos a cada archivo o carpeta.-h : Convierte la escala de bytes a unidades legibles para el usuario (K, M, G).-t : Aplica un criterio de ordenamiento cronológico según la fecha de última modificación.-S : Reorganiza los resultados de mayor a menor tamaño físico.
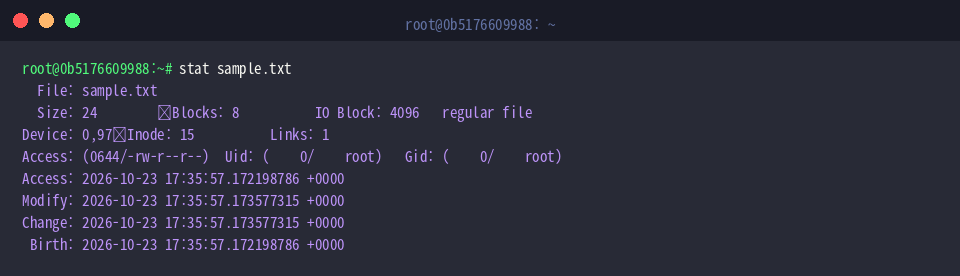
Cuando se requiere una inspección forense o técnica más rigurosa, stat supera las capacidades de visualización estándar. Este comando consulta directamente la estructura stat del kernel, revelando detalles críticos como la cantidad de bloques lógicos asignados, el contador de enlaces duros y las cuatro marcas temporales fundamentales: acceso (Access), modificación (Modify), cambio de atributos (Change) y creación (Birth).
⚙️ [Parámetros destacados]
-c : Permite definir plantillas de formato personalizadas para extraer únicamente variables específicas.-f : Desplaza el foco de análisis desde el archivo individual hacia el superbloque y el sistema de archivos contenedor.-t : Genera una salida concisa en una sola línea, optimizada para scripts bash y pipelines automatizados.-L : Si se aplica sobre un enlace simbólico, resuelve la referencia para mostrar los datos del objetivo original.
Manipulación de flujos de texto y descriptores estándar: head, tail y wc
Para llevar a cabo las prácticas centradas en pipelines y procesamiento secuencial, regresamos a nuestro subdirectorio de trabajo con cd /tmp/coreutils_demo/files.
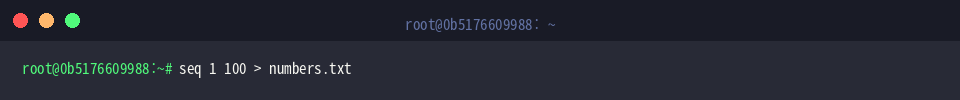
Generamos un dataset numérico secuencial del 1 al 100 empleando la herramienta seq 1 100 > numbers.txt.
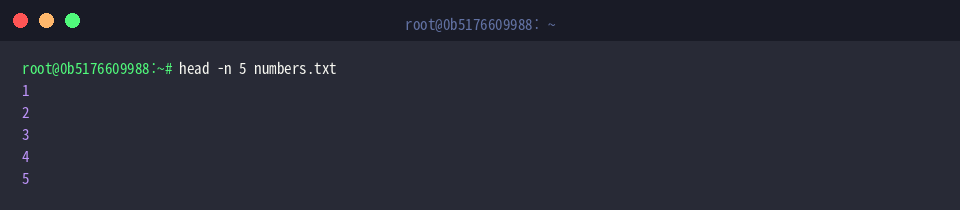
La herramienta head está diseñada para leer streams desde el inicio hacia adelante. Con la opción -n 5, interceptamos únicamente los primeros cinco registros del archivo numbers.txt, reduciendo el consumo innecesario de terminal.
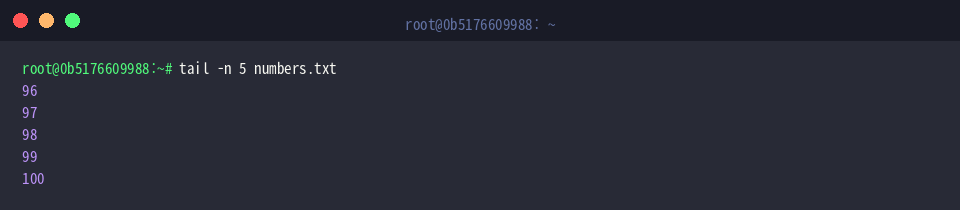
En contraposición, tail efectúa lecturas inversas desde el final de un búfer o archivo. Mediante -n 5, logramos capturar exclusivamente el tramo terminal comprendido entre los números 96 y 100.
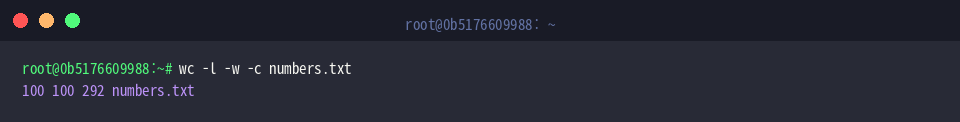
Para auditar métricas textuales sin recurrir a lenguajes interpretados pesados, wc computa líneas, palabras y volumen de bytes con un rendimiento óptimo. La combinación -l -w -c sobre numbers.txt confirma de inmediato 100 líneas, 100 palabras y un peso total de 292 bytes.
Estructura de enlaces en Linux: diferencias clave entre ln rígido y simbólico
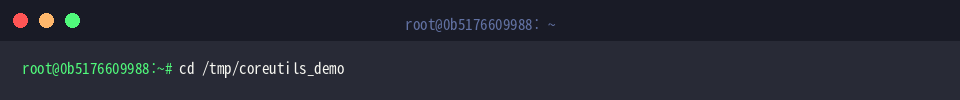
A fin de comprobar cómo impacta la creación de enlaces en la tabla de asignación, retrocedemos al directorio raíz de la demostración mediante cd /tmp/coreutils_demo.
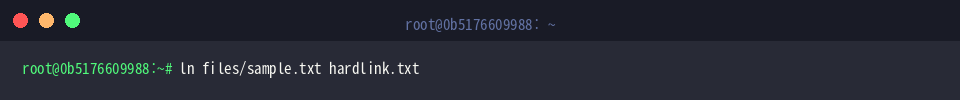
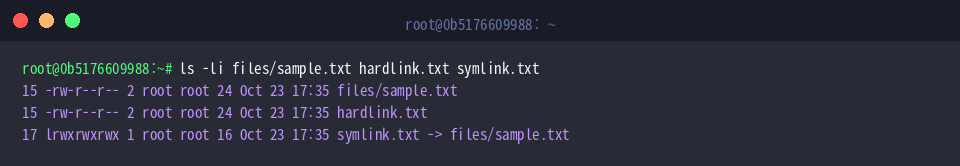
El comando ln establece nuevas entradas en el directorio para apuntar a inodos existentes. Al ejecutar la instrucción en su modalidad predeterminada, creamos hardlink.txt, un enlace duro que comparte los mismos bloques de datos que files/sample.txt.
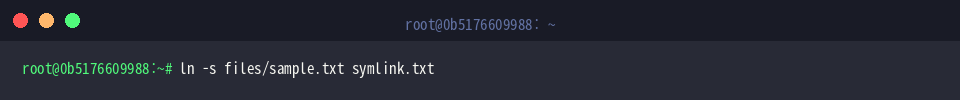
Para generar una referencia indirecta o puntero de ruta, incorporamos el flag -s. Esto crea el archivo symlink.txt, un enlace simbólico que únicamente almacena como contenido la ruta relativa hacia el recurso destino.
Al evaluar el escenario mediante ls junto a los modificadores -l e -i, la arquitectura subyacente queda expuesta: hardlink.txt comparte exactamente el inodo 15 con el archivo original, incrementando a 2 el contador de referencias duras. Por el contrario, symlink.txt posee un inodo propio (17), actúa como un contenedor de ruta independiente y se limita a señalar la ubicación física del archivo base.
Transferencia de bloques I/O a bajo nivel y vaciado de caché: dd y sync
Para el último bloque práctico enfocado en operaciones de almacenamiento masivo y coherencia de datos, nos posicionamos en cd /tmp/coreutils_demo.
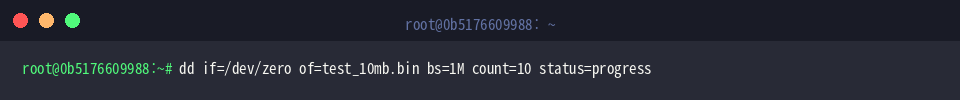
La utilidad dd interactúa directamente con los subsistemas de almacenamiento a nivel de bloque. Mediante la fuente de bytes nulos if=/dev/zero, definimos el destino en of=test_10mb.bin y configuramos un tamaño de bloque de 1MB replicado 10 veces (bs=1M count=10). La directiva status=progress permite monitorizar en tiempo real el rendimiento y la tasa de transferencia en megabytes por segundo.
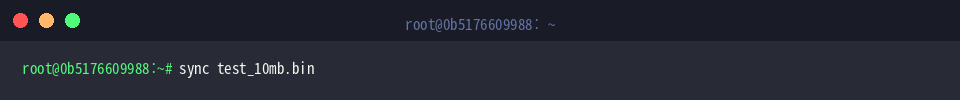
En Linux, las escrituras en disco se absorben inicialmente en la memoria RAM como “páginas sucias” (dirty pages) dentro del page cache del kernel. La llamada sync fuerza el volcado inmediato de estos búferes volátiles hacia los bloques de almacenamiento persistente, evitando inconsistencias ante cortes imprevistos.
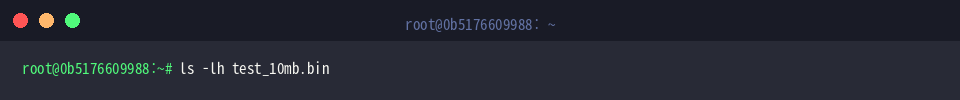
Finalmente, corroboramos la integridad y el dimensionamiento del archivo recién sintetizado aplicando ls -lh test_10mb.bin, confirmando que el contenedor binario de 10MB se encuentra correctamente asentado en el sistema de archivos.
Comprender qué ocurre por debajo de la interfaz de usuario en las utilidades de GNU coreutils transforma la manera en que diagnosticamos incidentes y optimizamos cargas de trabajo. Dominar inodos, descriptores y sincronizaciones de I/O permite construir flujos de administración mucho más resilientes y profesionales en cualquier infraestructura basada en Linux.