


Introducción a la manipulación de flujos de texto en Linux
Al gestionar entornos basados en Linux, el filtrado eficiente de ficheros estructurados e informes de auditoría representa una tarea cotidiana fundamental. La utilidad cut, presente de forma nativa en los sistemas GNU Coreutils, proporciona un mecanismo directo y ágil para extraer segmentos concretos de información sin sobrecargar el sistema. A lo largo de este tutorial, exploraremos diversas técnicas prácticas en Ubuntu para segmentar datos según delimitadores, campos, caracteres y posiciones de bytes.
Preparación del espacio de trabajo y archivos de prueba
Para mantener nuestro entorno de pruebas aislado y ordenado, inicializamos una carpeta dedicada en el directorio personal e ingresamos en ella mediante mkdir -p ~/cut_practice && cd ~/cut_practice.
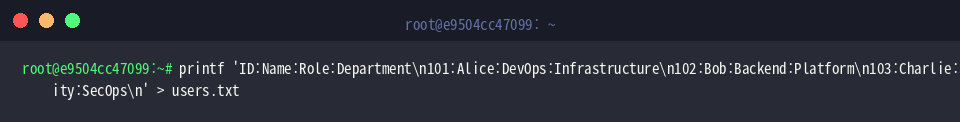
A continuación, creamos el archivo users.txt estructurado con dos puntos (:) como carácter de corte, simulando la clásica disposición de registros de cuentas en Unix, utilizando el comando printf.
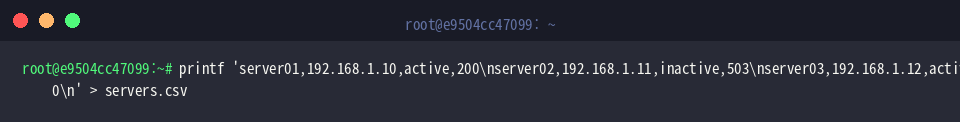
De forma complementaria, generamos un archivo servers.csv delimitado por comas (,) que reúne registros de conectividad y códigos HTTP de infraestructura.
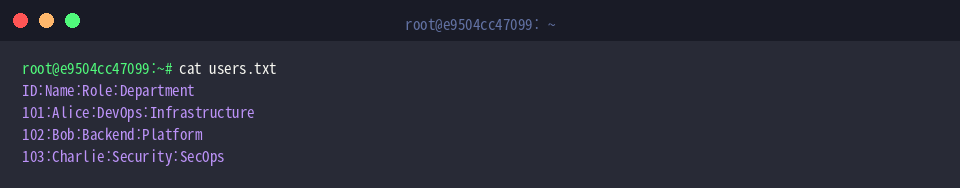
Verificamos la integridad de los datos recién creados en users.txt visualizando sus líneas en pantalla con cat users.txt.
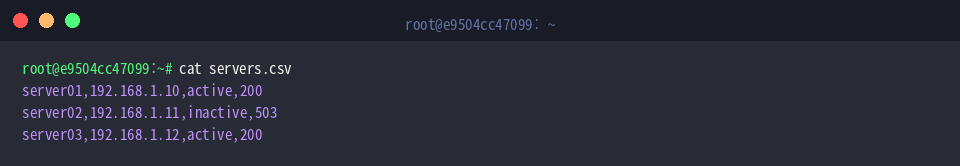
Corroboramos que servers.csv mantenga el formato estándar de campos separados por comas ejecutando cat servers.csv.
Aislamiento de columnas mediante delimitadores (-d) y campos (-f)
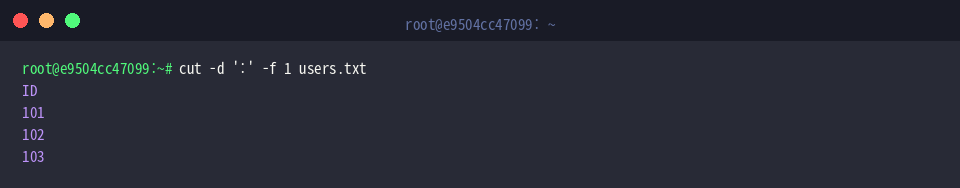
Cuando se requiere consultar exclusivamente la primera columna de un fichero estructurado con :, ejecutamos la instrucción cut -d ':' -f 1 users.txt. El modificador -d ':' establece el criterio de separación, mientras que -f 1 indica la posición específica a mostrar, aislando únicamente los identificadores ID.
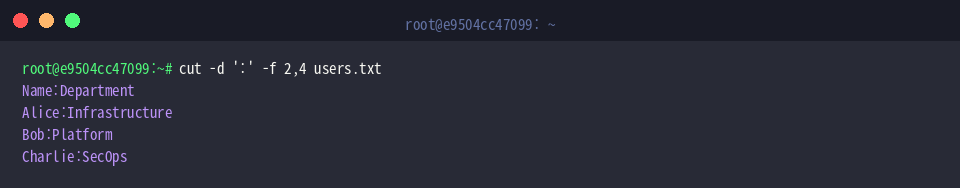
Es posible capturar múltiples columnas no consecutivas especificando sus índices separados por comas: cut -d ':' -f 2,4 users.txt. Esta instrucción entrega el nombre de usuario y su departamento correspondiente, preservando el delimitador de origen.
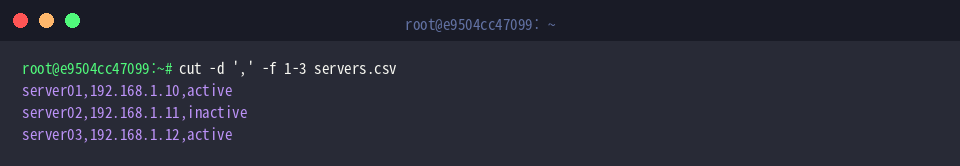
Para obtener un bloque continuo de columnas contiguas, se define un rango empleando un guion medio. Al ejecutar cut -d ',' -f 1-3 servers.csv, el sistema selecciona los elementos del primero al tercero, facilitando el nombre de host, la dirección IP y el estado operativo.
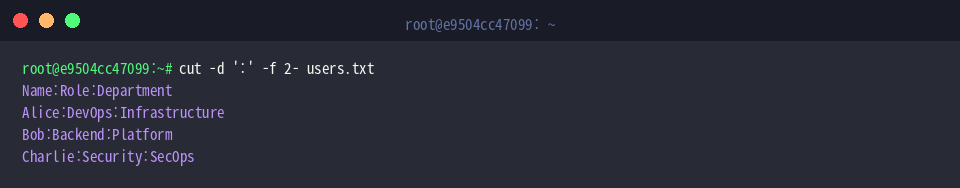
Si el objetivo consiste en descartar el identificador inicial y conservar el resto del contenido de la línea, la sintaxis abierta cut -d ':' -f 2- users.txt extrae desde el segundo elemento hasta el final de cada registro.
Segmentación por posiciones absolutas de caracteres (-c) y bytes (-b)
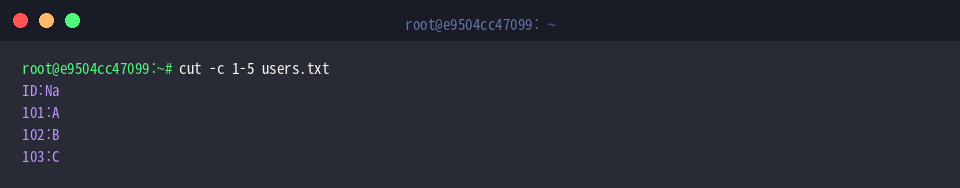
En cadenas con ancho estandarizado donde no existe un delimitador formal, el parámetro -c permite cortar tramos fijos. Al ingresar cut -c 1-5 users.txt, la herramienta recupera únicamente los primeros 5 caracteres de cada registro.
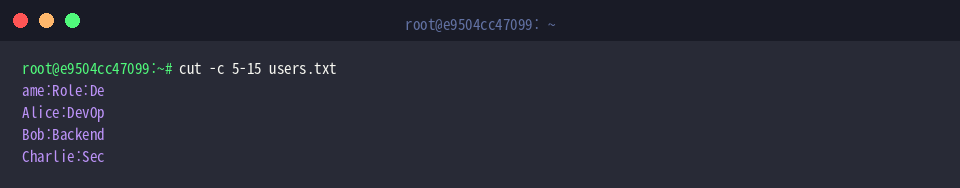
Asimismo, podemos recortar una porción central específica dentro de la secuencia textual corriendo cut -c 5-15 users.txt, limitando la salida al intervalo comprendido entre las posiciones 5 y 15.
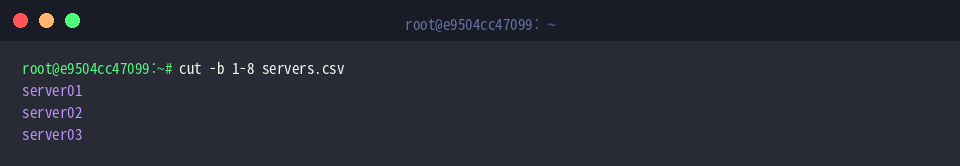
Cuando el procesamiento requiere mediciones exactas a nivel de almacenamiento binario, el argumento -b resulta ideal. Ejecutando cut -b 1-8 servers.csv, obtenemos los primeros 8 bytes de cada fila, aislando limpiamente los identificadores de servidor.
Técnicas avanzadas: personalización de salida y descarte con –complement
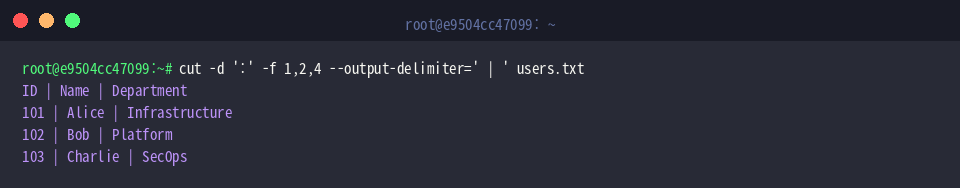
Con el propósito de transformar la visualización de los datos extraídos, la directiva --output-delimiter permite reemplazar el separador original por uno más legible. Al invocar cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt, las columnas solicitadas se representan delimitadas elegantemente por plecas espaciadas (|).
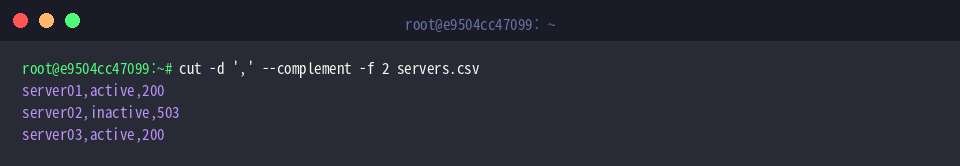
Para omitir una columna puntual y retener todas las demás, la bandera --complement invierte la selección. Al escribir cut -d ',' --complement -f 2 servers.csv, el motor suprime únicamente la segunda columna (las IPs) y despliega el resto de los campos.
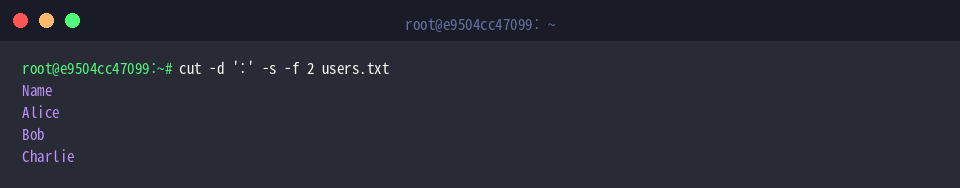
Por último, para evitar que el comando imprima filas que carezcan del separador configurado, añadimos la bandera -s (--only-delimited) mediante cut -d ':' -s -f 2 users.txt, asegurando que únicamente las líneas con formato válido sean procesadas.
Dominar estos modificadores de cut optimiza notablemente la inspección de registros en terminal y agiliza la elaboración de pipelines complejos en scripts de administración bajo Ubuntu.