


Présentation générale
Cet article aborde les utilisations clés de la commande read, indispensable pour la gestion des saisies utilisateur interactives et l’analyse de données textuelles lors de l’écriture de scripts shell Bash sous Linux. Vous maîtriserez parfaitement tous les aspects essentiels : de la saisie de base au masquage de mot de passe (-s), en passant par le délai d’attente (-t), le découpage par délimiteur (IFS), jusqu’au traitement ligne par ligne de fichiers basé sur une boucle while, très utilisé en production.
1. Notions de base de la commande read, invite (-p) et valeurs par défaut
Pour créer et accéder à un espace dédié aux exercices pratiques avec la commande read, exécutez la commande mkdir -p ~/read-demo && cd ~/read-demo.
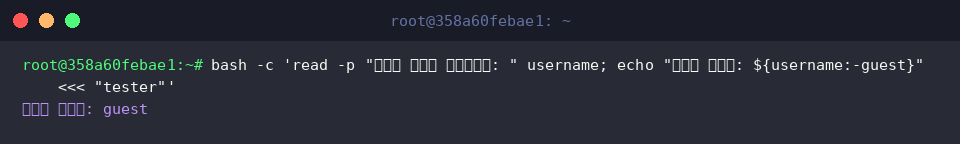
La commande read lit une ligne depuis l’entrée standard et l’enregistre dans une variable. L’option -p permet d’afficher un message d’invite à l’utilisateur, et la syntaxe ${variable:-valeur_par_défaut} permet d’attribuer une valeur de remplacement lorsque la variable est vide.
Dans le résultat d’exécution, aucune saisie directe n’ayant été transmise à la commande read, la variable username est restée vide, affichant ainsi la valeur par défaut guest conformément à la syntaxe ${username:-guest}.
⚙️ [Options principales]
-p : Spécifie la chaîne d’invite à afficher à l’écran avant de recevoir la saisie.-s : Active le mode silencieux (masqué), qui n’affiche pas les caractères saisis à l’écran lors de l’entrée d’informations sensibles telles que des mots de passe.-t : Définit un délai d’attente de saisie (en secondes) et interrompt la saisie une fois le temps écoulé.-n : Lit uniquement le nombre de caractères spécifié et termine immédiatement sans attendre l’appui sur la touche Entrée.-r : Ne traite pas le caractère barre oblique inverse (\) comme un caractère d’échappement et lit la saisie telle quelle.-a : Découpe les mots saisis selon les espaces et les stocke séquentiellement dans une variable tableau.-d : Spécifie directement un caractère délimiteur pour terminer la saisie à la place du saut de ligne.
2. Masquage de mot de passe (-s) et gestion du délai d’attente (-t)
Pour poursuivre la mise en pratique, déplacez-vous dans le répertoire ~/read-demo créé précédemment en exécutant la commande cd ~/read-demo.
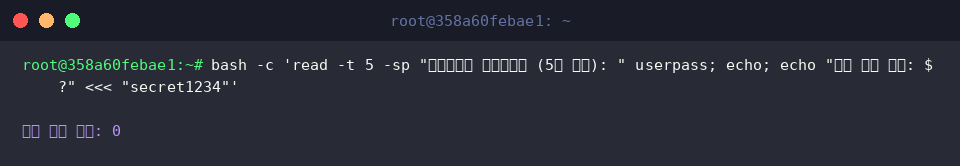
La saisie est effectuée en masquant l’affichage avec l’option -s et en appliquant une limite de 5 secondes grâce à l’option -t 5.
Le mot de passe ayant été correctement transmis dans le délai imparti, le code de statut de sortie ($?) affiche 0.
3. Découpage en variables multiples et tableaux via le délimiteur (IFS) et l’option -a
Pour continuer l’exercice, déplacez-vous dans le répertoire ~/read-demo créé précédemment avec la commande cd ~/read-demo.
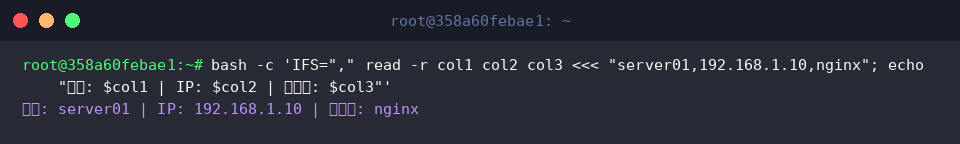
Après avoir défini le séparateur de champ interne (IFS) sur une virgule (,), la chaîne au format CSV transmise via Here-String (<<<) est lue avec la commande read et découpée dans les variables respectives col1, col2 et col3.
Le résultat d’exécution montre que le nom du serveur, l’adresse IP et le nom du service inclus dans la chaîne ont été correctement séparés et affichés selon le délimiteur spécifié.
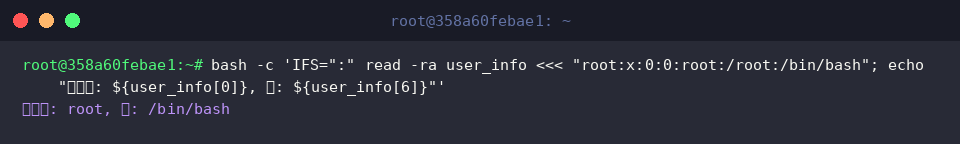
En configurant le délimiteur (IFS) sur deux-points (:) et en utilisant conjointement l’option -a, la chaîne au format /etc/passwd est découpée et stockée dans la variable tableau user_info.
L’index 0 du tableau, correspondant au nom de compte (root), et l’index 6, correspondant au chemin du shell de connexion (/bin/bash), ont été extraits et affichés correctement.
4. Essentiel pratique : traitement ligne par ligne de gros fichiers avec boucle while et read -r
Pour poursuivre la mise en pratique, déplacez-vous dans le répertoire ~/read-demo créé précédemment en exécutant la commande cd ~/read-demo.
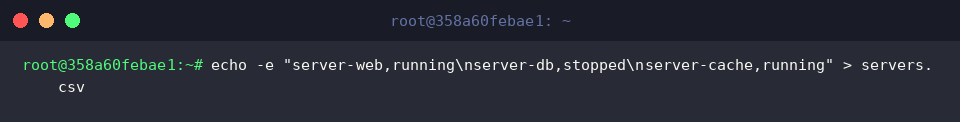
Afin de pratiquer le traitement d’un fichier ligne par ligne, nous créons un fichier CSV d’exemple nommé servers.csv, où le nom du serveur et son état d’exécution sont séparés par une virgule.
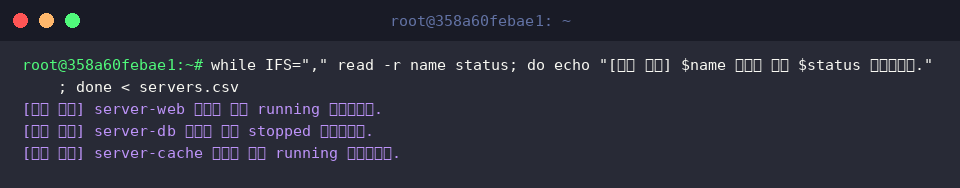
En combinant une boucle while avec la commande read -r et en définissant le séparateur de champ interne (IFS) sur une virgule (,), chaque ligne du fichier servers.csv est lue de manière fiable et sécurisée.
Le résultat d’exécution démontre que les noms de serveurs et les états enregistrés dans le fichier ont été correctement assignés aux variables name et status, puis affichés selon le format attendu.
Nous venons de passer en revue les bases de la commande read utilisable dans les scripts shell Linux, jusqu’aux techniques courantes de lecture de fichiers ligne par ligne en environnement de production.
En vous appuyant sur les diverses options et exemples présentés aujourd’hui, vous êtes désormais prêt à écrire des scripts d’automatisation interactifs parfaitement adaptés à vos besoins.