


Introduction
L’utilitaire cmp constitue l’un des outils d’administration les plus rapides et légers sous Linux pour confronter deux fichiers octet par octet. Que vous ayez besoin d’auditer des artefacts binaires, d’identifier une corruption minime dans une archive ou d’intégrer des validations d’intégrité conditionnelles dans vos scripts Bash, ce guide détaille ses cas d’usage et ses options fondamentales à l’aide d’exemples d’application directe.
Prise en main : détecter le premier décalage (octet et ligne)
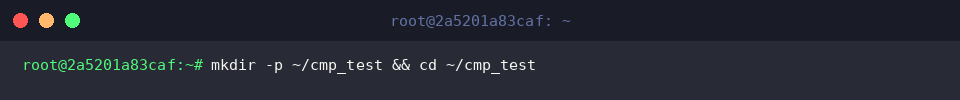
Pour expérimenter sereinement la syntaxe de l’outil, préparons un répertoire de travail isolé à l’aide de la commande mkdir -p ~/cmp_test && cd ~/cmp_test.
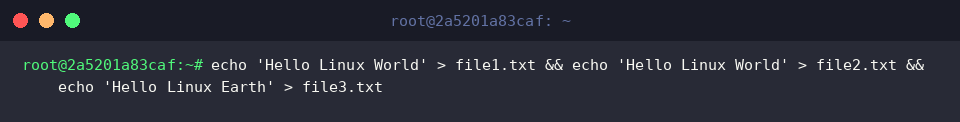
Générons à présent deux documents au contenu rigoureusement identique (file1.txt, file2.txt) ainsi qu’une troisième variante comportant une altération finale (file3.txt) via l’instruction echo.
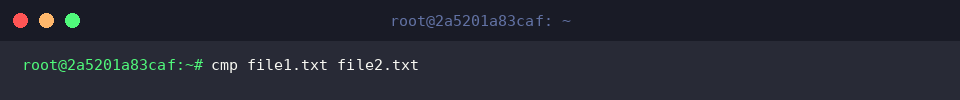
Dans sa configuration par défaut, cmp scrute les deux cibles au niveau binaire ; si aucune divergence n’est relevée, le programme termine son exécution sans émettre la moindre ligne dans la console.
⚙️ [Options indispensables]
-b : Affiche les caractères correspondants ainsi que leur valeur octale au point de divergence.-l : Dresse un inventaire complet de tous les octets discordants avec leur décalage et leur encodage.-n : Borne la confrontation à un volume d’octets strictement défini.-i : Ignore un préambule déterminé en sautant un nombre précis d’octets au début de chaque fichier.-s : Exécute l’analyse en mode totalement silencieux, communiquant uniquement le verdict via le code de retour d’exécution (0 ou 1).
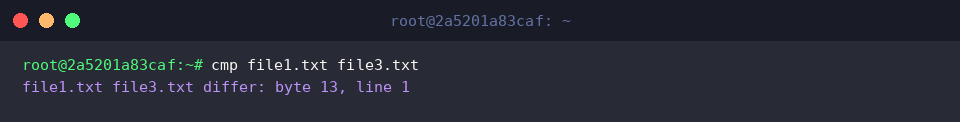
Exécutons à présent la commande cmp file1.txt file3.txt pour observer le comportement de l’utilitaire en présence de deux flux divergents.
Dès qu’un désaccord survient, l’outil signale immédiatement le numéro d’octet incriminé ainsi que la ligne textuelle où se manifeste cette rupture.
Analyse granulaire : lister chaque écart et visualiser les caractères (-l, -b)
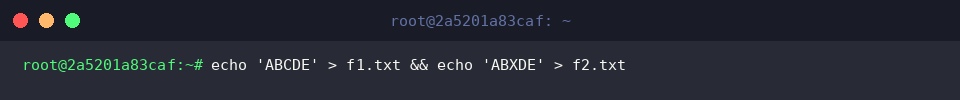
Afin d’examiner en détail la détection au niveau de chaque octet individuel, créons deux petits fichiers de démonstration f1.txt et f2.txt différant uniquement par un caractère central.
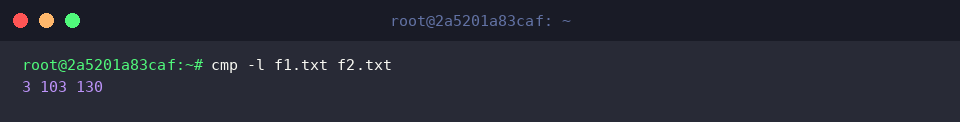
L’appel à la commande cmp -l f1.txt f2.txt produit une cartographie exhaustive de chaque octet discordant, précisant son index de position ainsi que ses valeurs respectives au format octal.
On observe distinctement le décalage sur le 3e octet, le premier fichier stockant la valeur octale 103 (C) tandis que le second présente 130 (X).
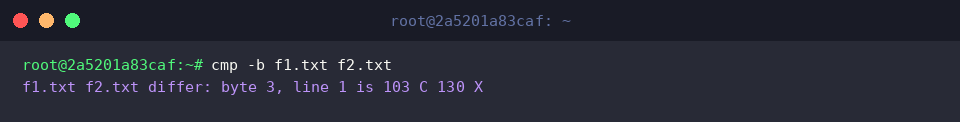
L’usage du paramètre cmp -b f1.txt f2.txt enrichit le retour console en associant directement le caractère ASCII lisible à la valeur octale correspondante lors du premier écart rencontré.
Il devient ainsi immédiat d’identifier la substitution entre le glyphe C (103) et le caractère X (130) au troisième rang.
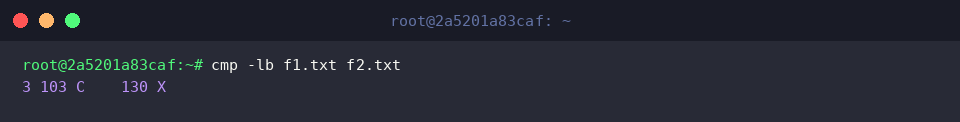
En combinant ces deux arguments via cmp -lb f1.txt f2.txt, vous obtenez un compte-rendu complet alignant index de décalage, code octal et symbole ASCII pour chacune des divergences détectées.
Cette restitution structurée simplifie grandement l’audit de correctifs ou l’analyse de flux binaires altérés.
Automatisation Bash : mode silencieux et exploitation des codes de retour (-s)
Lorsque deux fichiers conformes sont analysés avec l’option -s, aucun texte n’est renvoyé sur la sortie standard ; seul le code de sortie ($?) est positionné pour renseigner le statut d’intégrité.
L’équivalence intégrale des données se traduit par la valeur de succès standard 0.
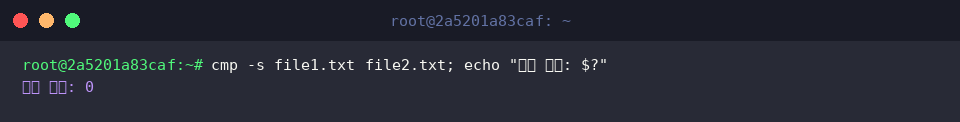
Appliquons ce même indicateur discret à deux cibles dont les contenus diffèrent.
La présence d’au moins une anomalie binaire déclenche automatiquement le code de retour 1, signalant la rupture de parité sans encombrer les journaux d’exécution.
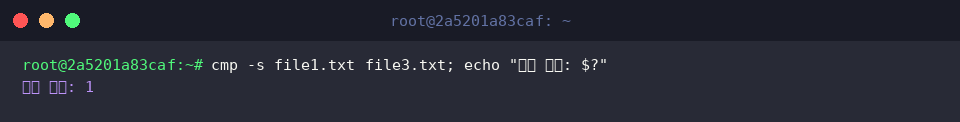
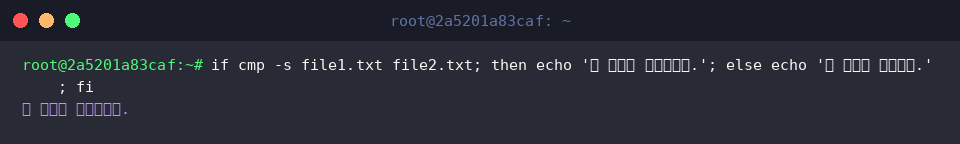
Cette gestion prévisible des codes d’erreur rend la commande cmp -s particulièrement avantageuse au sein des structures conditionnelles if dans les scripts shell.
La conformité absolue des fichiers validant le test logique (code 0), le bloc d’instructions associé s’exécute de manière parfaitement fluide.
Contrôle du périmètre : saut d’en-tête (-i) et limitation de lecture (-n)
Afin d’illustrer la manipulation de fenêtres de comparaison spécifiques, générons deux fichiers data1.txt et data2.txt partageant une terminaison commune mais dotés d’un préfixe distinct.
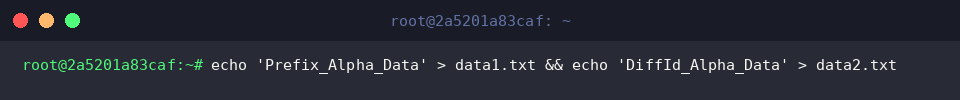
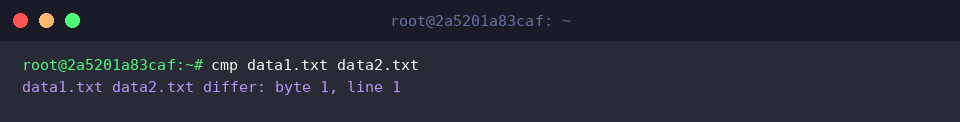
Une confrontation brute via cmp data1.txt data2.txt s’interrompt d’emblée à la première position, signalant un décalage dès l’octet numéro 1 de la ligne 1.
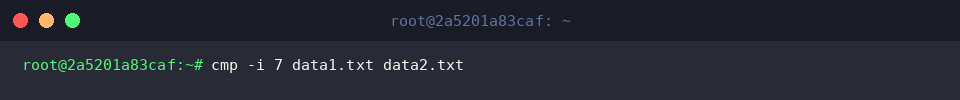
Pour faire abstraction de ces en-têtes variables, le commutateur -i 7 ordonne au programme d’ignorer les 7 premiers octets avant d’amorcer sa lecture comparative.
Le reste de la chaîne (Alpha_Data) étant strictement équivalent de part et d’autre, le terminal n’affiche aucun message d’erreur et rend la main proprement.
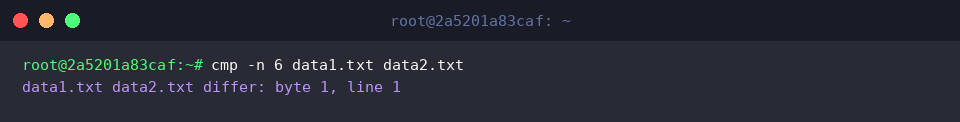
À l’inverse, le paramètre -n 6 permet de borner l’analyse aux 6 premiers octets du flux en ignorant la suite des fichiers.
La zone ciblée contenant précisément les préfixes discordants, l’utilitaire confirme l’anomalie dès l’octet 1 avant d’interrompre l’inspection.
Vous disposez ainsi d’un panorama complet des aptitudes de la commande cmp pour valider l’intégrité de vos flux de données sous Linux. N’hésitez pas à intégrer ces drapeaux d’optimisation lors de vos contrôles de sauvegardes ou dans vos chaînes de déploiement automatisées.