


Introduction
L’analyse différentielle de flux textuels constitue une tâche courante en ingénierie système Linux. Conçu pour traiter deux fichiers préalablement ordonnés, l’utilitaire GNU comm permet d’identifier instantanément leurs éléments communs ainsi que leurs divergences respectives. Ce tutoriel détaille le fonctionnement de son affichage matriciel en trois colonnes, la sélection précise d’ensembles (intersections et disjonctions) via ses indicateurs numériques, ainsi que des techniques d’orchestration avancées adaptées aux environnements de production.
1. Principes fondamentaux de comm et restitution en trois colonnes
Avant toute manipulation, initialisez un environnement de test isolé en exécutant la séquence mkdir -p ~/comm_lab && cd ~/comm_lab.
Générez ensuite le premier fichier d’exemple, fruits_a.txt, contenant une série alphabétique de termes à l’aide de l’instruction printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt.
Constituez le second fichier comparatif, fruits_b.txt, en lançant la commande printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt.
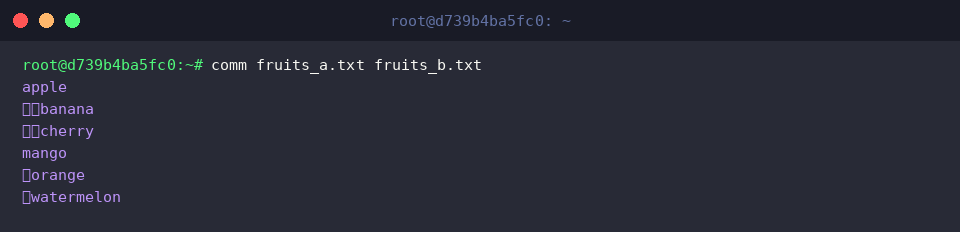
Le programme comm effectue une confrontation ligne par ligne de deux fichiers textuels ordonnés et structure sa sortie standard en trois colonnes distinctes :
- Colonne 1 (aucun retrait) : regroupe les enregistrements exclusifs au premier fichier.
- Colonne 2 (indentation simple par tabulation) : rassemble les lignes présentes uniquement dans le second document.
- Colonne 3 (double tabulation) : met en évidence l’intersection exacte, c’est-à-dire les lignes partagées par les deux sources.
⚙️ [Paramètres essentiels]
-1 : neutralise l’affichage de la colonne 1 (entrées propres au fichier 1).-2 : supprime la colonne 2 (entrées propres au fichier 2).-3 : masque la colonne 3 (lignes identiques partagées).--check-order : s’assure de la stricte conformité du tri lexicographique en entrée.--nocheck-order : désactive la vérification automatique de l’ordonnancement.--output-delimiter=STR : remplace le caractère de tabulation par défaut par la chaîne personnalisée STR.
2. Filtrage ensembliste : extraction d’intersections et de différences relatives
Positionnez-vous dans le répertoire de travail via la commande cd ~/comm_lab.
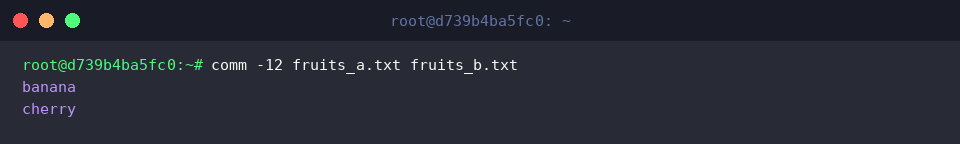
L’invocation de comm -12 inhibe simultanément les première et deuxième colonnes, ne conservant que les éléments partagés par les deux jeux de données.
Le terminal renvoie ici les valeurs banana et cherry, illustrant parfaitement l’intersection ensembliste.
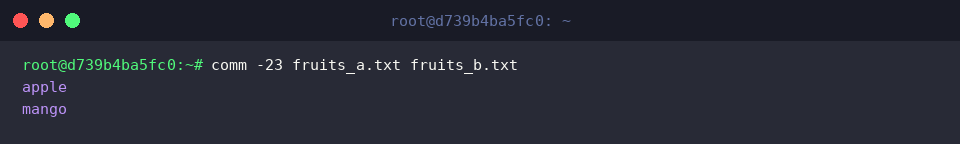
À l’inverse, l’exécution de comm -23 supprime les colonnes 2 et 3, révélant la différence relative du premier ensemble par rapport au second.
La commande isole ainsi les entrées apple et mango, qui n’appartiennent qu’au conteneur fruits_a.txt.
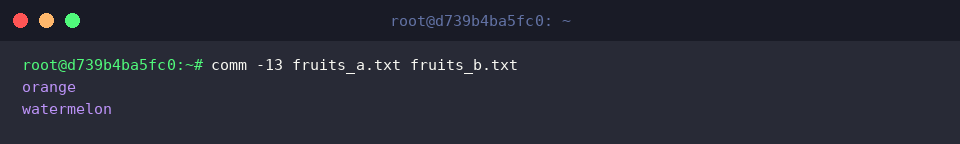
En sollicitant l’option comm -13, les flux 1 et 3 se trouvent masqués au profit des composantes exclusives au second fichier.
La console restitue alors orange et watermelon, spécifiques à fruits_b.txt.
3. Traitement de données non triées via la substitution de processus Bash
Repositionnez le contexte d’exécution au sein du dossier laboratoire grâce à cd ~/comm_lab.
Pour observer le comportement sur des corpus non ordonnés, créez le premier fichier source unsorted_a.txt en invoquant printf "zebra\napple\ngrape\n" > unsorted_a.txt.
Créez dans la foulée le fichier unsorted_b.txt par le biais de l’instruction printf "apple\norange\nzebra\n" > unsorted_b.txt.
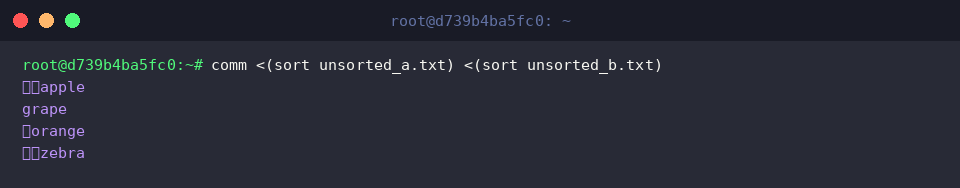
L’expression comm <(sort unsorted_a.txt) <(sort unsorted_b.txt) exploite la substitution de processus du shell (<(...)). Cette construction évite l’écriture de fichiers intermédiaires sur le disque en triant les flux à la volée avant de les injecter directement dans les descripteurs de comm.
L’analyse génère la répartition attendue : grape en colonne 1, orange en colonne 2, puis apple et zebra dans la colonne des éléments communs.
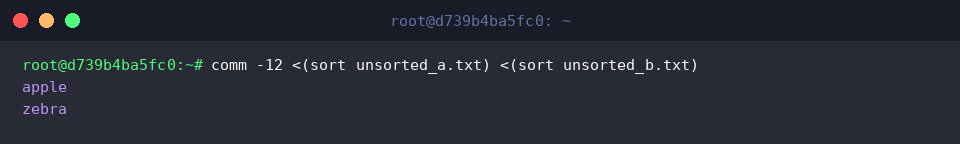
L’adjonction de l’argument -12 sous la forme comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt) affine le filtrage en retenant uniquement les correspondances croisées.
Sans avoir recours à aucun fichier temporaire, les données redondantes apple et zebra sont extraites proprement d’un simple appel.
4. Cas pratiques : audit de paquets système et gestion de la casse
Rejoignez de nouveau l’espace de test avec la commande cd ~/comm_lab.
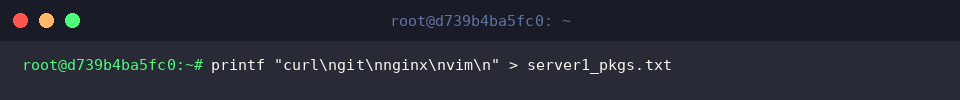
Simulez l’inventaire logiciel d’un premier serveur en créant server1_pkgs.txt via l’instruction printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt.
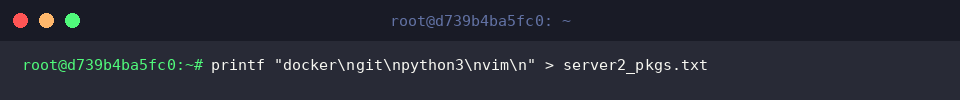
Matérialisez la configuration d’un second nœud d’infrastructure dans server2_pkgs.txt en exécutant printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt.
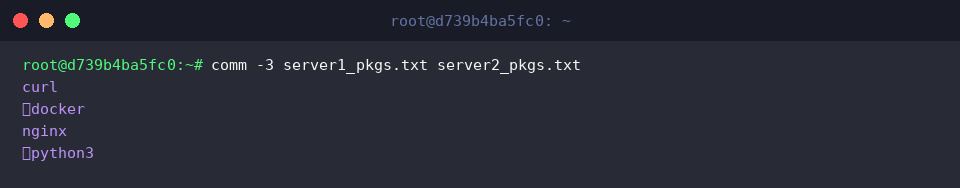
La directive comm -3 server1_pkgs.txt server2_pkgs.txt occulte délibérément la colonne des dépendances communes pour mettre en lumière les disparités d’installation entre les deux machines.
Les utilitaires mutualisés git et vim sont ignorés, laissant apparaître d’un côté les paquets exclusifs à l’hôte 1 (curl, nginx) et de l’autre ceux propres à l’hôte 2 (docker, python3).
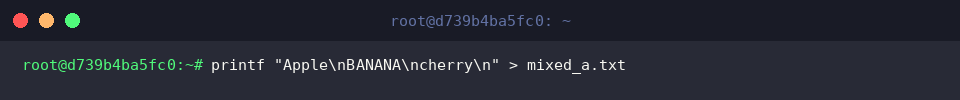
Afin d’étudier l’influence des variations de casse typographique, générez le fichier mixed_a.txt via la commande printf "Apple\nBANANA\ncherry\n" > mixed_a.txt.
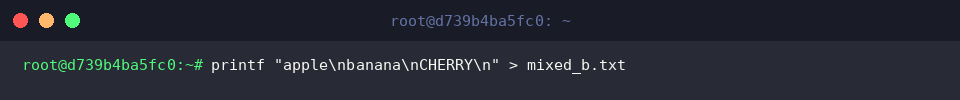
Établissez ensuite l’échantillon antagoniste mixed_b.txt au moyen de printf "apple\nbanana\nCHERRY\n" > mixed_b.txt.
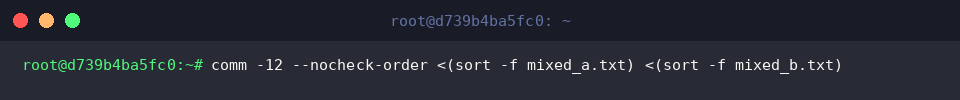
La commande comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) combine un tri insensible à la casse (sort -f) avec le drapeau --nocheck-order, indispensable pour empêcher comm d’interrompre son traitement face à un ordre non conventionnel de ses entrées.
Néanmoins, comme comm opère une comparaison binaire rigoureuse au niveau des octets, les divergences de majuscules empêchent toute correspondance exacte : la commande s’achève donc sans renvoyer la moindre ligne.
Vous disposez désormais d’une vision approfondie des mécanismes de l’utilitaire comm pour segmenter, rapprocher ou isoler des jeux d’enregistrements sous Linux.
En associant judicieusement le tri préalable aux options d’exclusion de colonnes, vous automatiserez avec une efficacité redoutable vos audits d’inventaires, vos vérifications de configurations et vos diagnostics de journaux d’événements.