


अवलोकन
लिनक्स वातावरण में बड़ी टेक्स्ट फ़ाइलों या लॉग डेटा को कुशलतापूर्वक प्रोसेस और फ़िल्टर करने के लिए awk सबसे शक्तिशाली टूल है। जटिल स्क्रिप्ट लिखे बिना केवल एक लाइन के कमांड से विशिष्ट कॉलम निकालना, सशर्त फ़िल्टरिंग, और डेटा योग जैसी क्रियाओं को हल करने वाले मुख्य सिंटैक्स और व्यावहारिक उपयोगों को समझें।
1. awk के कार्य करने का मूल सिद्धांत और विशिष्ट कॉलम निकालना
awk कमांड के अभ्यास के लिए उपयोगकर्ता नाम (username), ID, और पद (role) की जानकारी वाली एक उदाहरण टेक्स्ट फ़ाइल बनाते हैं जो स्पेस द्वारा अलग की गई है।
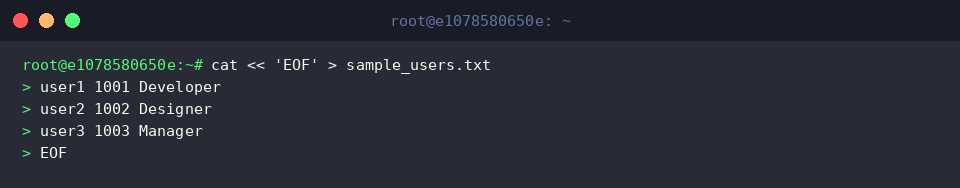
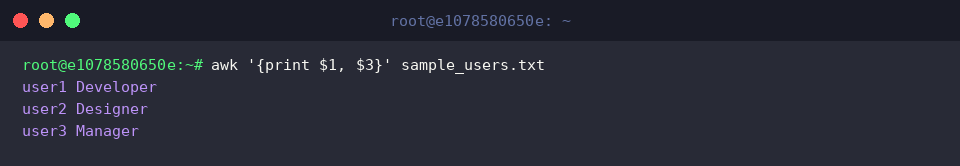
फ़ाइल की प्रत्येक पंक्ति से स्पेस को डेलिमिटर मानकर पहला फ़ील्ड ($1) यानी उपयोगकर्ता नाम और तीसरा फ़ील्ड ($3) यानी पद निकालने और प्रदर्शित करने के लिए awk कमांड का उपयोग करें।
यदि कोई अलग डेलिमिटर निर्दिष्ट नहीं किया गया है, तो awk डिफ़ॉल्ट रूप से लगातार आने वाले स्पेस या टैब के आधार पर फ़ील्ड्स को विभाजित करता है।
⚙️ [मुख्य विकल्प]
-F fs : इनपुट फ़ील्ड सेपरेटर (Field Separator) निर्दिष्ट करता है।-v var=val : निष्पादन से पहले awk स्क्रिप्ट के अंदर उपयोग किए जाने वाले वेरिएबल और प्रारंभिक मान असाइन करता है।-f progfile : उस फ़ाइल का पथ निर्दिष्ट करता है जिसमें निष्पादित करने के लिए awk स्क्रिप्ट कोड लिखा गया है।
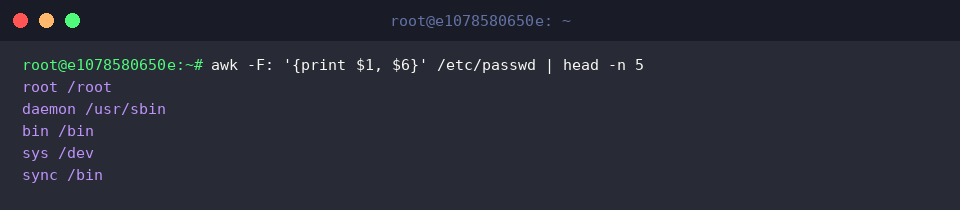
कोलन (:) द्वारा अलग की गई /etc/passwd फ़ाइल में -F: विकल्प के साथ डेलिमिटर निर्दिष्ट करके पहला फ़ील्ड ($1) यानी खाता नाम और छठा फ़ील्ड ($6) यानी होम डायरेक्टरी पथ निकालकर शीर्ष 5 पंक्तियों की जांच करें।
2. कंडीशनल स्टेटमेंट और ऑपरेटर्स का उपयोग करके कस्टम डेटा फ़िल्टरिंग
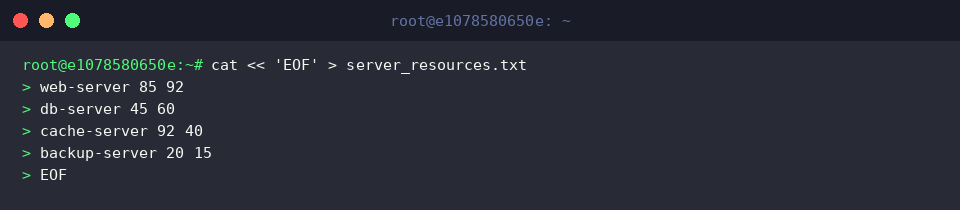
प्रत्येक सर्वर के CPU और मेमोरी उपयोग डेटा वाली अभ्यास के लिए server_resources.txt फ़ाइल बनाएं।
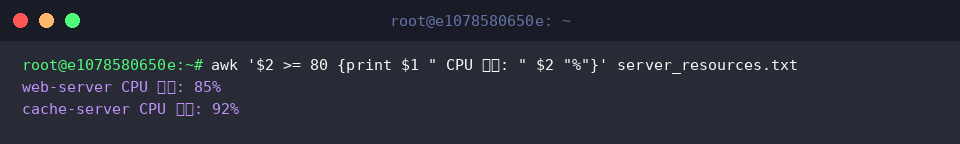
कंडीशनल एक्सप्रेशन के साथ उन लक्ष्यों का चयन करें जिनका दूसरा फ़ील्ड ($2) यानी CPU उपयोग 80% या उससे अधिक है, और संबंधित सर्वर नाम और चेतावनी संदेश प्रदर्शित करें।
सीमा (थ्रेशोल्ड) पार करने वाले सिस्टम संसाधनों की पहचान करने के लिए यह बहुत उपयोगी है।
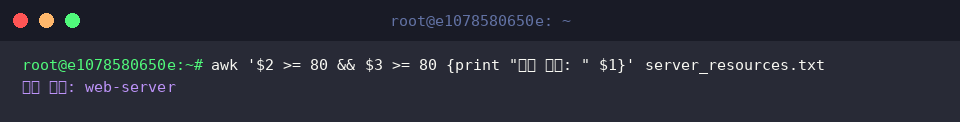
लॉजिकल AND ऑपरेटर (&&) का उपयोग करके ऐसे जोखिम वाले सर्वरों का चयन करें और प्रदर्शित करें जिनका CPU ($2) और मेमोरी ($3) दोनों का उपयोग 80% या उससे अधिक है।
मिश्रित शर्तों को लागू करके आप केवल उन्हीं लक्ष्यों का चयन कर सकते हैं जहां कई संसाधन एक साथ सीमा पार कर चुके हों।
3. बिल्ट-इन वेरिएबल्स और BEGIN/END ब्लॉक का उपयोग करके सांख्यिकी और योग
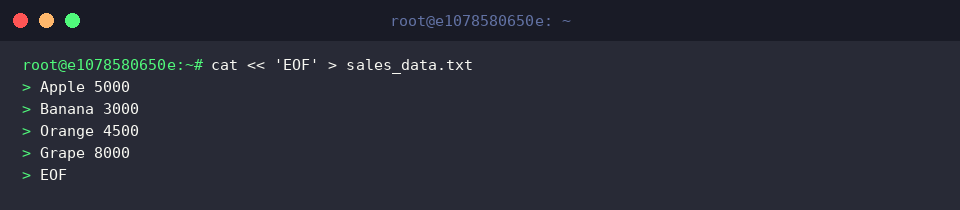
awk का उपयोग करके डेटा एकत्रीकरण और सांख्यिकी अभ्यास के लिए आइटम नाम और बिक्री राशि वाली उदाहरण फ़ाइल sales_data.txt बनाएं।
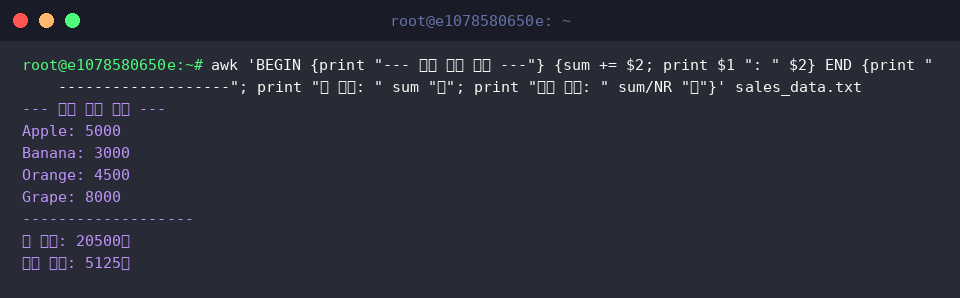
BEGIN ब्लॉक के साथ मुख्य भाग को प्रोसेस करने से पहले एक प्रारंभिक सूचना संदेश प्रिंट करें, और प्रत्येक पंक्ति के दूसरे फ़ील्ड ($2) के मान को वेरिएबल sum में जोड़ते जाएं।
फ़ाइल की सभी पंक्तियों की प्रोसेसिंग समाप्त होने के बाद निष्पादित होने वाले END ब्लॉक में कुल बिक्री और बिल्ट-इन वेरिएबल NR (कुल रिकॉर्ड संख्या) का उपयोग करके औसत बिक्री की गणना करें और प्रदर्शित करें।
4. व्यावहारिक वेब सर्वर लॉग विश्लेषण और असामान्य ट्रैफ़िक फ़िल्टरिंग
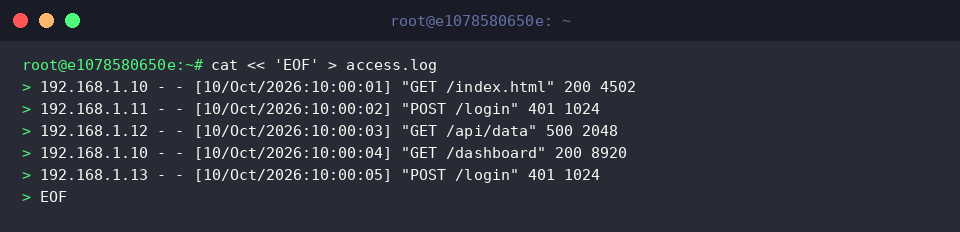
वेब सर्वर लॉग विश्लेषण और त्रुटि ट्रैकिंग का अभ्यास करने के लिए Nginx और Apache मानक प्रारूप में एक उदाहरण लॉग फ़ाइल access.log बनाएं।
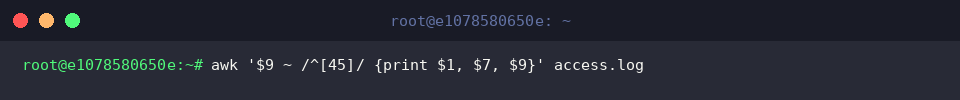
रेगुलर एक्सप्रेशन मैचिंग ऑपरेटर (~) का उपयोग करके उन पंक्तियों को फ़िल्टर करें जहां नौवां फ़ील्ड ($9) यानी HTTP स्थिति कोड 4 या 5 से शुरू होता है (4xx क्लाइंट त्रुटियां और 5xx सर्वर त्रुटियां)।
शर्तों को पूरा करने वाले लॉग से केवल कनेक्टिंग IP ($1), अनुरोधित URI ($7), और स्थिति कोड ($9) निकालकर खराबी और असामान्य ट्रैफ़िक की स्थिति को तुरंत जांचें।
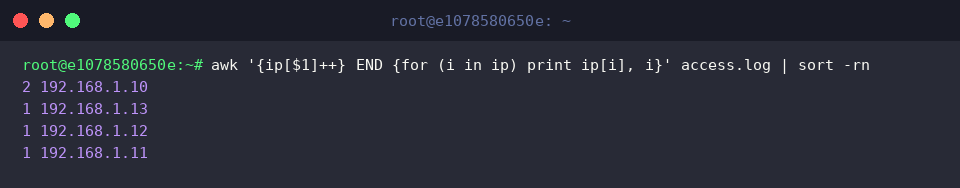
awk के एसोसिएटिव ऐरे (ip[$1]++) का उपयोग करके प्रत्येक कनेक्टिंग IP के अनुरोधों की संख्या गिनें, फिर END ब्लॉक के लूप के साथ कुल संचयी गणना प्रिंट करें और sort -rn पाइपलाइन के माध्यम से अनुरोध आवृत्ति के अवरोही क्रम में सॉर्ट करें।
यह किसी विशिष्ट IP से आने वाले अत्यधिक ट्रैफ़िक या असामान्य एक्सेस प्रयासों की पहचान करने की एक व्यावहारिक विश्लेषण तकनीक है।
अब तक, हमने awk कमांड के बुनियादी सिंटैक्स और प्रमुख व्यावहारिक उदाहरणों को देखा है जो लिनक्स वातावरण में टेक्स्ट प्रोसेसिंग और बड़े पैमाने पर लॉग विश्लेषण को आसान बनाते हैं।
आज सीखे गए विभिन्न विकल्पों और पैटर्न उपयोगों को अपने व्यावहारिक कार्यों में तुरंत लागू करके दोहराव वाले डेटा निष्कर्षण और प्रोसेसिंग कार्यों को और अधिक कुशलता से स्वचालित करने का प्रयास करें।