


परिचय
लिनक्स सिस्टम में दो सॉर्ट किए गए टेक्स्ट डेटासेट्स के बीच समानता और विसंगतियों का विश्लेषण करने के लिए comm यूटिलिटी एक बेहद प्रभावी टूल है। इस गाइड में हम इसके डिफॉल्ट तीन-कॉलम आउटपुट स्ट्रक्चर, विशिष्ट फ़िल्टरिंग ऑप्शंस के जरिए यूनियन/इंटरसेक्शन निकालने के तरीके और सॉर्टेड फाइलों के साथ काम करने की उन्नत शैलियों का व्यावहारिक अध्ययन करेंगे।
1. comm कमांड के बुनियादी सिद्धांत और 3-कॉलम आउटपुट फॉर्मेट
अभ्यास के लिए एक सुरक्षित और पृथक डायरेक्टरी तैयार करके उसमें प्रवेश करने हेतु निम्नलिखित निर्देश निष्पादित करें: mkdir -p ~/comm_lab && cd ~/comm_lab।
तुलना परीक्षण हेतु वर्णमाला क्रम में व्यवस्थित पहली डेटा फाइल fruits_a.txt बनाने के लिए printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt रन करें।
इसके समानांतर विश्लेषण के लिए दूसरी सॉर्टेड फाइल fruits_b.txt तैयार करने हेतु कमांड दें: printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt।
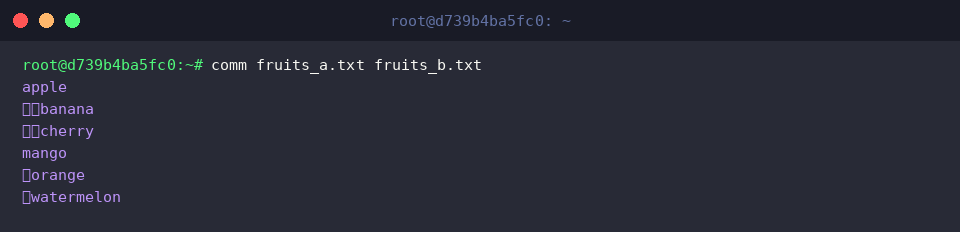
जब comm टूल को दो इनपुट फाइलें दी जाती हैं, तो यह लाइन-दर-लाइन विश्लेषण निष्पादित करता है और परिणाम को तीन अलग-अलग कॉलमों में संरचित करता है:
- पहला कॉलम (कोई इंडेंटेशन नहीं): ऐसी पंक्तियां जो विशिष्ट रूप से केवल प्रथम फाइल में उपलब्ध हैं।
- दूसरा कॉलम (एक टैब स्पेस): ऐसी पंक्तियां जो केवल द्वितीय फाइल में पाई जाती हैं।
- तीसरा कॉलम (दो टैब स्पेस): वे पंक्तियां जो दोनों फाइलों में सामान्य (कॉमन) रूप से मौजूद हैं।
⚙️ [प्रमुख ऑप्शंस]
-1 : पहली फाइल से संबंधित विशिष्ट प्रविष्टियों (कॉलम 1) को आउटपुट से छिपाता है।-2 : दूसरी फाइल से संबंधित विशिष्ट प्रविष्टियों (कॉलम 2) को प्रदर्शित नहीं करता।-3 : दोनों फाइलों में साझा प्रविष्टियों (कॉलम 3) को परिणाम से हटा देता है।--check-order : यह सुनिश्चित करता है कि इनपुट फाइलें सॉर्ट क्रम में हैं या नहीं; अव्यवस्थित होने पर एरर देता है।--nocheck-order : फाइलों के सॉर्ट क्रम की वैधता जांचने की प्रक्रिया को दरकिनार करता है।--output-delimiter=STR : कॉलमों के बीच डिफॉल्ट टैब स्पेस के स्थान पर निर्दिष्ट स्ट्रिंग (STR) को विभाजक के रूप में सेट करता है।
2. संख्यात्मक फ्लैग्स द्वारा डेटा फ़िल्टरिंग: सेट ऑपरेशन्स (इंटरसेक्शन और डिफरेंस)
पुनः अपने कार्य परिवेश में सक्रिय रहने के लिए cd ~/comm_lab चलाएं।
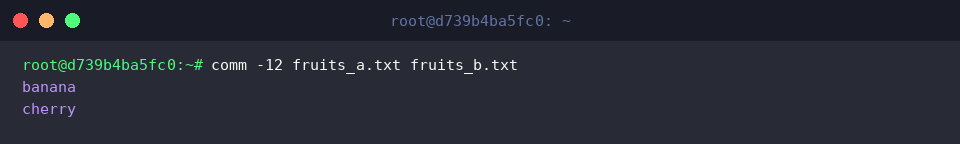
यदि आपको दोनों डेटासेट्स का केवल साझा भाग (Intersection) प्राप्त करना हो, तो कॉलम 1 और 2 को दबाने के लिए comm -12 का उपयोग किया जाता है।
आदेश comm -12 fruits_a.txt fruits_b.txt के निष्पादन से परिणाम स्वरूप केवल banana और cherry प्राप्त होते हैं।
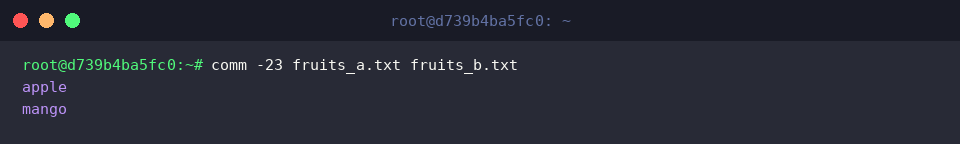
इसके विपरीत, यदि आप प्रथम फाइल की अद्वितीय पंक्तियों (Set Difference: A - B) को अलग करना चाहते हैं, तो कॉलम 2 और 3 को छोड़ना होगा।
आदेश comm -23 fruits_a.txt fruits_b.txt चलाने पर केवल fruits_a.txt में मौजूद apple और mango प्रदर्शित होंगे।
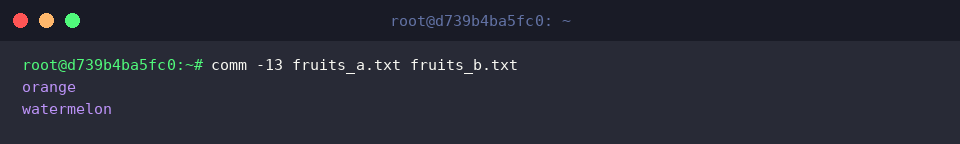
इसी प्रकार, केवल दूसरी फाइल में मौजूद अद्वितीय तत्वों (Set Difference: B - A) की पहचान के लिए कॉलम 1 और 3 को छुपाया जाता है।
आदेश comm -13 fruits_a.txt fruits_b.txt देने पर fruits_b.txt से जुड़े विशेष मान orange और watermelon प्राप्त होते हैं।
3. बिना सॉर्ट की गई फाइलों की तुलना: बैश प्रोसेस सब्स्टीट्यूशन का प्रयोग
अभ्यास डायरेक्टरी में उपस्थिति सुनिश्चित करने के लिए cd ~/comm_lab रन करें।
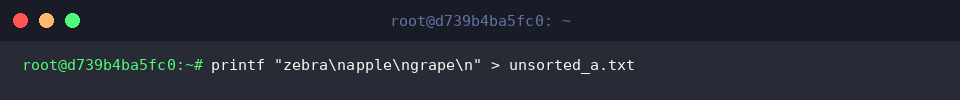
comm केवल सॉर्ट किए गए डेटा पर सही काम करता है। अनसॉर्टेड डेटा के व्यवहार को देखने हेतु पहली अव्यवस्थित फाइल बनाएं: printf "zebra\napple\ngrape\n" > unsorted_a.txt।
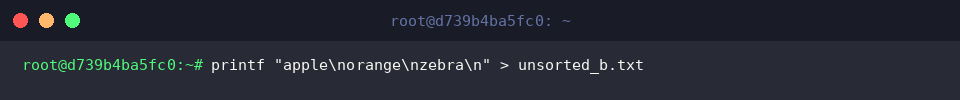
इसके समानांतर दूसरी अव्यवस्थित परीक्षण फाइल तैयार करने के लिए printf "apple\norange\nzebra\n" > unsorted_b.txt निष्पादित करें।
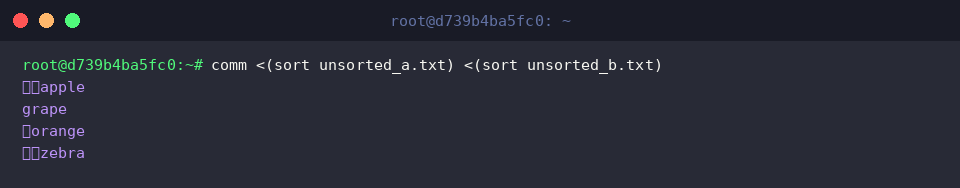
डिस्क पर अतिरिक्त मध्यवर्ती (टेम्परेरी) फाइलें बनाए बिना सीधे मेमोरी में सॉर्टिंग लागू करने के लिए बैश प्रोसेस सब्स्टीट्यूशन सिंटैक्स comm <(sort unsorted_a.txt) <(sort unsorted_b.txt) का इस्तेमाल किया जाता है।
इस प्रक्रिया में sort का आउटपुट पाइप के माध्यम से सीधे comm को दिया जाता है, जिससे कॉलम 1 में grape, कॉलम 2 में orange और कॉलम 3 में साझा मान apple एवं zebra व्यवस्थित रूप से दिखाई देते हैं।
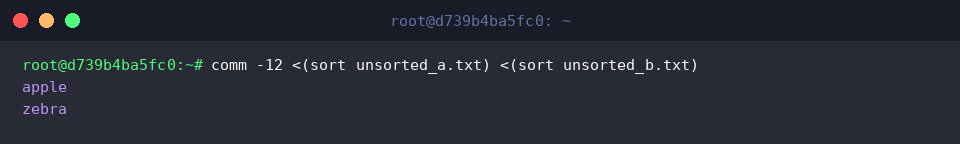
यदि अनसॉर्टेड स्रोतों से केवल उभयनिष्ठ (Common) मान छांटने हों, तो सब्स्टीट्यूशन के साथ फ़िल्टर जोड़ें: comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt)।
यह बिना किसी डिस्क राइट ऑपरेशन के शुद्ध इंटरसेक्शन यानी apple और zebra को स्क्रीन पर प्रस्तुत करता है।
4. व्यावहारिक परिदृश्य: सर्वर पैकेज सूची की जांच और केस-इंसेंसिटिव तुलना
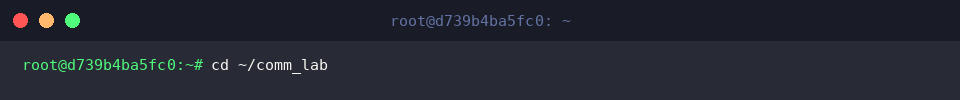
सत्र डायरेक्टरी को पुनः लक्ष्य करने हेतु cd ~/comm_lab दर्ज करें।
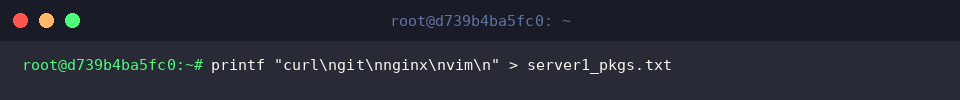
दो अलग-अलग सर्वर्स के कॉन्फ़िगरेशन ऑडिट का अनुकरण करने हेतु पहले सर्वर की पैकेज सूची बनाएं: printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt।
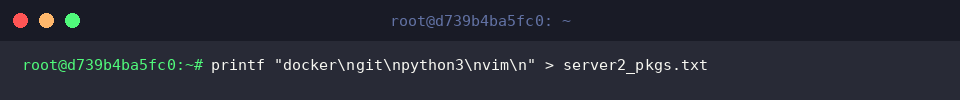
तुलना हेतु दूसरे सर्वर के सॉफ्टवेयर घटकों की सूची बनाएं: printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt।
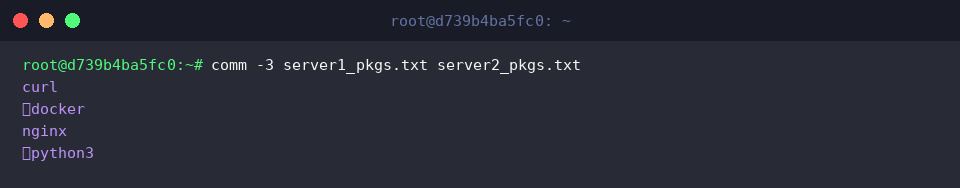
दोनों नोड्स के बीच गैर-साझा सॉफ्टवेयर (XOR ऑपरेशन) का पता लगाने के लिए तीसरा कॉलम हटाकर कमांड चलाएं: comm -3 server1_pkgs.txt server2_pkgs.txt।
परिणाम में साझा घटक (git, vim) बाहर हो जाते हैं, और सर्वर 1 के विशिष्ट पैकेज (curl, nginx) तथा सर्वर 2 के अनूठे टूल्स (docker, python3) आमने-सामने प्रदर्शित होते हैं।
अब केस-सेंसिटिविटी परीक्षण हेतु मिश्रित वर्णों वाली पहली फाइल बनाएं: printf "Apple\nBANANA\ncherry\n" > mixed_a.txt।
तथा दूसरी मिश्रित केस फाइल बनाएं: printf "apple\nbanana\nCHERRY\n" > mixed_b.txt।
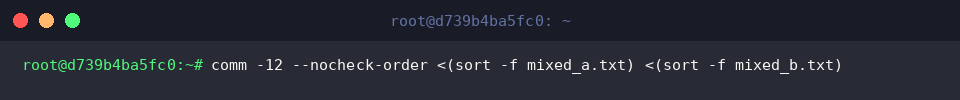
केस-इंसेंसिटिव सॉर्टिंग लागू करके ऑर्डर एरर दबाने के लिए comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) का प्रयोग किया जाता है।
ध्यान देने योग्य महत्वपूर्ण तकनीकी बिंदु यह है कि comm आंतरिक स्तर पर सख्त बाइट-बाय-बाइट मिलान करता है। यद्यपि sort -f ने क्रम को व्यवस्थित कर दिया, लेकिन अक्षरों के केस भिन्न होने के कारण बाइट समानता स्थापित नहीं हो पाती और आउटपुट पूरी तरह रिक्त प्राप्त होता है।
इस प्रकार लिनक्स comm यूटिलिटी टेक्स्ट फाइलों के बीच डेटा समानता और अंतर को अत्यंत त्वरित व पारदर्शी तरीके से विश्लेषित करने की सुविधा देती है।
सिस्टम एडमिनिस्ट्रेशन, कॉन्फ़िगरेशन ऑडिट और बड़े लॉग फाइलों के त्वरित मिलान में sort और पाइपलाइनिंग के साथ इसका समायोजन आपके कमांड-लाइन वर्कफ़्लो को असाधारण दक्षता प्रदान करेगा।