


परिचय
लिनक्स सिस्टम एडमिनिस्ट्रेशन और दैनिक कार्यों में भारी-भरकम लॉग फाइलों या संरचित टेक्स्ट डेटा में से जरूरी जानकारी छांटना एक आम आवश्यकता है, जहाँ cut यूटिलिटी बेहद उपयोगी सिद्ध होती है। इस ट्यूटोरियल में हम उबंटू परिवेश में व्यावहारिक उदाहरणों के साथ डेलीमीटर, कॉलम फील्ड, बाइट्स और कैरेक्टर पोजीशन पर आधारित डेटा निष्कर्षण की बुनियादी व उन्नत तकनीकों को समझेंगे।
कार्यक्षेत्र और टेस्ट डेटासेट तैयार करना
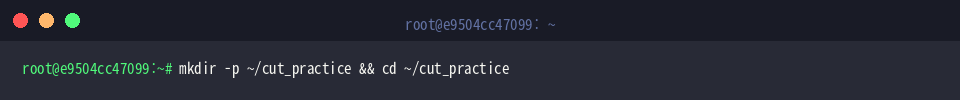
कमांड्स का सुरक्षित अभ्यास करने के लिए सबसे पहले एक समर्पित डायरेक्टरी बनाकर उसमें प्रवेश करते हैं; इसके लिए mkdir -p ~/cut_practice && cd ~/cut_practice रन करें।
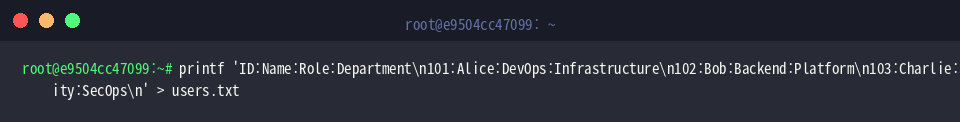
कॉलन (:) डीलिमीटर वाली फ़ील्ड्स पर प्रयोग करने के उद्देश्य से printf की सहायता से users.txt नाम की फ़ाइल तैयार करते हैं जिसमें यूज़र प्रोफाइल रिकॉर्ड मौजूद हैं।
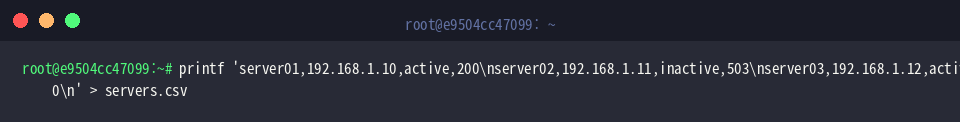
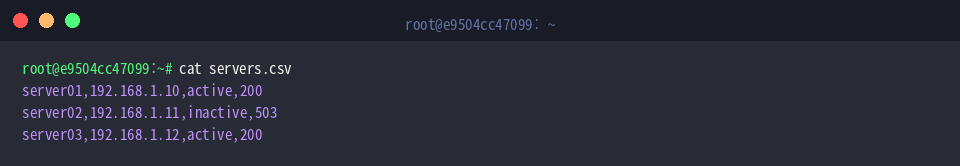
कॉमा (,) आधारित CSV स्ट्रक्चर पर काम करने हेतु सर्वर हेल्थ स्टेटस से संबंधित रिकॉर्ड्स वाली servers.csv फ़ाइल जनरेट करते हैं।
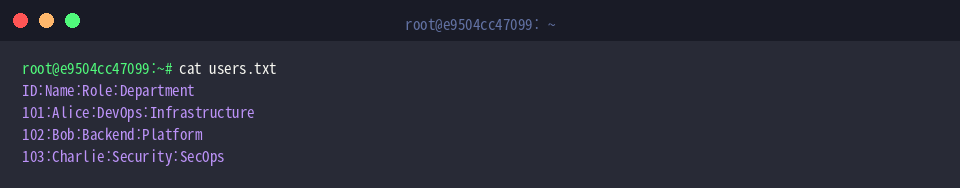
तैयार की गई users.txt फ़ाइल के कॉलम लेआउट और प्रविष्टियों की जांच के लिए cat users.txt चलाएं।
इसी प्रकार servers.csv फ़ाइल में कॉमा से अलग किए गए डेटा और सर्वर स्टेटस कोड्स की पुष्टि करने के लिए cat servers.csv निष्पादित करें।
डेलीमीटर (-d) और फील्ड (-f) द्वारा चुनिंदा कॉलम निकालना
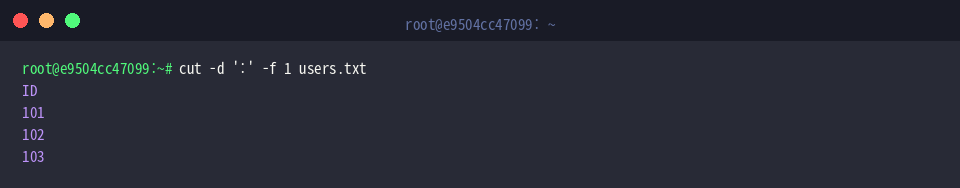
users.txt में कॉलन (:) को सेपरेटर मानते हुए पहला कॉलम अलग करने के लिए cut -d ':' -f 1 users.txt कमांड का उपयोग किया जाता है।
यहाँ -d ':' पैरामीटर विभाजन चिह्न निर्धारित करता है और -f 1 केवल पहले कॉलम को चुनता है, जिससे स्क्रीन पर सीधे खातों की ID सूची प्रदर्शित हो जाती है।
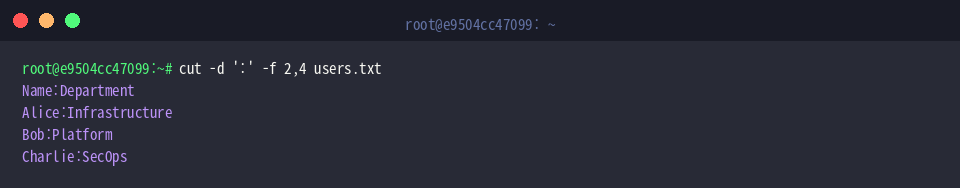
यदि एक से अधिक विशिष्ट कॉलम एक साथ फ़िल्टर करने हों, तो कॉमा की मदद से cut -d ':' -f 2,4 users.txt चलाएं।
इस प्रक्रिया में दूसरा कॉलम (यूज़रनेम) और चौथा कॉलम (डिपार्टमेंट) एक साथ निकलकर मूल सेपरेटर के साथ स्क्रीन पर दिखते हैं।
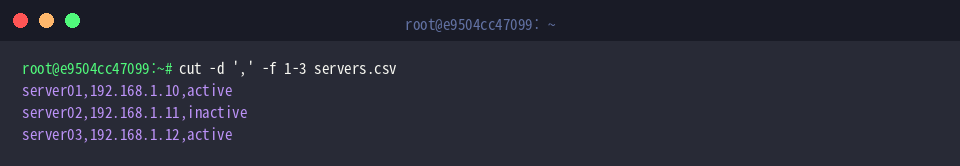
लगातार आने वाले कॉलमों की पूरी रेंज फ़िल्टर करने के लिए हाइफ़न का प्रयोग करते हुए cut -d ',' -f 1-3 servers.csv निष्पादित करें।
यहाँ कॉमा को डेलीमीटर बनाकर -f 1-3 देने से सर्वर का नाम, आईपी पता तथा स्थिति जैसे प्रारंभिक 3 कॉलमों का डेटा एकमुश्त प्राप्त होता है।
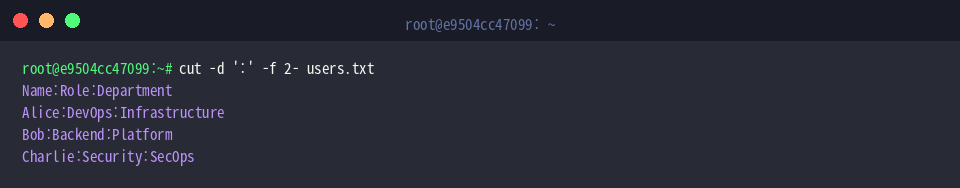
किसी निश्चित कॉलम से शुरू करके पंक्ति के अंत तक का पूरा डेटा प्राप्त करने के लिए ओपन-एंडेड रेंज सिंटैक्स cut -d ':' -f 2- users.txt लागू करें।-f 2- निर्दिष्ट करने से प्रारंभिक ID छूट जाती है और दूसरे फ़ील्ड से लेकर आखिरी फ़ील्ड तक (नाम, रोल, विभाग) का पूरा ब्यौरा बाहर आ जाता है।
कैरेक्टर (-c) और बाइट (-b) पोजीशन के आधार पर टेक्स्ट स्लाइसिंग
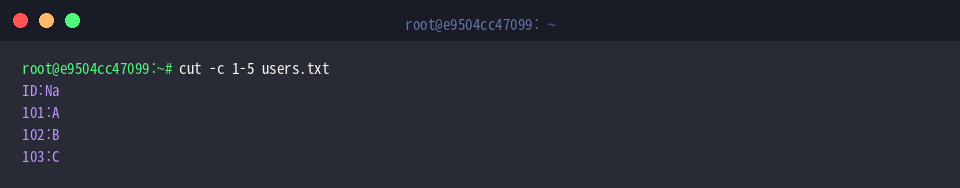
बिना किसी विभाजक के फिक्स्ड-विड्थ टेक्स्ट से 1 से 5 कैरेक्टर की स्थिति का हिस्सा काटने के लिए cut -c 1-5 users.txt रन करें।-c 1-5 फ्लैग प्रत्येक पंक्ति के शुरुआती 5 अक्षरों को बिना डेलीमीटर की परवाह किए सीधे काट कर प्रदर्शित करता है।
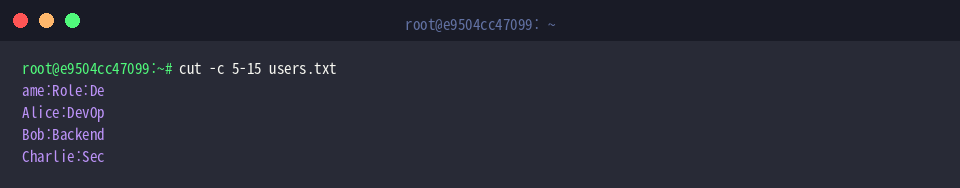
पंक्ति के बीच में स्थित किसी खास कैरेक्टर स्पैन को निकालने के लिए cut -c 5-15 users.txt का उपयोग करें।
इस विकल्प द्वारा 5वें अक्षर से 15वें अक्षर के बीच आने वाले सभी अक्षरों को अलग कर लिया जाता है।
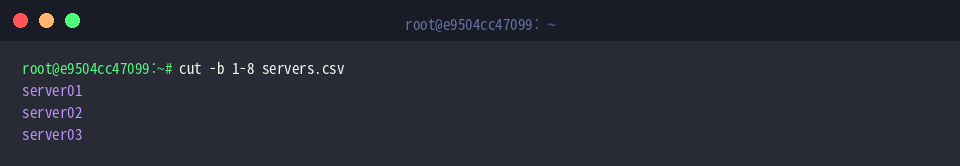
यदि रॉ बाइट्स के सटीक आकार के आधार पर डेटा स्लाइस करना हो, तो servers.csv पर cut -b 1-8 servers.csv चलाएं।-b 1-8 स्विच पहले से आठवें बाइट तक के ब्लॉक को कैप्चर करता है, जिससे प्रत्येक लाइन के शुरुआत में मौजूद सर्वर आइडेंटिफायर तुरंत अलग हो जाते हैं।
आउटपुट डेलीमीटर बदलना और फील्ड इन्वर्जन (–complement)
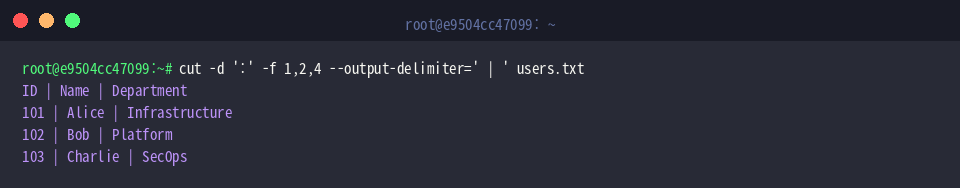
डेटा को अधिक सुपाठ्य बनाने के लिए एक्सट्रैक्शन के दौरान आउटपुट सेपरेटर बदलने हेतु cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt निष्पादित करें।--output-delimiter=' | ' विकल्प मूल कॉलन (:) के स्थान पर पाइप चिह्न (|) सेट कर देता है, जिससे रिपोर्ट या टर्मिनल पर आउटपुट बेहद स्पष्ट नज़र आता है।
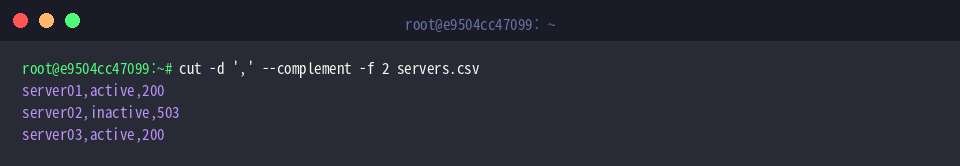
किसी निश्चित कॉलम को छोड़कर बाकी सभी कॉलम प्राप्त करने (इनवर्टेड फ़िल्टरिंग) के लिए cut -d ',' --complement -f 2 servers.csv रन करें।
यहाँ --complement फ्लैग -f 2 में चुने गए दूसरे कॉलम (IP एड्रेस) को हटा देता है और शेष 1, 3 व 4 नंबर के कॉलमों को सुरक्षित रखते हुए प्रदर्शित करता है।
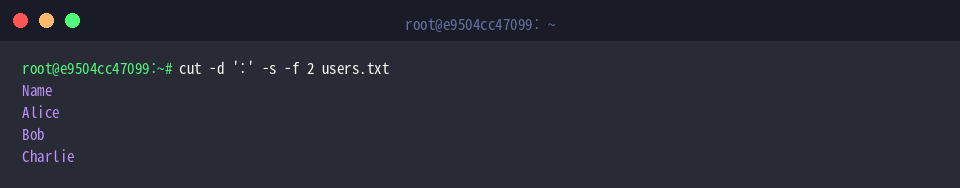
जिन पंक्तियों में विभाजक मौजूद न हो उन्हें छोड़ने और केवल मान्य रिकॉर्ड्स से कॉलम निकालने के लिए cut -d ':' -s -f 2 users.txt कमांड उपयोगी है।-s (--only-delimited) फ्लैग उन सभी लाइनों को अनदेखा कर देता है जिनमें तय डेलीमीटर (:) नहीं मिलता, और केवल संरचित पंक्तियों से दूसरा फील्ड (नाम) एक्सट्रैक्ट करता है।
इस लेख में हमने उबंटू लिनक्स पर cut कमांड के बुनियादी से लेकर उन्नत विकल्पों तक का व्यावहारिक अध्ययन किया।
इन टूल्स और तकनीकों को अपनी शेल स्क्रिप्ट्स तथा लॉग एनालिसिस वर्कफ़्लो में शामिल करके आप जटिल टेक्स्ट प्रोसेसिंग को अत्यंत सरल और तीव्र बना सकते हैं।