


Mengapa Deteksi Encoding Penting di Server Linux?
Karakter yang rusak atau tidak terbaca (mojibake) saat membuka berkas log atau dokumen teks di lingkungan Linux sering kali menyulitkan pekerjaan administrator sistem. Mengetahui format charset asli secara akurat merupakan langkah mutlak sebelum melakukan restorasi dokumen. Artikel ini mengupas tuntas penerapan utilitas chardetect, mulai dari tahapan instalasi paket, pengujian deteksi pada ragam variasi berkas, hingga alur konversi karakter menggunakan perangkat bantu bawaan sistem.
Instalasi chardetect dan Persiapan Perangkat Lunak
Sebelum memanfaatkan fungsionalitas chardetect, kita perlu menyegarkan indeks paket APT dan memasang dependensi python3-chardet ke dalam sistem operasi Ubuntu.
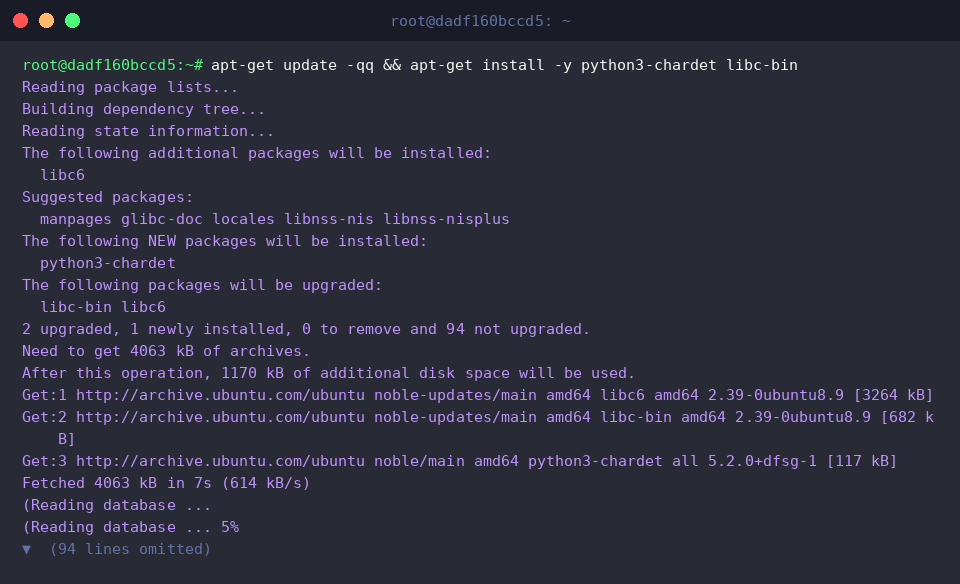
Perangkat lunak chardetect bertindak sebagai penganalisis aliran byte dari berkas teks maupun input data untuk mengenali skema pengodean karakter (charset) sekaligus tingkat keyakinan (confidence level) hasil analisanya.
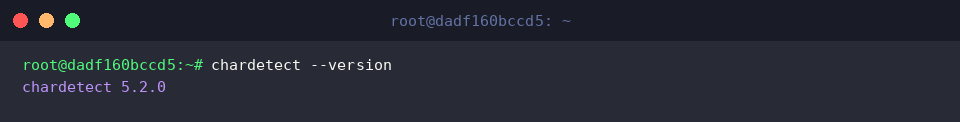
Opsi --version dipakai untuk memeriksa rilis utilitas yang sedang aktif di sistem.
⚙️ [Parameter Pendukung]
-l, --line-per-line : Membedah jenis encoding pada tiap baris secara terpisah, bukan membaca keseluruhan dokumen sekaligus.--minimal : Hanya menampilkan nama encoding tanpa menyertakan persentase keyakinan.-h, --help : Menyajikan rangkuman bantuan serta daftar parameter CLI yang tersedia.--version : Memperlihatkan informasi versi aplikasi kemudian keluar.
Pengujian Deteksi Charset pada Berbagai Sampel Berkas
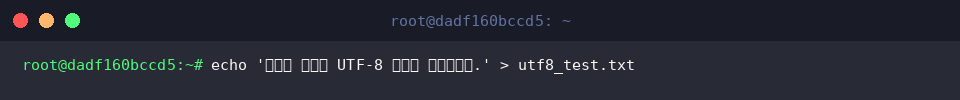
Sebagai fondasi simulasi, kita buat dokumen berformat standar UTF-8 menggunakan perintah echo yang diarahkan ke dalam berkas utf8_test.txt.
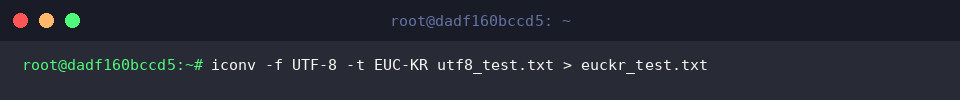
Untuk menguji kepekaan detektor terhadap jenis karakter non-Unicode, kita manfaatkan utilitas iconv guna merombak pengodean teks tersebut ke skema EUC-KR, lalu menyimpannya sebagai euckr_test.txt.
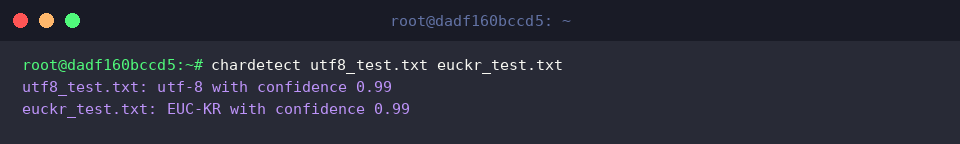
Pengujian identifikasi dapat dijalankan dengan memanggil chardetect diikuti nama-nama berkas yang hendak diperiksa dalam satu baris perintah.
Berdasarkan pembacaan sistem, utf8_test.txt dikenali sebagai UTF-8, sedangkan euckr_test.txt terpetakan sebagai EUC-KR, di mana masing-masing dokumen memperoleh tingkat reliabilitas deteksi sebesar 99%.
Analisis Masal dan Pemrosesan Melalui Pipeline Stdin
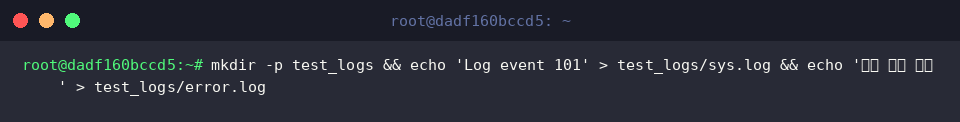
Dalam mengonfigurasi skenario audit berkas catatan sistem, kita siapkan direktori penampung beserta dua sampel catatan log via perintah gabungan mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log.
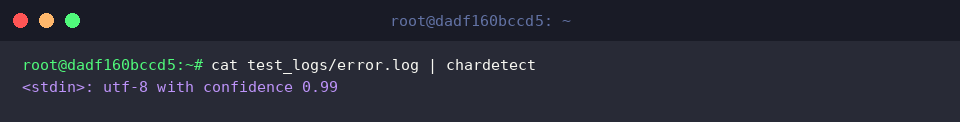
Fleksibilitas CLI memungkinkan integrasi masukan teks dari utilitas cat langsung ke chardetect melalui sambungan pipa (|).
Dari eksekusi pipa tersebut, masukan terbaca sebagai <stdin> dan secara presisi terverifikasi mengusung skema UTF-8 dengan tingkat kepastian mencapai 99%.
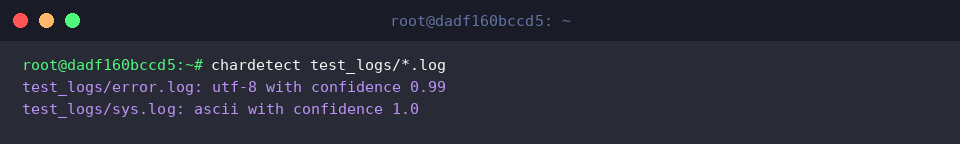
Pemeriksaan masal pada sejumlah dokumen sekaligus dapat diselesaikan secara instan dengan mengandalkan pola wildcard (*) pada direktori test_logs.
Hasil analisis memperlihatkan bahwa berkas error.log yang mengandung karakter non-ASCII dikenali sebagai UTF-8, sementara berkas sys.log yang seluruhnya tersusun atas alfabet latin standar terdeteksi sebagai ASCII murni.
Mekanisme Analisis Byte dan Konversi Teks via iconv
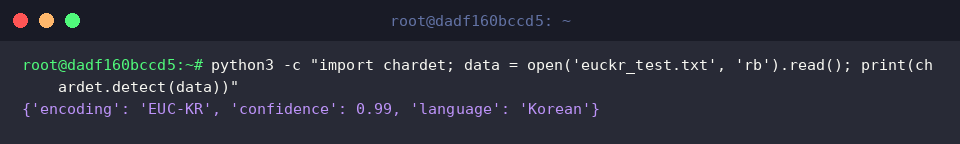
Di balik layar, kemampuan pemindaian CLI ini bertumpu pada pustaka Python chardet. Kita dapat mengeksekusi sebaris instruksi Python untuk mengintip representasi data hasil evaluasi byte mentah secara langsung.
Struktur dictionary yang dikembalikan merinci nama skema (EUC-KR), kalkulasi reliabilitas statistik (0.99), hingga klasifikasi bahasa teks yang bersangkutan (Korean).
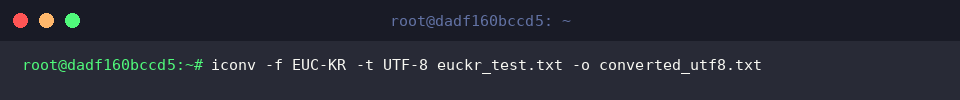
Berbekal data encoding yang valid, dokumen euckr_test.txt kini dapat dinormalisasi ke standar universal UTF-8 menggunakan utilitas iconv, kemudian diekspor ke converted_utf8.txt.
Opsi -f EUC-KR menetapkan format awal berkas, sementara -t UTF-8 menjadi acuan format baru agar transformasi karakter berlangsung mulus tanpa risiko kerusakan data.
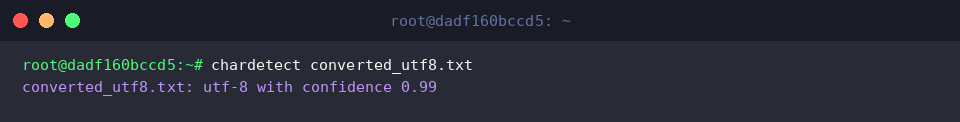
Sebagai langkah validasi akhir, integritas format berkas converted_utf8.txt dipindai kembali lewat perintah chardetect.
Hasil keluaran memvalidasi bahwa seluruh konten dokumen telah beralih sepenuhnya ke standar UTF-8 dengan tingkat akurasi teruji sebesar 99%.
Melalui pemanfaatan utilitas chardetect di Linux, investigasi berkas teks yang korup maupun identifikasi set karakter asing dapat diselesaikan secara efisien.
Teknik ini menjadi bekal esensial bagi teknisi sistem saat menangani pembersihan data, parsing log otomatis, serta migrasi sistem lintas platform.