


Ikhtisar
Dalam administrasi sistem Linux, mengevaluasi kesamaan data maupun anomali antar dokumen teks merupakan kebutuhan rutin. Utilitas comm hadir sebagai solusi bawaan yang sangat efisien untuk membedah relasi antar dua berkas secara instan. Panduan praktis ini mengulas tuntas mekanisme pembacaan output tiga kolom, penerapan seleksi himpunan baris berbasis parameter angka, hingga teknik lanjutan pemrosesan aliran data tanpa pembuatan file perantara.
1. Memahami Arsitektur Output Tiga Kolom pada Perintah comm
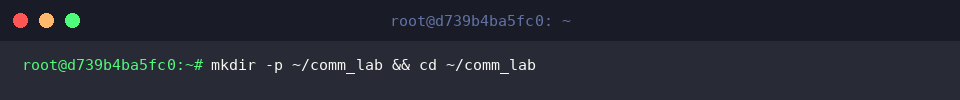
Inisialisasi lingkungan pengujian dilakukan dengan menyiapkan folder kerja baru dan langsung berpindah ke dalamnya melalui instruksi mkdir -p ~/comm_lab && cd ~/comm_lab.
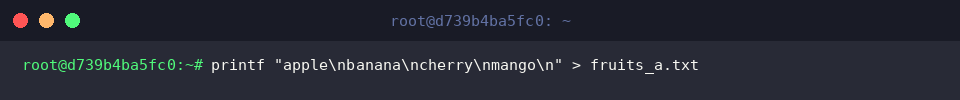
Tahap berikutnya adalah menyusun berkas pengujian awal fruits_a.txt dengan susunan entri yang telah terurut rapi menurut abjad menggunakan printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt.
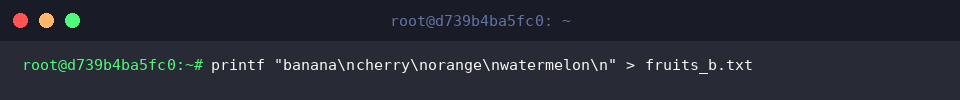
Sebagai pembanding, bentuk berkas kedua bernama fruits_b.txt yang juga tersusun secara alfabetis via perintah printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt.
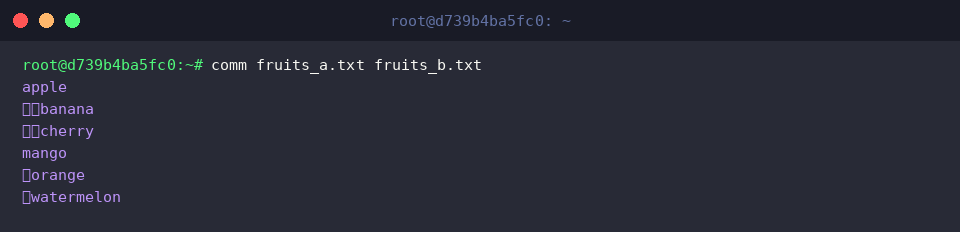
Prinsip kerja comm berfokus pada pembacaan baris demi baris dari dua dokumen yang telah terurut, kemudian memetakan hasilnya ke dalam format tata letak 3 kolom:
Area kolom 1 (tanpa indentasi) menyajikan baris yang secara eksklusif hanya berada di berkas kesatu. Kolom 2 (menjorok satu tab) menampilkan baris unik milik berkas kedua. Sementara itu, kolom 3 (menjorok dua tab) mengelompokkan baris identik yang dimiliki kedua berkas secara bersamaan.
⚙️ [Parameter Kunci]
-1 : Mengeliminasi visualisasi baris unik dari berkas pertama (kolom 1).-2 : Menyembunyikan baris unik milik berkas kedua (kolom 2).-3 : Meniadakan tampilan baris bersama/irisan (kolom 3).--check-order : Memastikan validitas pengurutan leksikografis pada berkas input sebelum diproses.--nocheck-order : Menonaktifkan mekanisme validasi keterurutan data masukan.--output-delimiter=STR : Mengganti pemisah kolom bawaan (karakter tab) dengan rangkaian teks kustom (STR).
2. Teknik Pemfilteran Himpunan: Menemukan Irisan dan Selisih Data
Pastikan sesi terminal aktif Anda tetap berada di lokasi direktori praktikum lewat eksekusi cd ~/comm_lab.
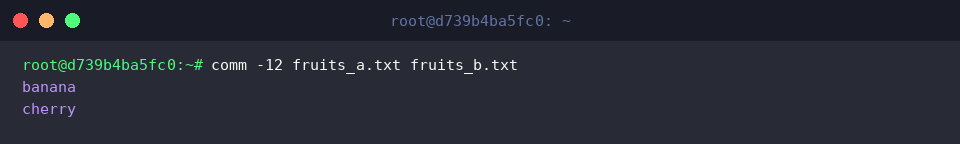
Kombinasi opsi comm -12 bekerja memangkas kemunculan kolom 1 dan 2, sehingga sistem hanya menyaring elemen irisan (intersection) yang berstatus identik di kedua sisi.
Hasil pengujian memperlihatkan bahwa kata banana dan cherry berhasil diisolasi sebagai data yang saling beririsan.
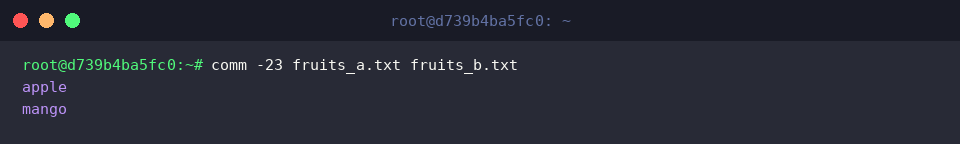
Untuk mengetahui entri yang hanya eksis pada berkas awal tanpa menyertakan entri bersama, manfaatkan comm -23 guna menonaktifkan kolom 2 dan 3.
Melalui eksekusi tersebut, daftar unik apple dan mango dari berkas fruits_a.txt langsung tersaji dengan presisi.
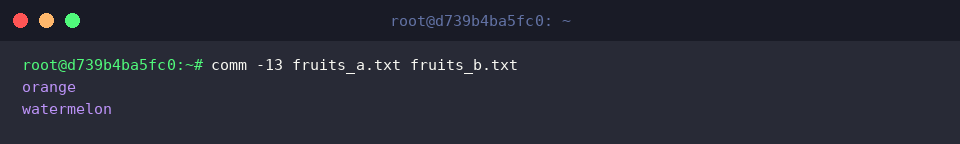
Sebaliknya, sintaks comm -13 menutup kolom 1 dan 3 untuk membedah komponen eksklusif yang tersimpan pada berkas kedua.
Langkah ini secara otomatis memunculkan baris orange serta watermelon yang murni berasal dari fruits_b.txt.
3. Menangani Berkas Belum Terurut: Integrasi Process Substitution Bash
Posisikan kembali konteks kerja direktori Anda melalui perintah cd ~/comm_lab.
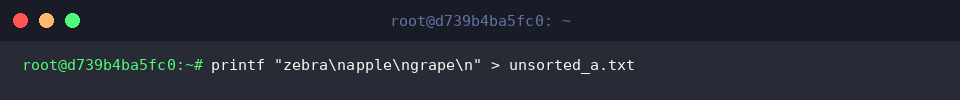
Sering kali kita berhadapan dengan data mentah yang posisinya acak. Untuk mensimulasikannya, buat berkas tak terurut pertama unsorted_a.txt lewat printf "zebra\napple\ngrape\n" > unsorted_a.txt.
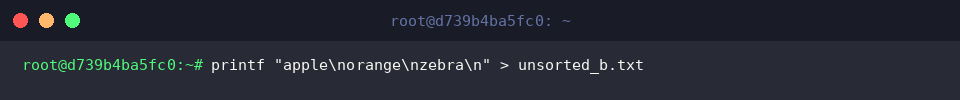
Lanjutkan dengan menyusun data acak pembanding unsorted_b.txt menggunakan baris perintah printf "apple\norange\nzebra\n" > unsorted_b.txt.
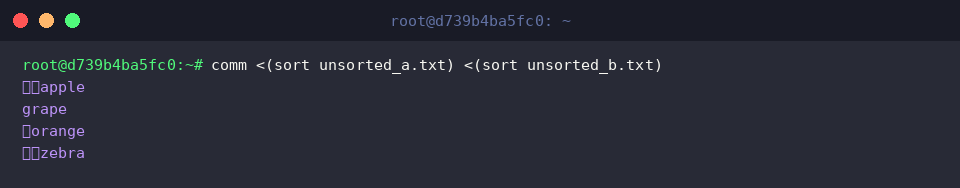
Alih-alih menulis ulang file fisik, fitur Process Substitution pada shell Bash (<(...)) memungkinkan pengurutan dilakukan langsung di memori sistem melalui perintah comm <(sort unsorted_a.txt) <(sort unsorted_b.txt).
Mekanisme ini menyalurkan stream yang telah terurut ke parser comm, memetakan grape pada kolom 1, orange pada kolom 2, serta mendeteksi apple dan zebra di kolom 3 tanpa mengotori media penyimpanan dengan file temporer.
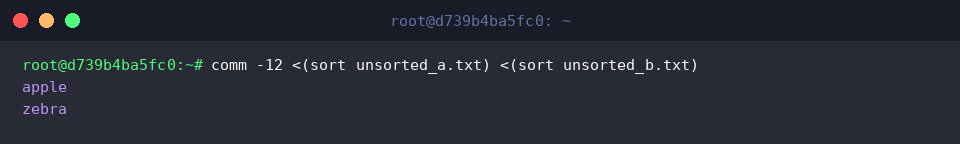
Kolaborasi antara substitusi proses dan opsi reduksi kolom dapat dijalankan melalui comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt).
Instruksi terpadu ini menyaring irisan data mentah secara instan, menghasilkan nilai apple dan zebra secara bersih dalam satu alur kerja yang sangat ringkas.
4. Studi Kasus Produksi: Sinkronisasi Paket Server & Komparasi Case-Insensitive
Pastikan Anda berada di direktori kerja yang relevan dengan menjalankan cd ~/comm_lab.
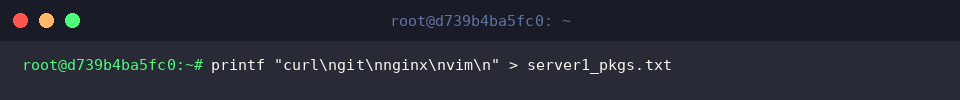
Dalam skenario audit infrastruktur, misalnya mencocokkan instalasi antar server, kita dapat membuat daftar inventaris paket server pertama server1_pkgs.txt melalui printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt.
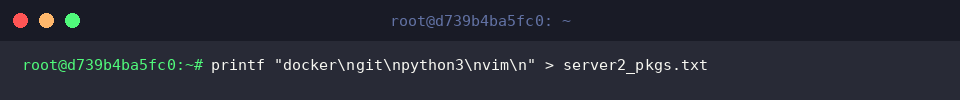
Selanjutnya, susun daftar komponen pada server target server2_pkgs.txt menggunakan perintah printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt.
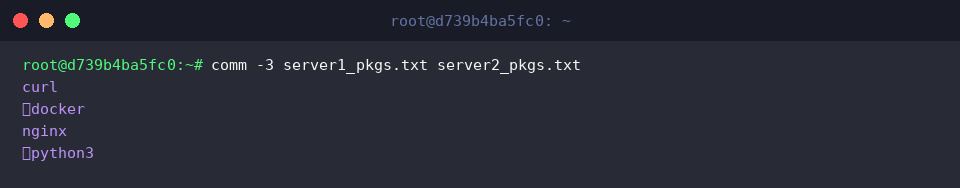
Guna menyorot disparitas perangkat lunak antar kedua mesin, jalankan comm -3 server1_pkgs.txt server2_pkgs.txt untuk mengabaikan paket yang sudah terpasang di kedua server (menutup kolom 3).
Keluaran terminal langsung menyisihkan git dan vim, lalu menampilkan curl serta nginx untuk server pertama, berdampingan dengan docker dan python3 milik server kedua.
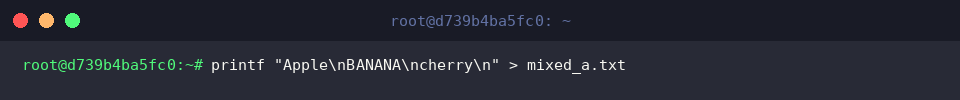
Untuk pengujian terhadap teks dengan variasi kapitalisasi, bentuk dataset awal mixed_a.txt menggunakan perintah printf "Apple\nBANANA\ncherry\n" > mixed_a.txt.
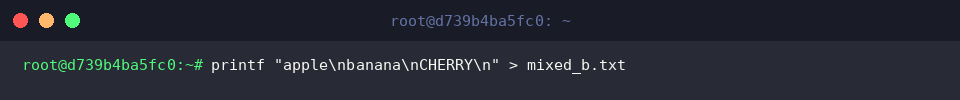
Lengkapi skenario variasi huruf tersebut pada file kedua mixed_b.txt via instruksi printf "apple\nbanana\nCHERRY\n" > mixed_b.txt.
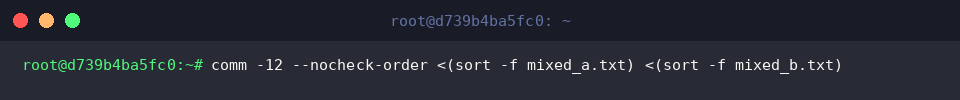
Perintah comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) mengurutkan entri secara case-insensitive (sort -f) sekaligus menyertakan parameter --nocheck-order untuk mencegah kegagalan validasi urutan bawaan comm.
Meskipun susunannya telah diselaraskan, evaluasi comm tetap berpijak pada kecocokan byte mutlak. Akibatnya, perbedaan format huruf membuat sistem menganggap tidak ada baris yang sepenuhnya identik, sehingga terminal tidak mengembalikan luaran apa pun.
Melalui eksplorasi di atas, Anda telah menguasai cara kerja utilitas comm di Linux untuk menganalisis irisan maupun disparitas baris data secara akurat.
Integrasikan pemahaman tentang manipulasi kolom dan pra-pengurutan data ini ke dalam skrip otomatisasi Anda untuk mempercepat penelusuran log maupun sinkronisasi sistem berskala besar.