


概要
Linux(Ubuntu)システムにおいて、テキストやバイナリ情報を通信経路で欠損させず安全にハンドリングするためのツールが base32 です。本稿では、Base32変換の基礎概念から主要オプションを駆使した実践的なフォーマット整形、さらにはバイナリデータの整合性テストに至るまで、実務に即した運用法を整理します。
base32の導入状況チェックと標準出力ストリーム変換
まずはシステム上にバイナリが正しく配置されているかを確かめるため、which base32 を実行してパスを検出します。
GNU coreutilsに含まれる base32 ユーティリティは、入力ストリームを5ビット単位のアルゴリズムで変換・逆変換し、結果をstdoutへ送出します。
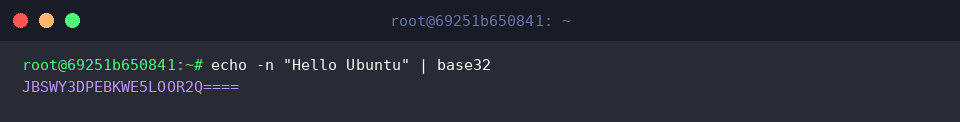
ここではパイプライン(|)経由で "Hello Ubuntu" という文字列を渡し、Base32文字列へ即座にエンコードさせてみます。
⚙️ [実務で役立つ主要オプション]
-d, --decode : Base32形式のデータを逆変換し、元のバイナリや平文を復元します。-i, --ignore-garbage : デコード処理時に、規定文字セット外の混入文字列(改行やノイズ)を無視します。-w, --wrap=COLS : 出力文字列の折り返し桁数を指定します(0 は改行なし、標準設定は76文字)。--help : コマンドの構文ガイドとオプション一覧を表示します。--version : 導入されているコアパッケージのバージョン情報を出力します。
ファイルベースの変換と行折り返し幅(-w)の制御
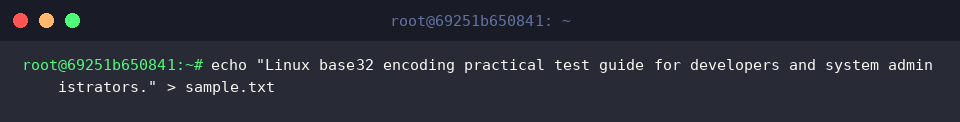
実際のファイル処理をシミュレートするため、動作検証用テキストを格納した sample.txt を手動生成します。
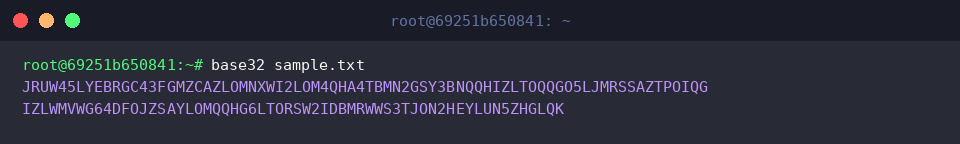
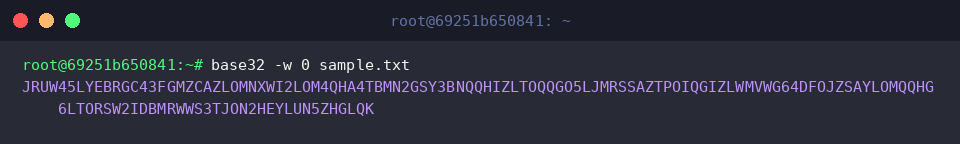
コマンドの引数に対象ファイルを直接指定すると、その全内容が読み込まれ、自動的にBase32へと変換されます。
デフォルト動作では、可読性を高めるために76文字ごとに改行コードが挿入される仕様となっています。
一方、シェルスクリプト内の変数へ格納したり、Web APIなどのペイロードとして1行で扱いたい場合は -w 0 を指定します。これにより行分割が無効化され、フラットな単一ストリームとして取得可能です。
保存済みBase32データの復元処理(-d)
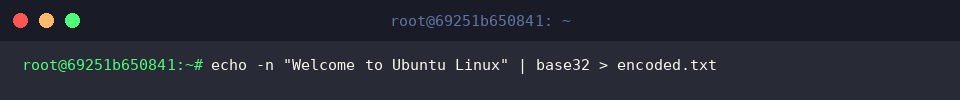
逆変換の手順を確認すべく、あらかじめ "Welcome to Ubuntu Linux" という文字列をエンコードし、encoded.txt へリダイレクトして準備します。
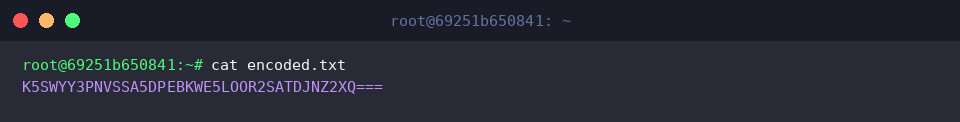
出力されたファイルの中身を cat で閲覧し、正常なBase32文字セットで構成されているかをチェックします。
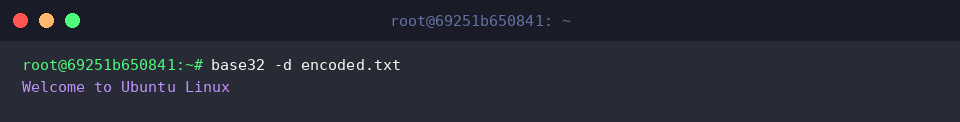
続けて -d フラグを付与してファイル名を渡すことで、Base32ストリームから元のバイト列を復元します。
先ほど変換にかけた "Welcome to Ubuntu Linux" が欠損なく端末上に再現されることが確認できます。
バイナリ処理におけるパディング(=)挙動とビット整合性の検証
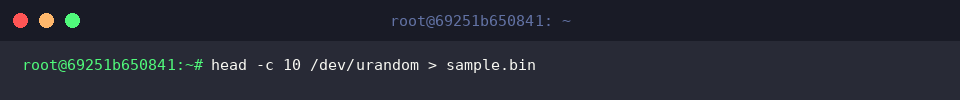
ランダムなバイト列を対象とするケースを検証するため、/dev/urandom から10バイトを切り出して sample.bin を作成します。
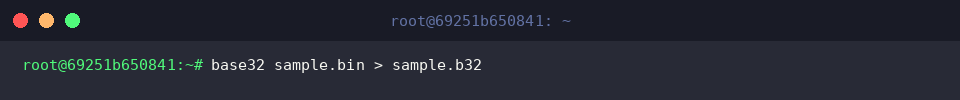
生成したバイナリを base32 に投入し、変換結果を sample.b32 に保存します。
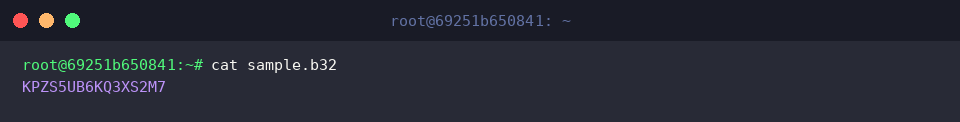
Base32は5バイト(40ビット)を8文字で表現する構造のため、10バイトというサイズは端数が出ず、末尾パディング記号(=)を含まないすっきりとした出力が得られます。
保存された sample.b32 の内容を画面に出力し、パディングの有無や文字列の状態をチェックします。
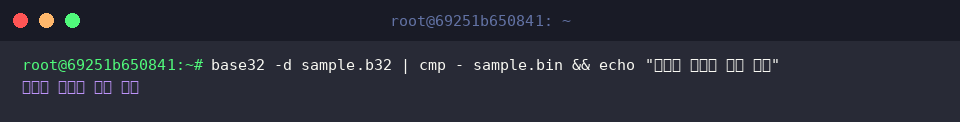
最後に、逆変換したデータが元ファイルとビット単位で完全一致するかを検証します。base32 -d からの出力をパイプ経由で cmp コマンドに渡し、sample.bin と比較させます。
相違がない場合に && 以降のメッセージを表示させることで、データ欠損のない確実な復元を確認できます。
以上、Ubuntuにおける base32 コマンドの基本操作から、テキスト・バイナリ双方の変換テクニック、データの整合性検証までを解説しました。
プロトコルの制約などで生じる文字化けやデータ破損を防ぎたい場面で、確実なデータ退避・転送手段としてぜひ活用してください。