


概要
Linuxサーバーの運用管理やトラブルシューティングにおいて、巨大なアクセスログやCSVファイルから必要な情報だけを素早く抜き出す作業は日常茶飯事です。こうしたテキストパースに威力を発揮するのが標準ユーティリティの cut コマンドです。本稿ではUbuntu環境をベースに、デリミタの指定、特定列の切り出し、文字・バイト単位のスライシングなど、実務で即座に役立つ主要オプションの活用法をハンズオン形式で詳解します。
実習環境のセットアップと検証用データセットの生成
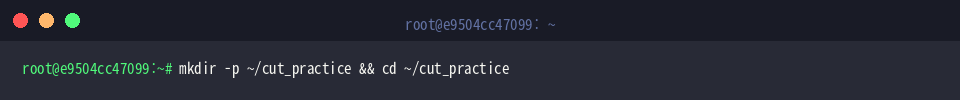
作業環境を汚さないよう、まずは検証用の専用ディレクトリを立ち上げてカレントディレクトリを移動します。ターミナルで mkdir -p ~/cut_practice && cd ~/cut_practice を実行しましょう。
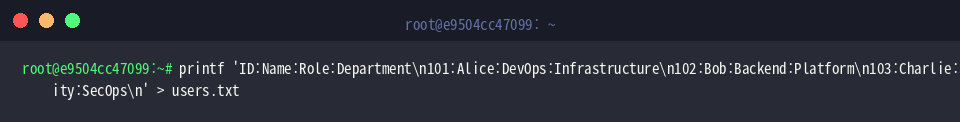
最初に、コロン(:)で区切られたユーザーアカウント情報を模したデータファイル users.txt を printf コマンドを使って作成します。
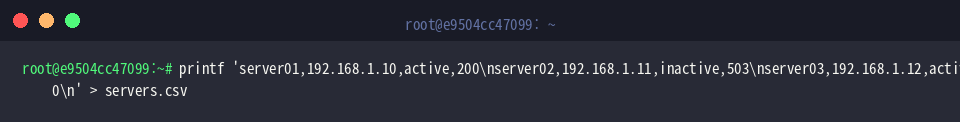
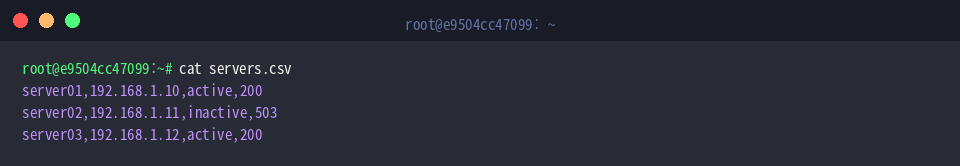
続いて、カンマ区切りの一般的なCSVフォーマットを想定し、サーバー接続状態を模した servers.csv ファイルを同様に準備します。
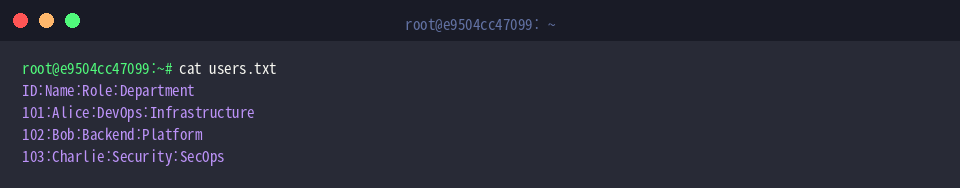
作成された users.txt の内容を cat users.txt で表示し、コロン区切りのヘッダー行および各レコードが正しく書き込まれているか確かめます。
同様に cat servers.csv を叩き、サーバー名やIPアドレス、ステータス値がカンマ区切りで意図通りに記録されていることを確認しておきます。
デリミタ(-d)とフィールド(-f)による特定カラムの抽出
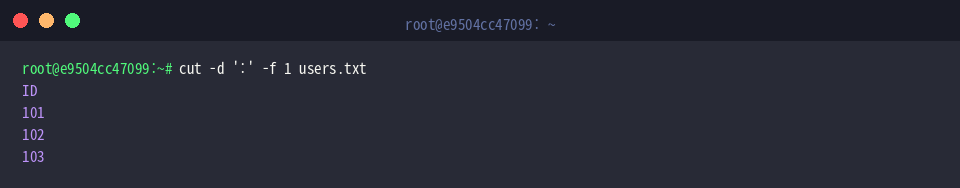
users.txt から先頭の列だけを取得したい場合は、cut -d ':' -f 1 users.txt を実行します。-d ':' で分割キーとなるコロンを指定し、-f 1 によって1番目のフィールドをターゲティングすることで、アカウントの ID リストのみを素早くフィルタリングできます。
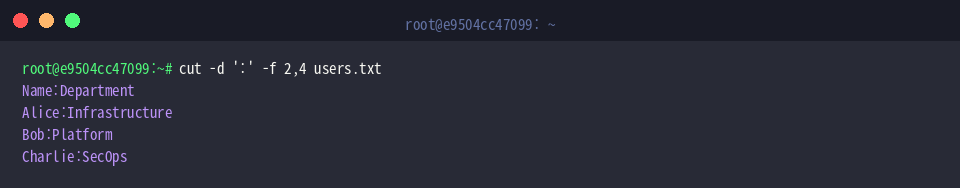
離れた位置にある複数の列を同時に取り出したいときは、カンマ区切りで列番号を列挙します。cut -d ':' -f 2,4 users.txt を走らせてみましょう。
これにより、第2フィールドの氏名と第4フィールドの部署名が元のデリミタを維持した状態で一括抽出されます。
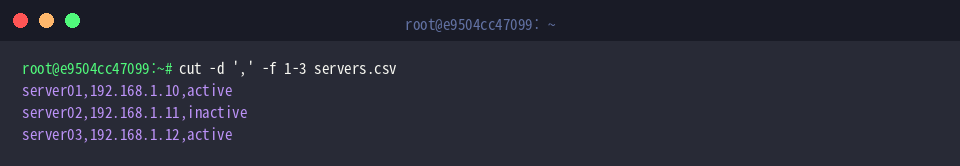
連続した範囲の列群をまとめて取得する際は、ハイフン(-)によるレンジ指定が便利です。cut -d ',' -f 1-3 servers.csv を実行します。
デリミタにカンマを指定しつつ -f 1-3 を与えることで、ホスト名からIPアドレス、稼働状態まで(1〜3列目)を効率的に抜き出すことが可能です。
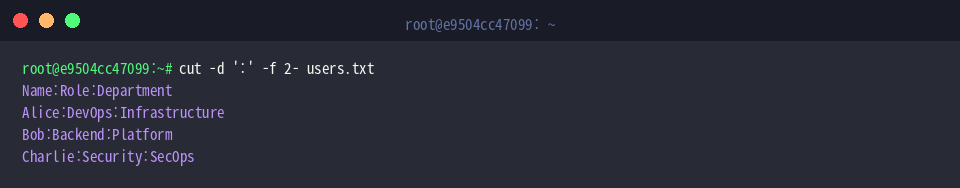
「特定列以降の全データが欲しい」というケースでは、終了番号を省略する記法が活躍します。cut -d ':' -f 2- users.txt を実行してみましょう。-f 2- と記述することで、先頭の ID 列だけを除外した第2列から末尾までの全情報(役職や所属含む)が一挙にリストアップされます。
文字数(-c)およびバイト(-b)指定による固定幅データのスライシング
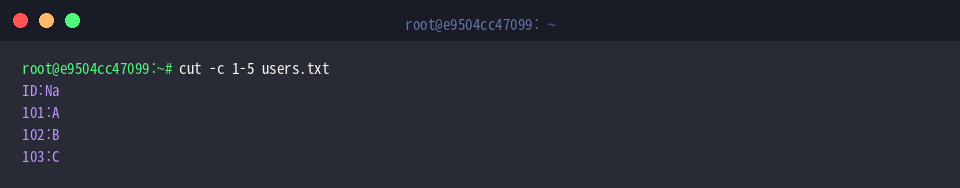
区切り文字が存在しない固定長レコードやフォーマット済みテキストを扱うには、文字単位の指定が最適です。cut -c 1-5 users.txt を実行します。-c 1-5 オプションを付与することで、デリミタの有無にかかわらず各行の1文字目から5文字目までの文字列がきれいに切り出されます。
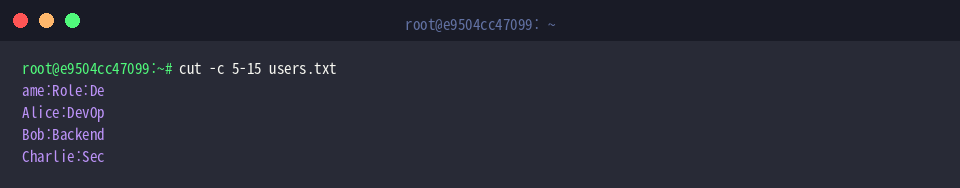
行の中間部分に位置する文字列をピンポイントで切り出したい場合は、開始と終了のインデックスを明示します。cut -c 5-15 users.txt を実行してみます。-c 5-15 の指定により、各行の5文字目から15文字目の範囲に収まる部分文字列だけが画面に出力されます。
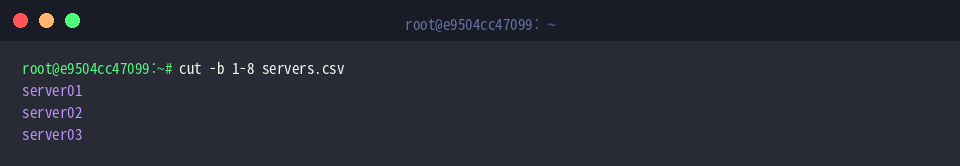
ネットワークパケットのヘッダー解析やマルチバイトが混在しない英数字データでは、バイトサイズでの制御も重宝します。cut -b 1-8 servers.csv を入力します。-b 1-8 で1〜8バイト目の領域を切り分けることで、行頭に配置されたホスト名プレフィックスのみを均一な幅で抽出できます。
出力デリミタの置換と特定フィールドの反転除外(–complement)
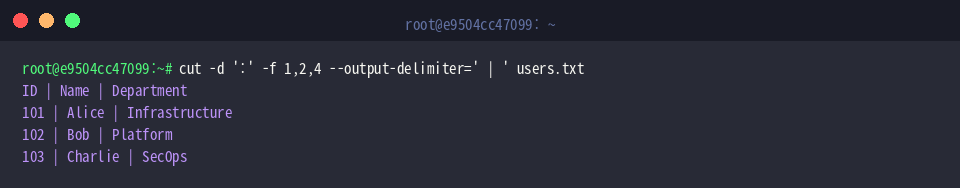
切り出したテキストの可読性を高めるため、出力時の区切り文字を別の記号に差し替えることができます。cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt を実行してみましょう。--output-delimiter=' | ' を付与することで、入力データのコロン(:)がパイプ記号(|)に変換され、レポートや一覧表として見やすい形式へ瞬時に整形されます。
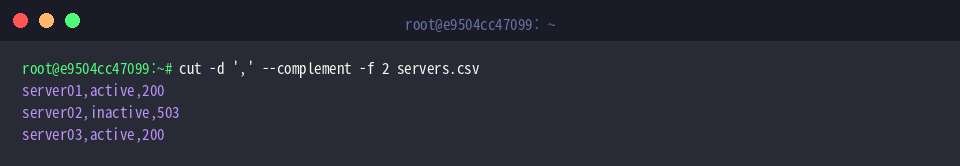
多数のカラムから「特定の1列だけを省いて残りをすべて保持したい」場合は、反転抽出を行う --complement フラグが威力を発揮します。cut -d ',' --complement -f 2 servers.csv を実行します。-f 2 で指定したIPアドレス列のみが反転マスクされて除外され、1列目・3列目・4列目の値がそのまま残されて出力されます。
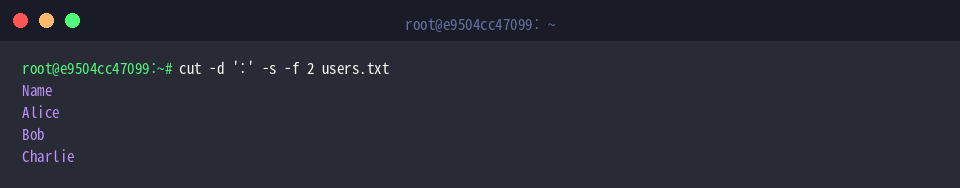
非構造化テキストや区切り文字を含まない不正な行が混在しているファイルでは、-s(--only-delimited)オプションが不可欠です。cut -d ':' -s -f 2 users.txt を実行します。
このフラグを併用すると、指定したデリミタ(:)を持たないノイズ行が自動的にスキップされ、正しい書式を持つ行の該当フィールドだけを安全に取り込めます。
Ubuntu環境における cut コマンドの代表的な使い方と、実践で役立つパラメータ群を整理してご紹介しました。
パイプライン処理やシェルスクリプトに組み込むことで、重厚なスクリプト言語を起動せずとも高速・軽量にテキスト処理を完結させることができます。ログ調査やデータバッチ処理の効率化にぜひお役立てください。