


개요
리눅스 환경에서 대용량 로그나 정형 텍스트 데이터를 처리할 때 cut 명령어는 필수적인 도구입니다. 본 가이드에서는 구분자, 필드, 바이트, 문자 단위 추출 등 cut의 핵심 옵션을 우분투 환경에서 실습과 함께 살펴봅니다.
cut 실습 환경 및 샘플 데이터셋 준비
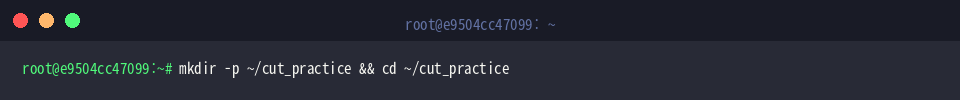
cut 명령어 실습을 안전하게 진행할 전용 디렉터리를 생성하고 해당 위치로 이동하기 위해 mkdir -p ~/cut_practice && cd ~/cut_practice 명령어를 실행합니다.
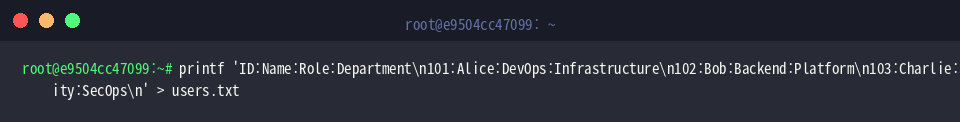
콜론(:) 구분자 기반의 필드 추출 실습에 활용할 사용자 목록 데이터를 구성하기 위해 printf 명령어로 users.txt 파일을 생성합니다.
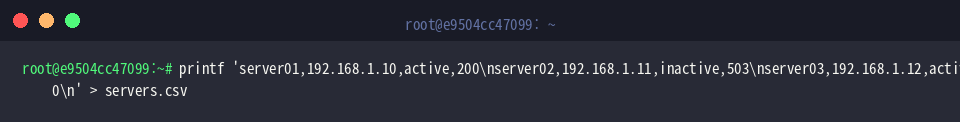
쉼표(,)를 구분자로 사용하는 CSV 형식의 텍스트 추출 실습을 위해 서버 접속 상태가 기록된 servers.csv 파일을 생성합니다.
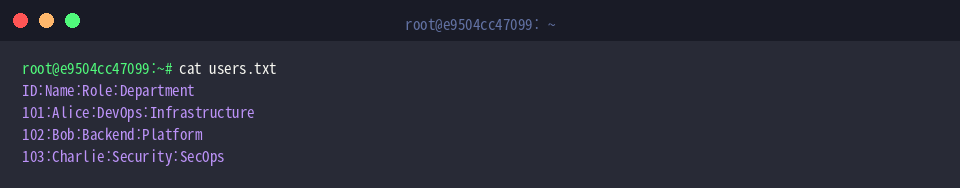
생성된 users.txt 파일에 헤더와 각 사용자 계정 정보가 지정한 구분자(:) 형식에 맞게 저장되었는지 확인하기 위해 cat users.txt 명령어를 실행합니다.
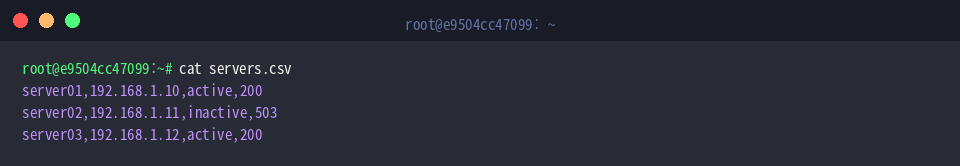
생성된 servers.csv 파일의 서버 정보 및 상태 코드가 쉼표(,) 단위로 정상 기록되었는지 확인하기 위해 cat servers.csv 명령어를 실행합니다.
구분자(-d)와 필드(-f)를 활용한 특정 열 추출
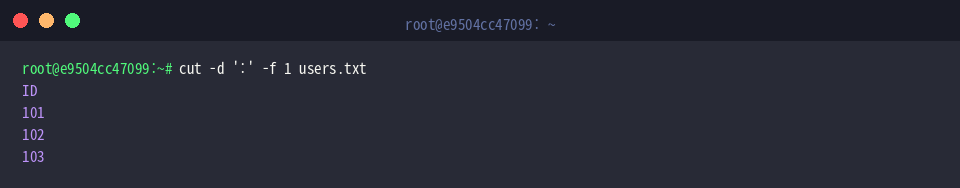
users.txt 파일에서 콜론(:) 구분자를 기준으로 첫 번째 열만 추출하기 위해 cut -d ':' -f 1 users.txt 명령어를 실행합니다.-d ':' 옵션으로 콜론을 구분자로 지정하고 -f 1 옵션으로 첫 번째 필드를 선택하여 각 계정의 ID 목록만 깔끔하게 출력합니다.
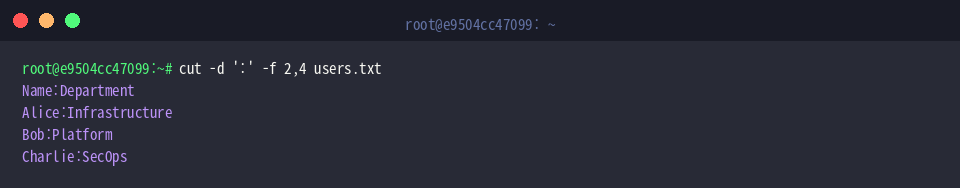
쉼표(,)를 활용해 원하는 특정 열들을 동시에 선택 추출하기 위해 cut -d ':' -f 2,4 users.txt 명령어를 실행합니다.
2번째 필드인 사용자 이름과 4번째 필드인 소속 부서 열만 선별되어 기존 구분자와 함께 표시됩니다.
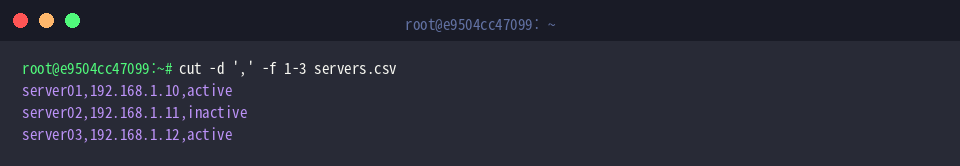
하이픈(-)을 이용해 연속된 열 범위를 한 번에 지정하여 추출하기 위해 cut -d ',' -f 1-3 servers.csv 명령어를 실행합니다.-d ',' 옵션으로 쉼표를 구분자로 지정하고 -f 1-3 옵션을 적용하여 서버 이름, IP 주소, 상태 정보가 위치한 1번부터 3번 열까지의 데이터를 추출합니다.
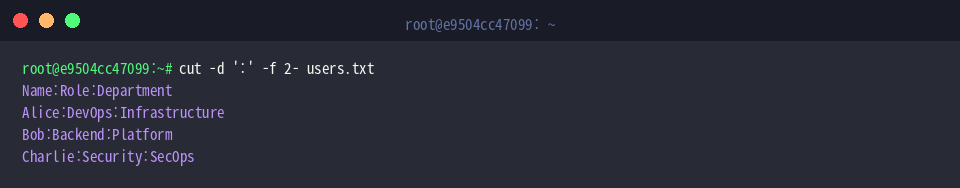
특정 열부터 해당 행의 끝까지 모든 데이터를 가져오기 위해 cut -d ':' -f 2- users.txt 명령어를 실행합니다.-f 2- 옵션을 통해 2번째 열부터 마지막 열까지의 전체 구간이 지정되어, 첫 번째 ID 열을 제외한 이름, 역할, 부서 정보가 모두 출력됩니다.
문자(-c) 및 바이트(-b) 단위를 이용한 고정폭 데이터 슬라이싱
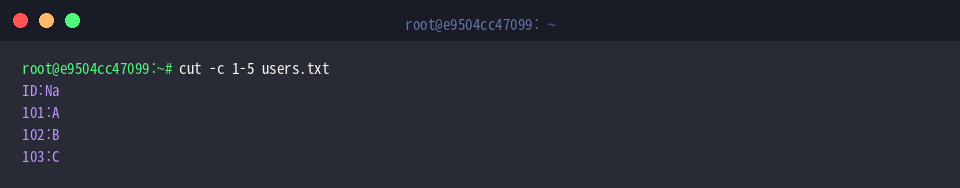
users.txt 파일의 각 행에서 1번째 문자부터 5번째 문자까지의 구간을 추출하기 위해 cut -c 1-5 users.txt 명령어를 실행합니다.-c 1-5 옵션을 적용하여 구분자 없이 고정된 문자 단위로 1~5번째 위치의 문자열만 잘라내어 출력합니다.
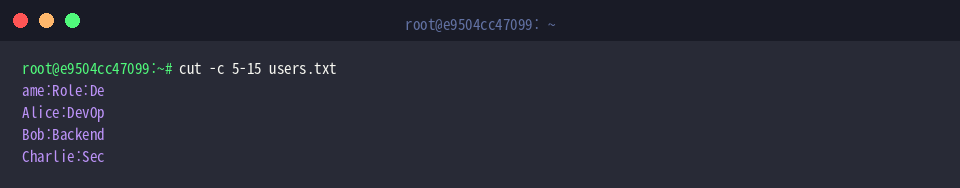
문자열의 중간에 위치한 특정 범위를 지정하여 추출하기 위해 cut -c 5-15 users.txt 명령어를 실행합니다.-c 5-15 옵션을 통해 5번째 문자부터 15번째 문자까지의 구간에 해당하는 텍스트만 선별하여 표시합니다.
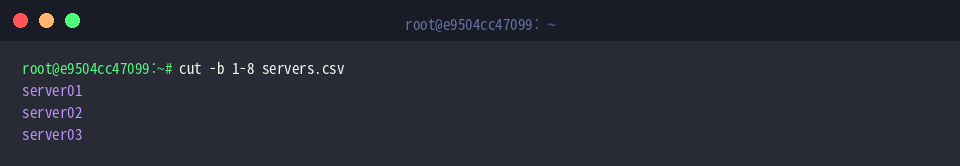
servers.csv 파일에서 바이트(byte) 크기를 기준으로 고정폭 데이터를 슬라이싱하기 위해 cut -b 1-8 servers.csv 명령어를 실행합니다.-b 1-8 옵션으로 1바이트부터 8바이트까지의 범위를 지정하여 각 행의 앞부분에 위치한 서버 식별자만 깔끔하게 추출합니다.
출력 구분자 변경 및 특정 필드 제외(–complement) 고급 옵션
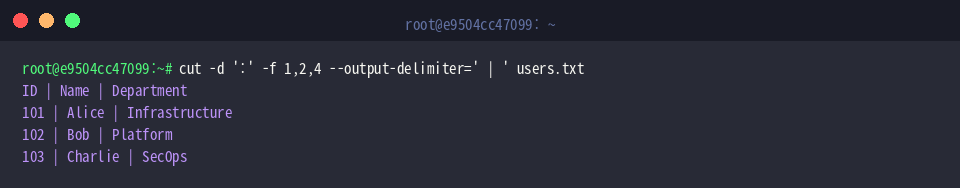
users.txt 파일에서 1, 2, 4번째 필드를 추출하면서 필드 간 구분자를 변경하기 위해 cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt 명령어를 실행합니다.--output-delimiter=' | ' 옵션을 적용하여 기존 콜론(:) 대신 파이프 기호(|)를 출력 구분자로 대체함으로써 데이터의 가독성을 높여 출력합니다.
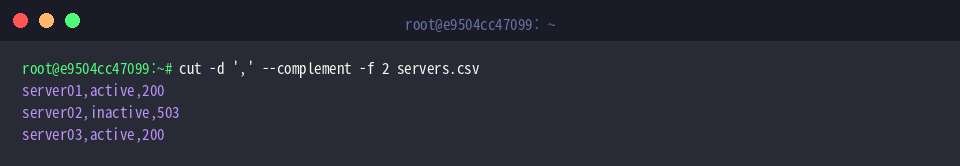
선택한 특정 필드만 제외하고 나머지 모든 필드를 반전하여 추출하기 위해 cut -d ',' --complement -f 2 servers.csv 명령어를 실행합니다.--complement 옵션을 사용하면 -f 2로 지정한 2번째 열만 역으로 제거되고, 나머지 1번째, 3번째, 4번째 열의 데이터만 남겨서 출력합니다.
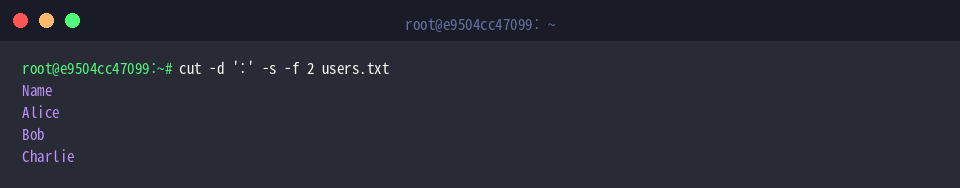
구분자가 포함되지 않은 행을 자동으로 걸러내고 원하는 필드만 추출하기 위해 cut -d ':' -s -f 2 users.txt 명령어를 실행합니다.-s(--only-delimited) 옵션을 함께 지정하면 지정한 구분자(:)가 없는 줄은 건너뛰고 유효한 형식의 행에서만 2번째 열인 이름 데이터를 가져옵니다.
지금까지 우분투 환경에서 cut 명령어의 다양한 옵션과 실무에 유용한 텍스트 데이터 추출 방법을 간단하게 정리해보았습니다.
알려드린 옵션들을 상황에 맞게 활용하여 로그 분석 및 셸 스크립트 작업의 효율을 높여보시길 바랍니다.