


Visão Geral
No ambiente Linux, o awk é a ferramenta mais poderosa para manipular e filtrar arquivos de texto volumosos ou dados de logs com eficiência. Sem a necessidade de escrever scripts complexos, aprenda a sintaxe fundamental e o uso prático para extrair colunas específicas, aplicar filtros condicionais e até somar dados com comandos de apenas uma linha.
1. Princípios Básicos de Funcionamento do awk e Extração de Colunas Específicas
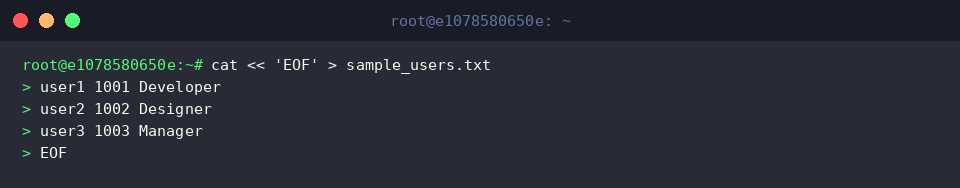
Para a prática com o comando awk, criamos um arquivo de texto de exemplo contendo nome de usuário, ID e cargo separados por espaço.
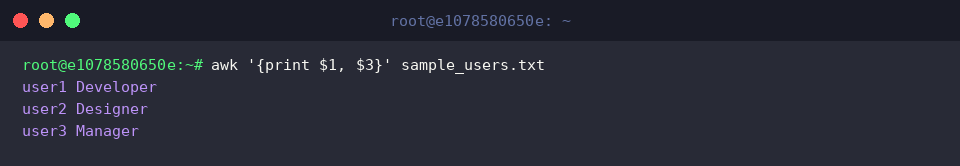
Usando o comando awk, extraímos e exibimos o primeiro campo ($1), que é o nome de usuário, e o terceiro campo ($3), que é o cargo, a partir de cada linha do arquivo, utilizando o espaço como delimitador.
Por padrão, se nenhum delimitador for especificado, o awk divide os campos com base em sequências de espaços ou tabulações.
⚙️ [Principais Opções]
-F fs : Especifica o delimitador de campos de entrada (Field Separator).-v var=val : Atribui uma variável e seu valor inicial para uso dentro do script awk antes da execução.-f progfile : Especifica o caminho do arquivo onde o código do script awk a ser executado está escrito.
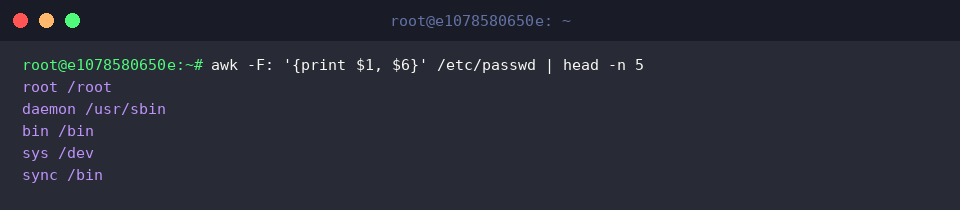
No arquivo /etc/passwd delimitado por dois-pontos (:), especificamos o separador com a opção -F: e extraímos apenas o primeiro campo ($1), o nome da conta, e o sexto campo ($6), o caminho do diretório home, verificando as 5 primeiras linhas.
2. Filtragem de Dados Personalizada Usando Condicionais e Operadores
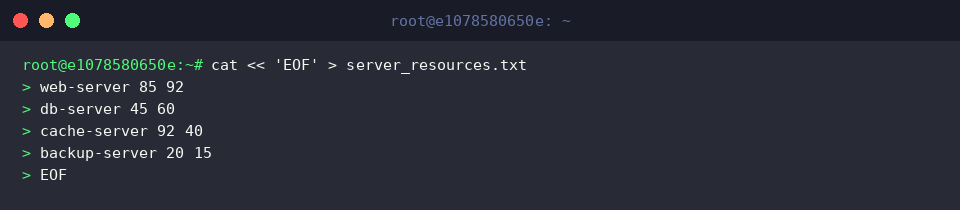
Criamos o arquivo de treino server_resources.txt, contendo dados de utilização de CPU e memória por servidor.
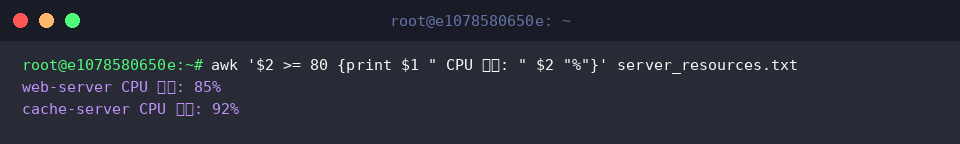
Filtramos através de uma expressão condicional os alvos cujo segundo campo ($2), o uso de CPU, é de 80% ou superior, exibindo o nome do servidor correspondente e uma mensagem de aviso.
Isso é muito útil para identificar recursos do sistema que ultrapassaram o limite definido.
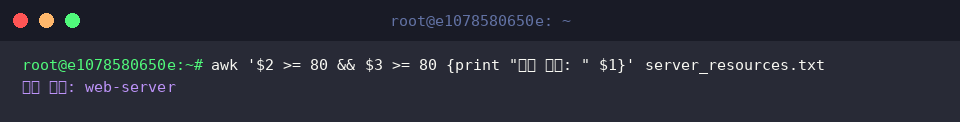
Utilizando o operador lógico E (&&), identificamos e exibimos os servidores em estado crítico cujo uso de CPU ($2) e memória ($3) seja simultaneamente de 80% ou mais.
Ao aplicar condições compostas, é possível isolar apenas os alvos onde múltiplos recursos excederam os limites ao mesmo tempo.
3. Estatísticas e Somatórios Utilizando Variáveis Embutidas e Blocos BEGIN/END
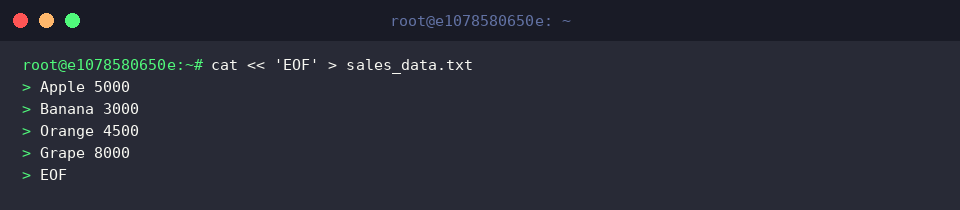
Para realizar práticas de agregação de dados e estatísticas com o awk, criamos o arquivo de exemplo sales_data.txt contendo o nome do item e o valor das vendas.
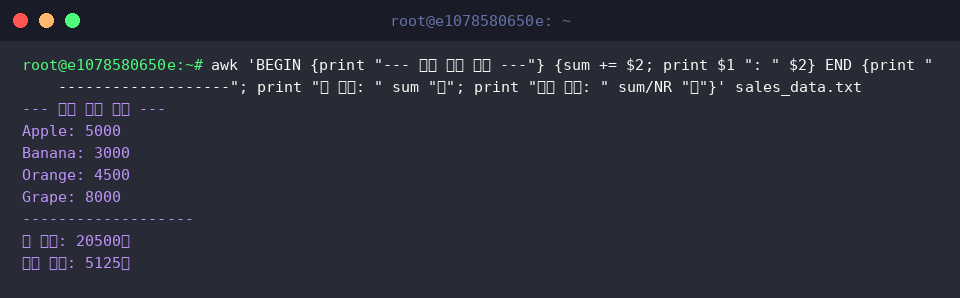
Com o bloco BEGIN, exibimos uma mensagem introdutória antes de processar o corpo do texto e acumulamos a soma dos valores do segundo campo ($2) de cada linha na variável sum.
No bloco END, executado após o término do processamento de todas as linhas do arquivo, calculamos e exibimos o total de vendas e a média de vendas utilizando a variável interna NR (número total de registros).
4. Análise Prática de Logs de Servidor Web e Filtragem de Tráfego Anômalo
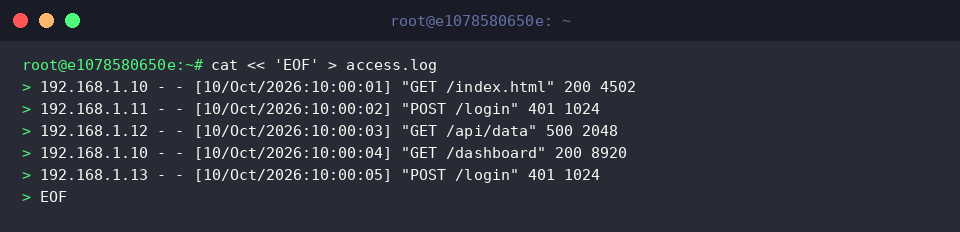
Para conduzir a prática de análise de logs de servidor web e rastreamento de erros, criamos um arquivo de log de exemplo access.log no formato padrão do Nginx e Apache.
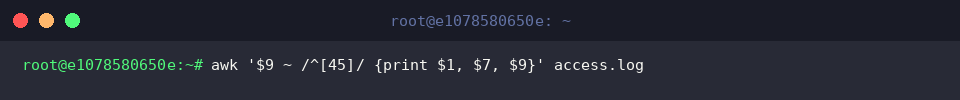
Utilizando o operador de correspondência de expressão regular (~), filtramos as linhas de erros de cliente 4xx e erros de servidor 5xx, onde o nono campo ($9), correspondente ao código de status HTTP, começa com 4 ou 5.
A partir dos logs que atendem à condição, extraímos apenas o IP de acesso ($1), a URI da requisição ($7) e o código de status ($9), verificando rapidamente a ocorrência de falhas e tráfego anormal.
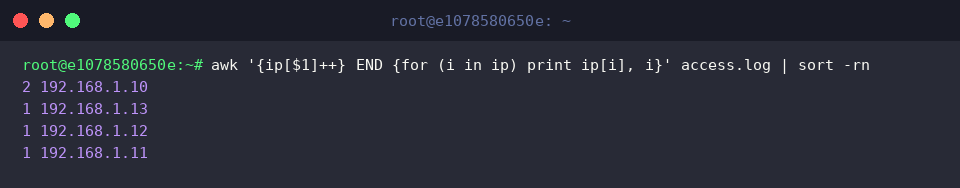
Utilizando um array associativo do awk (ip[$1]++), contabilizamos a quantidade de requisições por IP de acesso. Em seguida, com o laço de repetição no bloco END, exibimos o total acumulado e ordenamos em ordem decrescente de frequência de requisições através do pipeline com sort -rn.
Esta é uma técnica prática de análise para identificar tráfego excessivo ou tentativas anormais de acesso provenientes de um IP específico.
Até aqui, exploramos de forma breve a sintaxe básica e os principais exemplos práticos do comando awk, que facilita o processamento de texto e a análise de grandes volumes de logs no ambiente Linux.
Aplique diretamente em suas atividades diárias as diversas opções e padrões apresentados hoje para automatizar e tornar ainda mais eficientes suas tarefas repetitivas de extração e manipulação de dados.