


Visão Geral
Lidar com caracteres corrompidos em arquivos de texto e relatórios de log é um dos desafios mais rotineiros na administração de sistemas Linux. Para remediar qualquer falha de exibição com segurança, identificar a codificação exata da fonte de dados é um pré-requisito indispensável. Neste guia prático, exploramos a ferramenta chardetect, cobrindo desde o processo de instalação e configuração inicial até técnicas de inspeção individual, processamento em lote via terminal e conversão direta de formatos legados.
Instalação e Preparação do Ambiente com chardetect
Para disponibilizar o utilitário em distribuições baseadas em Debian e Ubuntu, sincronizamos a lista de repositórios do sistema e instalamos o pacote python3-chardet:
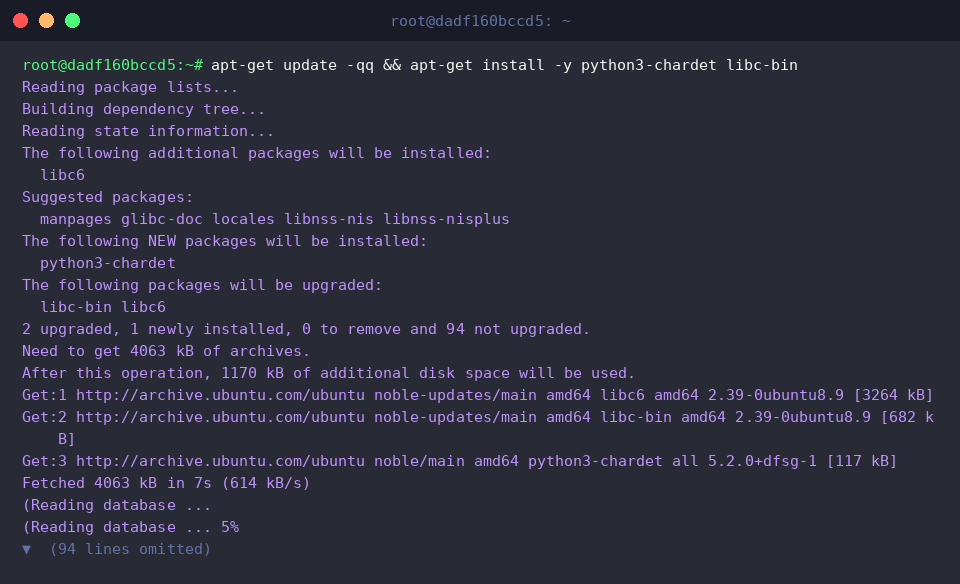
A ferramenta chardetect analisa streams de dados ou arquivos no disco, reportando o conjunto de caracteres identificado juntamente com a pontuação de precisão probabilística do diagnóstico.
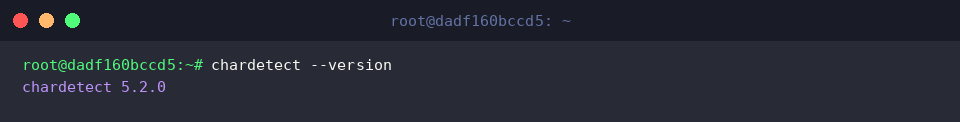
Para checar a integridade do binário e verificar a versão em uso, emprega-se o parâmetro --version.
⚙️ [Opções Principais de Execução]
-l, --line-per-line : Efetua o diagnóstico linha a linha de forma individual, indicado para documentos que misturam múltiplos padrões.--minimal : Omite os índices estatísticos de precisão, exibindo unicamente o identificador do charset.-h, --help : Lista os parâmetros de auxílio e as instruções sumárias de uso.--version : Apresenta os dados de versão do software e interrompe o processo.
Criação de Cenários de Teste e Inspeção de Múltiplos Formatos
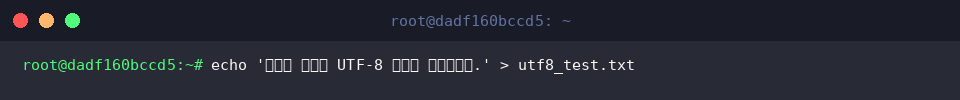
Para conduzir os ensaios práticos de identificação de charset, utilizamos o comando echo para estruturar um arquivo inicial codificado nativamente em UTF-8, denominado utf8_test.txt:
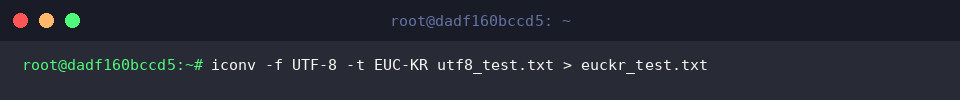
Com o objetivo de comparar diferentes comportamentos de charset, recorremos ao comando iconv para converter a matriz UTF-8 no padrão legado asiático EUC-KR, gerando o arquivo euckr_test.txt:
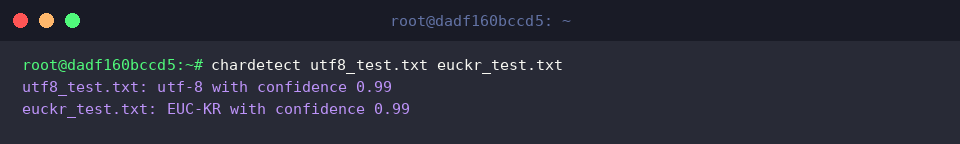
Ao passar os arquivos em lote como parâmetros diretos para o chardetect, a ferramenta processa as assinaturas de bytes de cada documento.
O relatório terminal indica com precisão que utf8_test.txt adota UTF-8 e euckr_test.txt corresponde a EUC-KR, ambos alcançando uma expressiva taxa de 99% de confiabilidade analítica.
Processamento via Pipelines e Análise de Logs em Lote
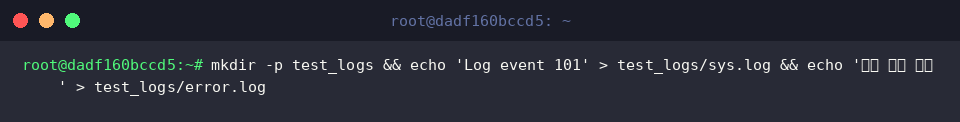
Em rotinas de monitoramento em servidores, a análise frequente de múltiplos arquivos de log exige agilidade. Estruturamos um ambiente simulado através da instrução mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log para criar registros operacionais e mensagens de erro:
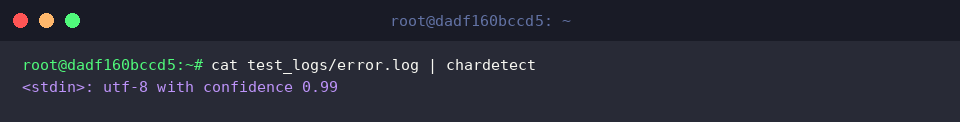
A flexibilidade dos pipelines Unix permite canalizar fluxos diretamente ao chardetect usando cat e o operador de pipe (|).
O utilitário trata a entrada dinâmica sob a referência <stdin>, identificando corretamente o padrão UTF-8 com 99% de assertividade:
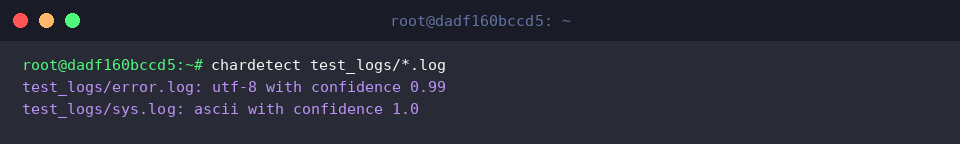
O uso de caracteres curinga (*) permite auditar simultaneamente todos os arquivos dentro do diretório test_logs.
O processamento discrimina com perfeição que o documento multilíngue error.log utiliza UTF-8, enquanto o arquivo puramente alfanumérico sys.log é enquadrado como ASCII:
Mecânica Interna e Fluxo de Recuperação com iconv
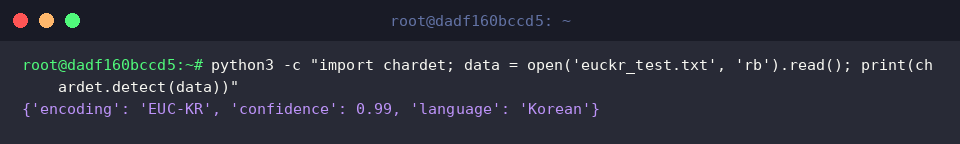
No núcleo do CLI, o motor em Python analisa sequências de bytes e distribuições de frequência de caracteres. Ao invocar o módulo chardet diretamente no interpretador, obtemos a estrutura bruta dos metadados da heurística — contendo o padrão de codificação (EUC-KR), o índice estatístico (0.99) e a língua associada (Korean):
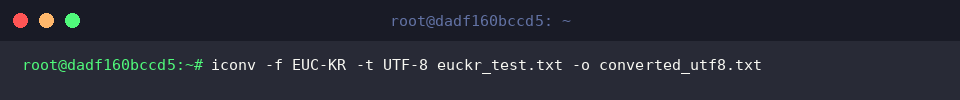
Munido do diagnóstico correto do charset original, utilizamos o utilitário iconv para migrar o conteúdo legado de euckr_test.txt para um arquivo devidamente normalizado em UTF-8 chamado converted_utf8.txt.
Definindo a fonte com a flag -f EUC-KR e o destino com -t UTF-8, os caracteres são transcodificados sem qualquer tipo de quebra ou perda de integridade:
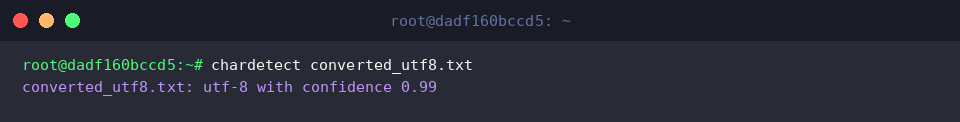
Como etapa final de verificação, reavaliamos o arquivo gerado converted_utf8.txt com o chardetect.
A checagem certifica que o formato foi integralmente transformado em UTF-8 com 99% de certeza estatística:
Dominar o diagnóstico de codificações no Linux com o chardetect elimina incertezas no tratamento de arquivos legados ou corrompidos, estabelecendo fluxos de trabalho rápidos e livres de erros de charset. Inclua este utilitário no seu kit de ferramentas de administração para solucionar conflitos de texto com rapidez e precisão técnica.