


Introdução Prática ao csplit
Ao manipular arquivos textuais extensos ou conjuntos volumosos de logs no ecossistema Linux, frequentemente surge a necessidade de fragmentar dados a partir de contextos específicos ou contagens pontuais de linhas. Diferentemente do utilitário split, que atua de forma estática por blocos pré-fixados de bytes ou linhas, o comando csplit (context split) se destaca pela capacidade de executar cortes refinados baseados em expressões regulares. Este tutorial explora as diretrizes operacionais essenciais do csplit por meio de simulações práticas voltadas para a administração de sistemas.
Segmentação de Arquivos com Base em Linhas Específicas
Para estruturar um espaço isolado e garantir a rastreabilidade dos testes, inicializamos um diretório dedicado utilizando o comando mkdir -p ~/csplit_lab && cd ~/csplit_lab.
Em seguida, sintetizamos um arquivo de texto com quinze registros de monitoramento simulado executando seq -f "Line %g: System status normal" 1 15 > server_status.txt.
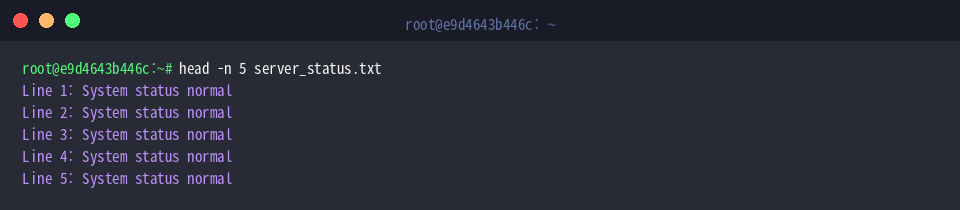
A validação da integridade das primeiras entradas da base recém-criada é realizada com a execução de head -n 5 server_status.txt.
O utilitário csplit processa o particionamento orientando-se por números de linhas estáticos ou demarcações conceituais.
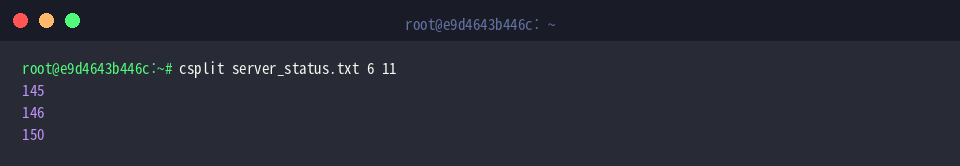
Ao aplicar csplit server_status.txt 6 11, determinamos que as quebras estruturais ocorram exatamente nos índices 6 e 11, resultando em três blocos independentes: linhas de 1 a 5, de 6 a 10 e de 11 a 15.
Os valores numéricos retornados no console informam o volume individual em bytes alocado em cada arquivo resultante.
⚙️ [Parâmetros Fundamentais]
-f PREFIX : Substitui o prefixo padrão dos arquivos gerados (xx) pela sequência de caracteres informada.-b FORMAT : Aplica um formato de numeração customizado no sufixo utilizando regras de formatação printf.-n DIGITS : Especifica a quantidade de casas decimais no índice numérico dos arquivos (o padrão é 2).-s : Modo silencioso que inibe o envio do relatório de bytes gerados para a saída do terminal.-z : Suprime e descarta automaticamente qualquer arquivo de saída cujo tamanho resultante seja zero byte.-k : Garante que os fragmentos já persistidos sejam preservados em disco caso um erro interrompa o processo.
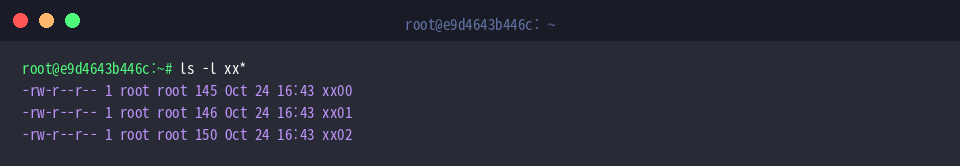
Para auditar os elementos gerados após o particionamento, acionamos ls -l xx*.
Constata-se a criação íntegra dos artefatos xx00, xx01 e xx02, devidamente estruturados e obedecendo às métricas de bytes pré-calculadas.
Divisão Dinâmica por Expressões Regulares e Padrões
Em cenários reais de análise de infraestrutura, relatórios multifuncionais frequentemente agregam diversas seções em um mesmo relatório consolidado. Geramos um modelo dessa estrutura executando cat << 'EOF' > reports.txt.
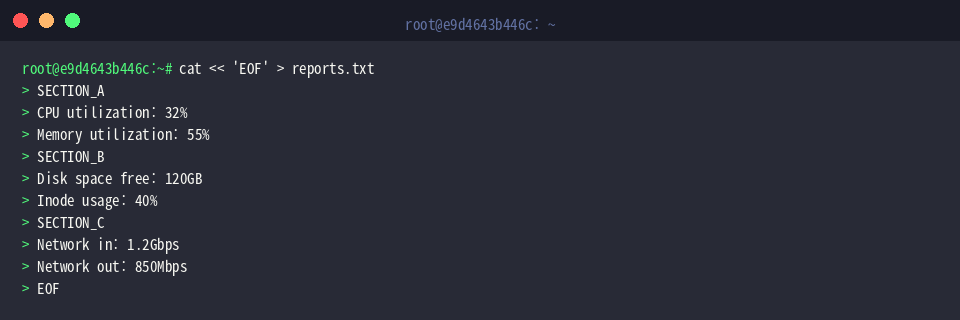
Inspecionamos a composição integral dos dados gerados por meio do comando cat reports.txt.
O terminal exibe os grupos segmentados sob os identificadores SECTION_A, SECTION_B e SECTION_C.
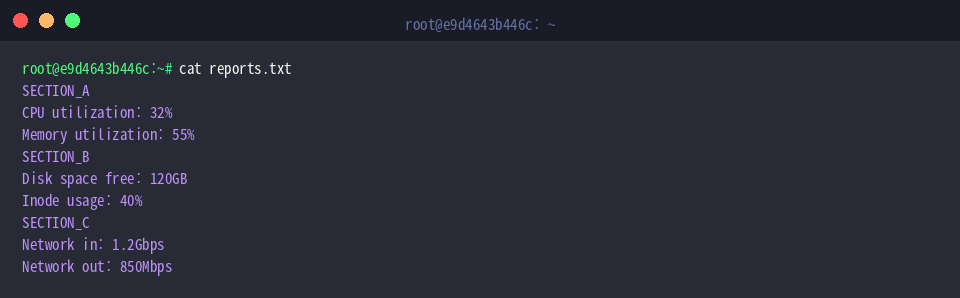
Ao emitir o comando csplit reports.txt '/SECTION_/' '{*}', orientamos o interpretador a fatiar o documento onde quer que o padrão regex /SECTION_/ seja localizado. O modificador recursivo { * } propaga essa regra consecutivamente até o término do arquivo.
A saída exibe a contagem de bytes correspondente a cada fatia gerada, incluindo o segmento preliminar ao primeiro padrão correspondido (registrado com 0 bytes).
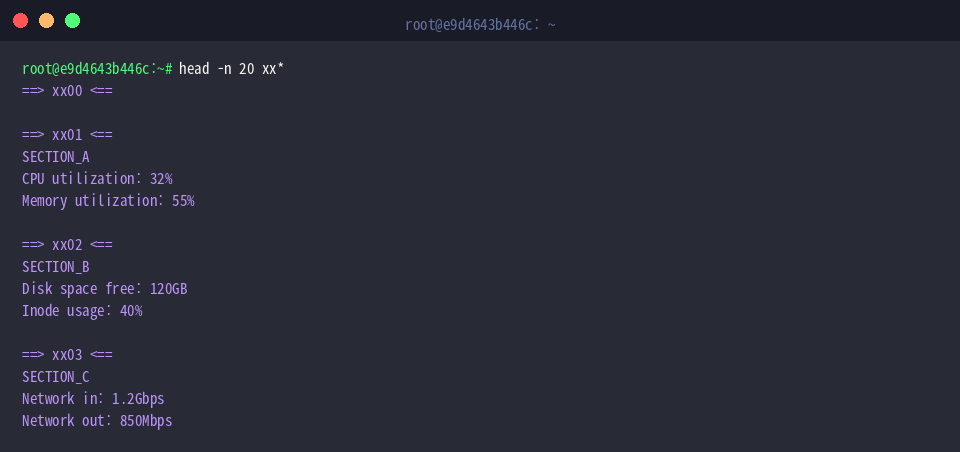
Para averiguar a distribuição dos blocos processados, examinamos os arquivos resultantes executando head -n 20 xx*.
Observa-se que xx00 abriga o intervalo vazio pré-busca, enquanto xx01, xx02 e xx03 retêm fielmente o escopo e o conteúdo de cada seção mapeada.
Customizando Prefixos e Contadores Numéricos nos Arquivos
Durante o rastreamento operacional de falhas, classificar eventos de acordo com categorias estruturadas agiliza as rotinas de triagem. Para esse teste, montamos um arquivo de log sintetizado via cat << 'EOF' > app.log.
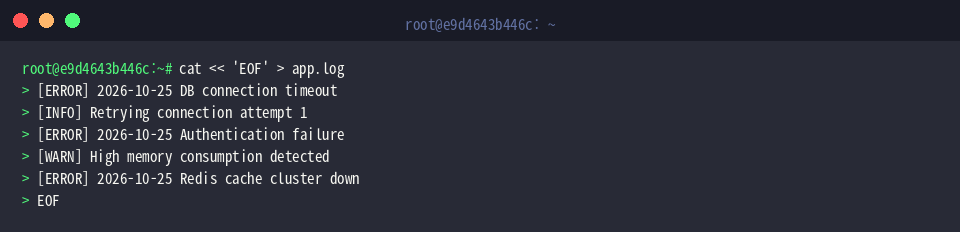
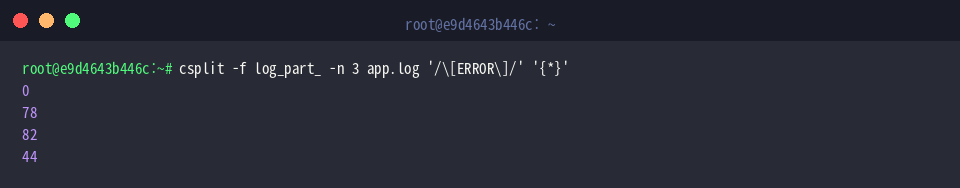
A instrução csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}' segmenta o fluxo textual tendo como demarcação o padrão de erro [ERROR]. Aplicamos simultaneamente o parâmetro -f log_part_ para redefinir o prefixo base e -n 3 para ampliar o índice numérico sequencial para três dígitos inteiros.
O relatório textual subsequente exibe a volumetria em bytes gerada em cada segmento de log.
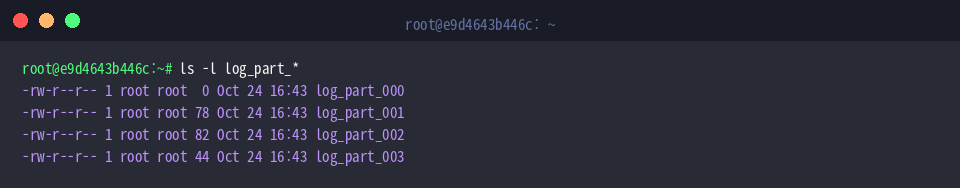
Confirmamos a formatação dos novos fragmentos no sistema de arquivos por meio de ls -l log_part_*.
A listagem revela a presença ordenada dos arquivos log_part_000 a log_part_003, atendendo exatamente à padronização de nomenclatura configurada.
Otimização Prática: Supressão de Arquivos Vazios (-z) e Resiliência (-k)
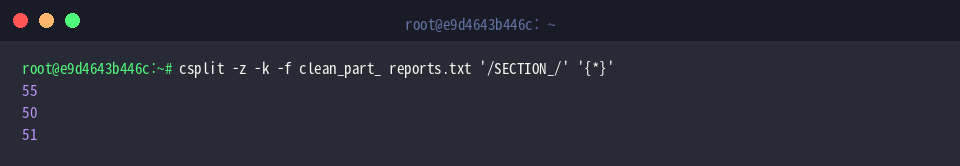
O comando csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' combina dois modificadores indispensáveis para automações seguras: a opção -z inibe a produção de arquivos nulos de 0 bytes, enquanto o parâmetro -k previne a exclusão dos fragmentos já gravados caso ocorra uma falha imprevista durante o particionamento.
Com o descarte antecipado do fragmento nulo inicial, o terminal exibe estritamente as dimensões úteis dos três blocos verdadeiramente extraídos (55, 50 e 51 bytes).
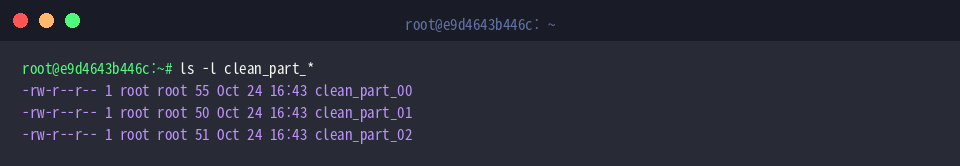
Inspecionamos os arquivos resultantes por meio de ls -l clean_part_*.
Graças à atuação do sinalizador -z, não há criação residual de arquivos vazios; apenas os três fragmentos consistentes (clean_part_00, clean_part_01 e clean_part_02) constam no diretório.
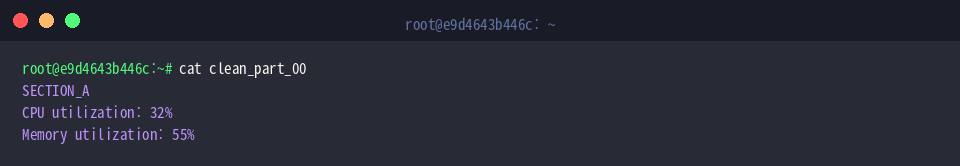
Para certificar que o ponto inicial do primeiro segmento foi capturado perfeitamente, executamos cat clean_part_00.
Com a supressão do cabeçalho nulo, clean_part_00 inicializa imediatamente com os registros pertinentes da SECTION_A sem desvios de contexto.
Por fim, desfazemos os artefatos temporários e limpamos o espaço de testes por meio do comando rm -rf ~/csplit_lab.
A incorporação do utilitário csplit ao repertório de administração em Linux viabiliza a dissecção programática de bases de dados textuais e arquivos de log por meio de critérios contextuais. Essa flexibilidade regex transforma rotinas de pré-processamento e extração de dados em fluxos ágeis, robustos e altamente eficientes.