


Visão Geral
No ecossistema Linux, processar fluxos massivos de logs ou manipular estruturas tabulares exige ferramentas rápidas e eficientes. O utilitário cut destaca-se como uma das soluções mais ágeis para segmentar fluxos de texto com base em delimitadores, posições de colunas, contagem de caracteres ou bytes. Neste tutorial prático voltado ao Ubuntu, exploramos os parâmetros fundamentais dessa ferramenta por meio de casos reais do cotidiano de administração de sistemas.
Preparação do Laboratório e Criação dos Dados de Teste
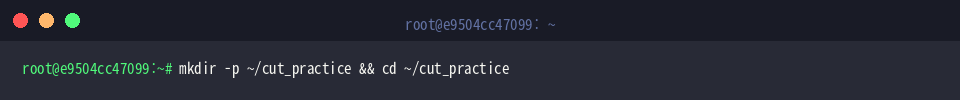
Para assegurar um ambiente isolado durante os testes, crie uma pasta dedicada no diretório pessoal e entre nela executando mkdir -p ~/cut_practice && cd ~/cut_practice.
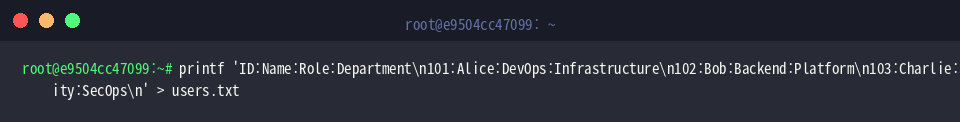
Em seguida, gere um arquivo denominado users.txt com o utilitário printf, simulando cadastros corporativos separados pelo caractere de dois-pontos (:).
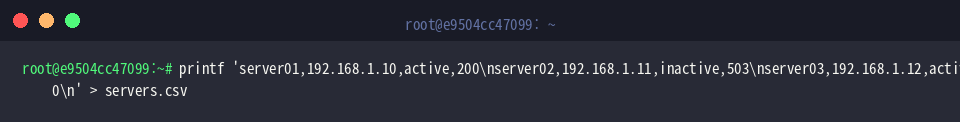
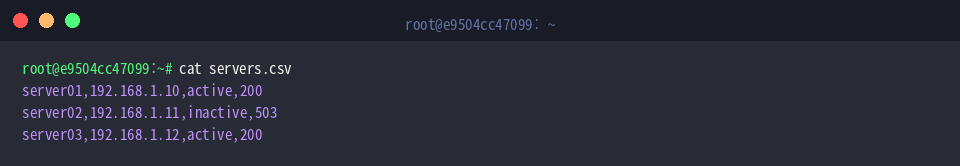
Para exemplificar a manipulação de planilhas e métricas no formato CSV, crie o arquivo servers.csv contendo registros de infraestrutura delimitados por vírgula (,).
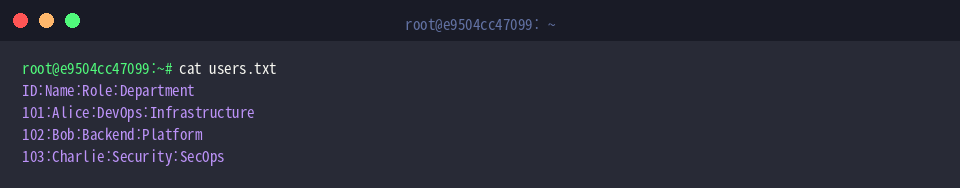
Confira a integridade do arquivo users.txt recém-criado executando cat users.txt para validar se os cabeçalhos e registros respeitam a formatação pretendida.
Certifique-se igualmente de que o conteúdo de servers.csv foi gravado de maneira adequada inspecionando o arquivo por meio de cat servers.csv.
Filtrando Colunas por Delimitador (-d) e Campos (-f)
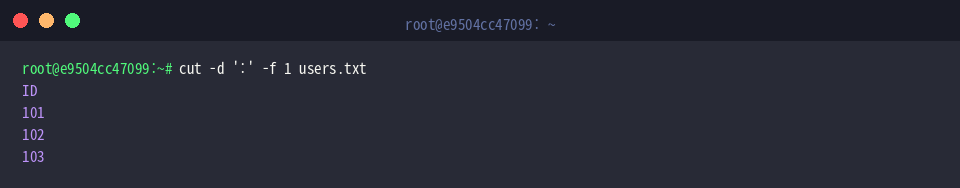
Caso a intenção seja isolar unicamente a primeira coluna do arquivo users.txt, recorra à instrução cut -d ':' -f 1 users.txt.
A flag -d ':' estabelece os dois-pontos como separador de referência, enquanto o argumento -f 1 indica a extração restrita à primeira coluna, exibindo na tela exclusivamente os identificadores numéricos (ID).
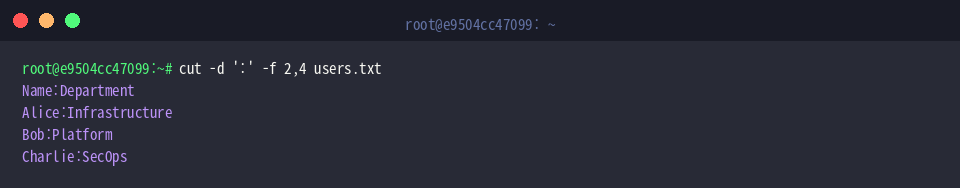
A seleção simultânea de colunas não consecutivas é realizada separando seus índices por vírgula, como demonstrado em cut -d ':' -f 2,4 users.txt.
Com essa sintaxe, o comando recupera apenas os nomes dos colaboradores (segundo campo) e seus respectivos setores (quarto campo), mantendo a pontuação original.
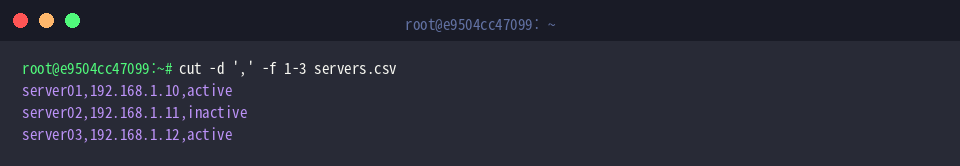
Quando o objetivo envolve colunas sequenciais, o hífen (-) define intervalos com simplicidade no comando cut -d ',' -f 1-3 servers.csv.
Combinando o delimitador de vírgula (-d ',') ao seletor -f 1-3, o terminal exibe instantaneamente o nome do host, endereço IP e status do serviço, descartando o código HTTP ao final.
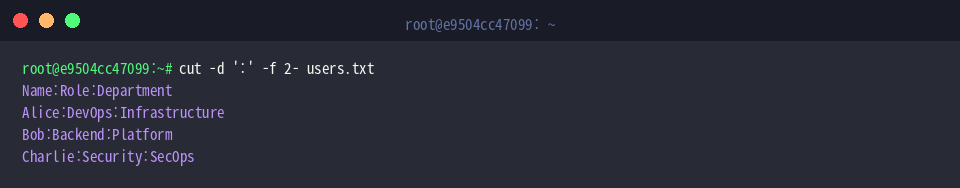
Para extrair todos os elementos a partir de determinada posição até o fim de cada linha, adote um intervalo aberto como em cut -d ':' -f 2- users.txt.
A diretiva -f 2- instrui o utilitário a preservar da segunda coluna em diante, descartando o ID inicial e mantendo nome, cargo e departamento intactos.
Fatiamento de Registros por Caracteres (-c) e Bytes (-b)
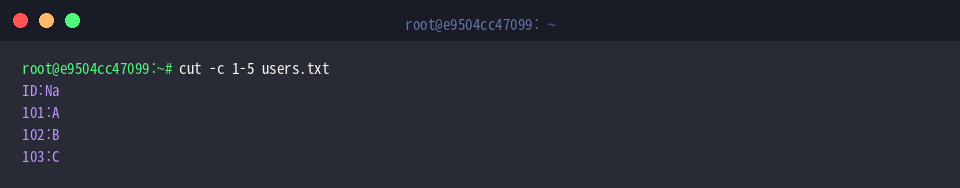
Quando os registros seguem comprimentos fixos em vez de símbolos separadores, o recorte posicional pode ser conduzido com o parâmetro -c. Execute cut -c 1-5 users.txt para capturar os primeiros cinco caracteres de cada linha.
O filtro opera estritamente pelo índice dos caracteres, trazendo apenas o bloco inicial sem considerar qualquer pontuação intermediária.
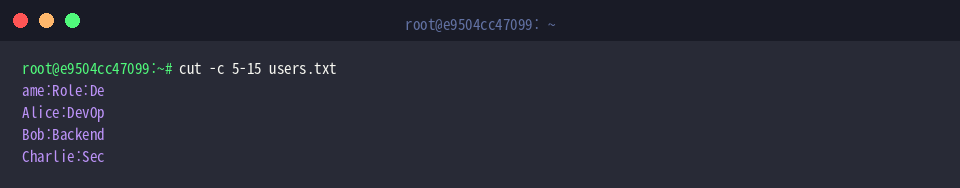
Também é possível isolar fatias intermediárias de texto informando o intervalo desejado, como ilustra a chamada cut -c 5-15 users.txt.
O parâmetro -c 5-15 delimita o intervalo entre o quinto e o décimo quinto caractere, extraindo trechos precisos no meio das linhas.
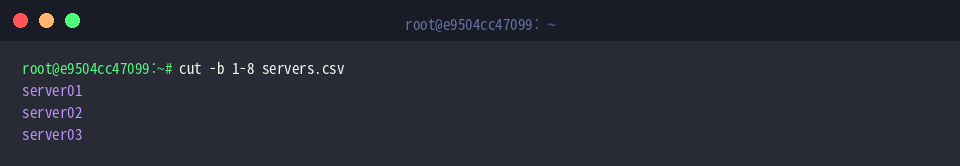
Para arquivos estruturados em largura de bytes pré-definida, a opção -b realiza recortes em nível de byte diretamente, bastando rodar cut -b 1-8 servers.csv.
A faixa -b 1-8 recupera exatamente os oito primeiros bytes de cada linha, permitindo capturar os identificadores de servidor de modo cirúrgico.
Recursos Avançados: Customização do Delimitador e Inversão (–complement)
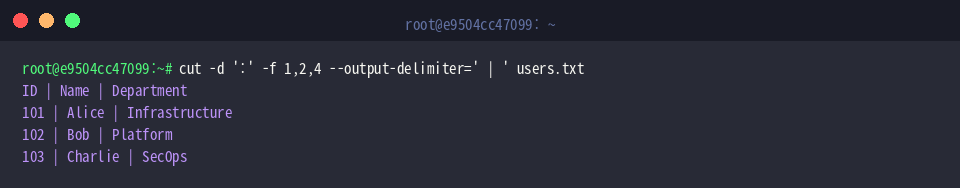
Para remodelar a apresentação dos dados e tornar a leitura mais amigável, o parâmetro --output-delimiter permite substituir o separador de saída, como no comando cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt.
Essa flag substitui os dois-pontos originais por barras verticais espaçadas (|), facilitando significativamente a inspeção visual dos relatórios gerados.
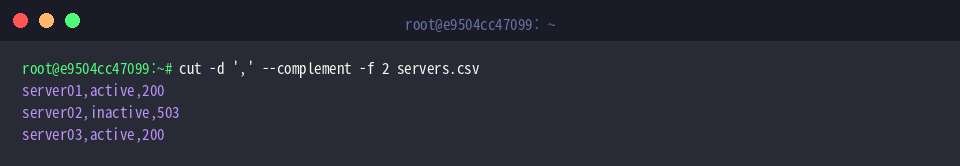
Em cenários onde é mais prático ocultar uma única coluna indesejada do que listar todas as outras, utilize a inversão com cut -d ',' --complement -f 2 servers.csv.
O modificador --complement atua invertendo a lógica do seletor: o campo 2 (endereço IP) é descartado, preservando-se as colunas 1, 3 e 4 no resultado final.
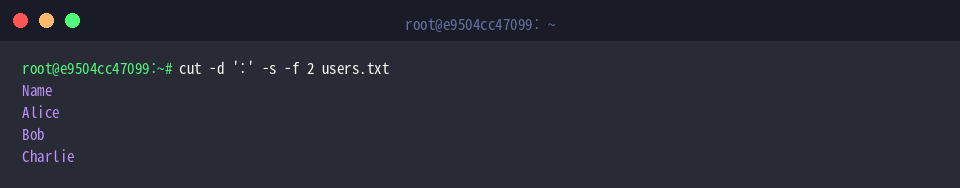
Para evitar que linhas de texto livre ou cabeçalhos sem o separador padrão poluam a saída, empregue a flag -s (--only-delimited) através de cut -d ':' -s -f 2 users.txt.
Com essa proteção ativa, linhas que não contenham o separador especificado (:) são suprimidas de imediato, garantindo que apenas registros bem-formados sejam processados.
Dominar o comando cut confere agilidade imensurável à rotina de análise de registros e construção de scripts em ambientes Ubuntu. Ao incorporar essas opções em pipelines diários combinados com ferramentas como grep, awk ou sort, o processamento de texto no terminal ganha máxima eficiência.