


Введение
awk — это один из самых мощных инструментов в среде Linux для эффективной обработки и фильтрации больших текстовых файлов и данных журналов (логов). В этой статье мы рассмотрим базовый синтаксис и практические примеры использования, которые позволяют извлекать определенные столбцы, выполнять фильтрацию по условиям и подсчитывать итоговые суммы с помощью всего одной строки команды без необходимости писать сложные скрипты.
1. Базовый принцип работы awk и извлечение определенных колонок (столбцов)
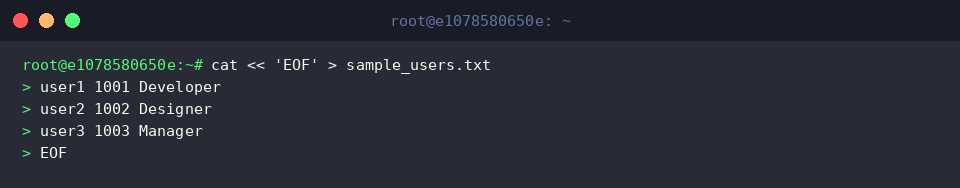
Для практики работы с командой awk создадим тестовый текстовый файл, содержащий имя пользователя, ID и должность, разделенные пробелами.
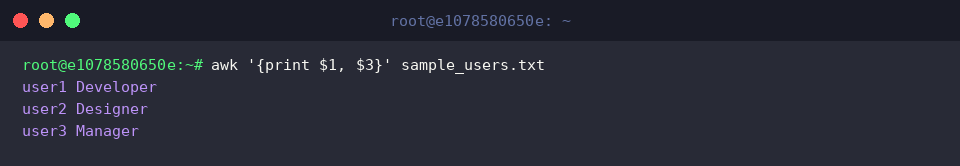
С помощью команды awk извлечем и выведем из каждой строки файла первое поле ($1, имя пользователя) и третье поле ($3, должность), используя пробел в качестве разделителя.
Если разделитель не указан явно, awk по умолчанию разделяет поля по последовательностям пробелов или символов табуляции.
⚙️ [Основные параметры]
-F fs : Задает разделитель входных полей (Field Separator).-v var=val : Присваивает переменную и начальное значение для использования внутри скрипта awk перед выполнением.-f progfile : Указывает путь к файлу, содержащему код скрипта awk для выполнения.
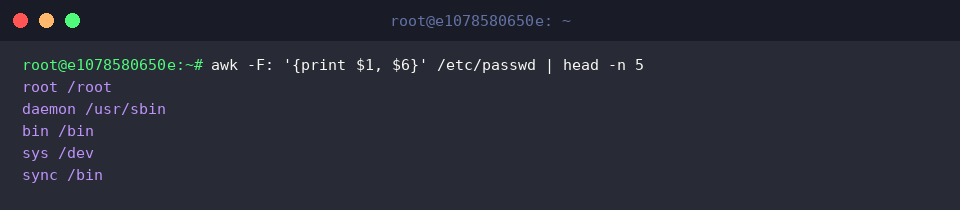
В файле /etc/passwd, где поля разделены двоеточием (:), укажем разделитель с помощью параметра -F: и извлечем только первое поле ($1, имя учетной записи) и шестое поле ($6, путь к домашнему каталогу), просмотрев первые 5 строк.
2. Пользовательская фильтрация данных с использованием условий и операторов
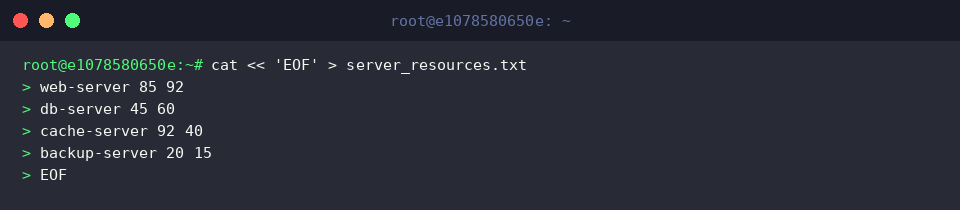
Создадим практический файл server_resources.txt, содержащий данные об использовании CPU и оперативной памяти по серверам.
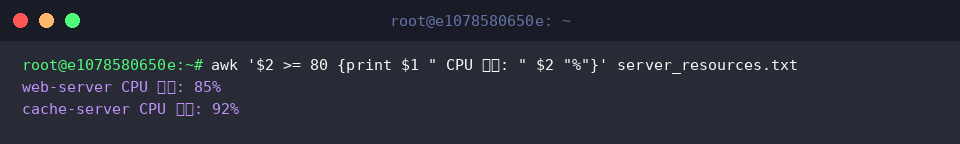
Используя условное выражение, отфильтруем серверы, у которых второе поле ($2, загрузка CPU) составляет 80% или выше, и выведем имя соответствующего сервера с предупреждающим сообщением.
Это удобно использовать для выявления системных ресурсов, превысивших пороговые значения.
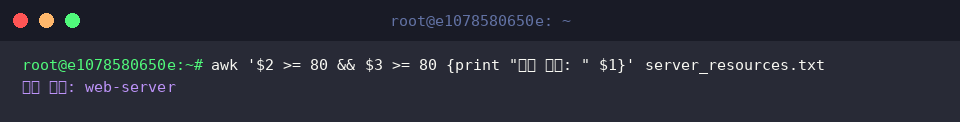
С помощью логического оператора И (&&) отберем и выведем критические серверы, у которых загрузка как CPU ($2), так и памяти ($3) составляет 80% или более.
Применение составных условий позволяет изолировать только те объекты, у которых сразу несколько ресурсов превысили пороговые значения.
3. Статистика и суммирование с использованием встроенных переменных и блоков BEGIN/END
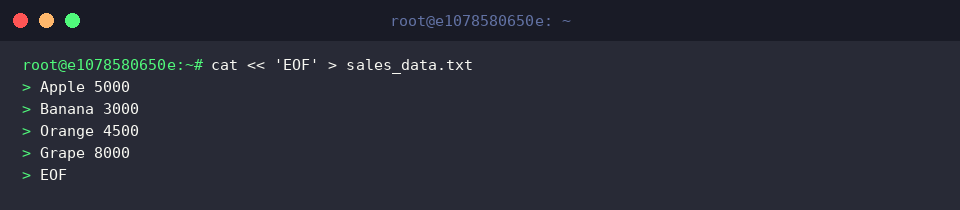
Чтобы попрактиковаться в агрегации данных и расчете статистики с помощью awk, создадим тестовый файл sales_data.txt, содержащий наименования товаров и суммы продаж.
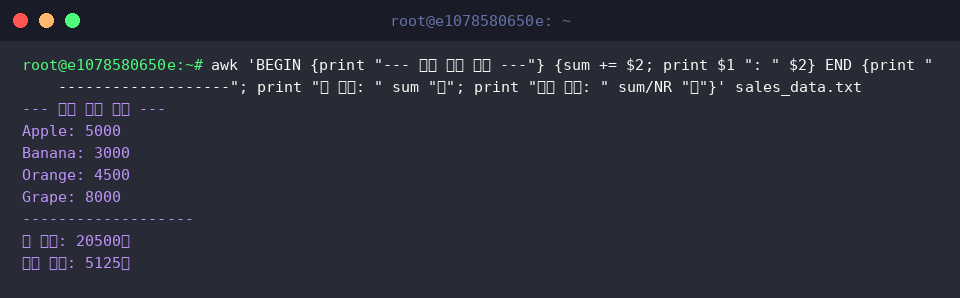
Блок BEGIN выводит вступительное сообщение до начала обработки основного текста, а значение второго поля ($2) каждой строки накапливается в переменной sum.
В блоке END, который выполняется после обработки всех строк файла, рассчитываются и выводятся общая сумма продаж и среднее значение продаж с использованием встроенной переменной NR (общее количество записей).
4. Практический анализ логов веб-сервера и фильтрация аномального трафика
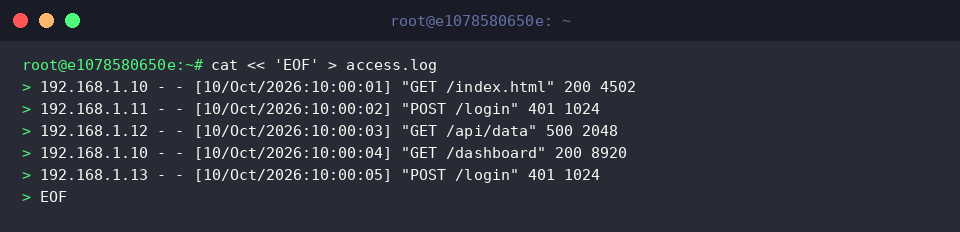
Для отработки анализа логов веб-сервера и отслеживания ошибок создадим пример файла логов access.log в стандартном формате Nginx и Apache.
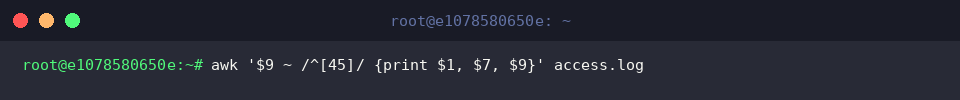
С помощью оператора сопоставления с регулярными выражениями (~) отфильтруем строки с ошибками клиентов 4xx и ошибками сервера 5xx, где девятое поле ($9, HTTP-код состояния) начинается с 4 или 5.
Извлечение только IP-адреса подключения ($1), запрашиваемого URI ($7) и кода состояния ($9) из подходящих под условие записей позволяет быстро оценить сбои и аномальные всплески трафика.
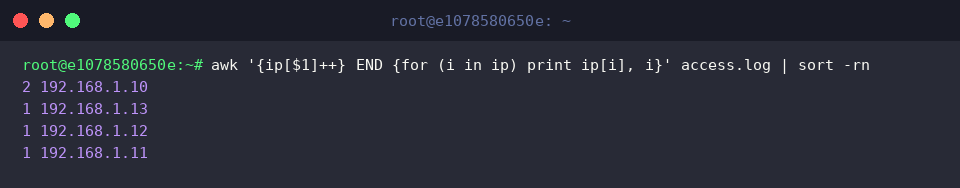
Используя ассоциативные массивы awk (ip[$1]++), подсчитаем количество запросов для каждого подключающегося IP-адреса, затем выведем общее накопленное количество с помощью цикла в блоке END и отсортируем по убыванию частоты запросов через конвейер sort -rn.
Это практический метод анализа для выявления чрезмерного трафика или аномальных попыток доступа с конкретных IP-адресов.
Мы рассмотрели базовый синтаксис и ключевые практические примеры использования команды awk, которая существенно упрощает обработку текста и анализ больших объемов логов в среде Linux.
Попробуйте применить рассмотренные опции и шаблоны в своей повседневной работе, чтобы сделать рутинные задачи по извлечению и обработке данных еще более эффективными и автоматизированными.