


Введение: решение проблемы поврежденных кодировок
Неверно распознанная кодировка текстовых данных или журналов событий — классическая головная боль системных администраторов в Unix-подобных средах. В данном практическом руководстве мы подробно разберем установку консольного инструмента chardetect, научимся безошибочно выявлять используемый набор символов на реальных примерах и изучим алгоритмы, лежащие в основе его работы.
Инсталляция пакета chardetect и обзор доступных параметров
Для развертывания инструмента в Ubuntu достаточно синхронизировать индексы репозиториев и установить библиотеку с помощью стандартного менеджера APT:
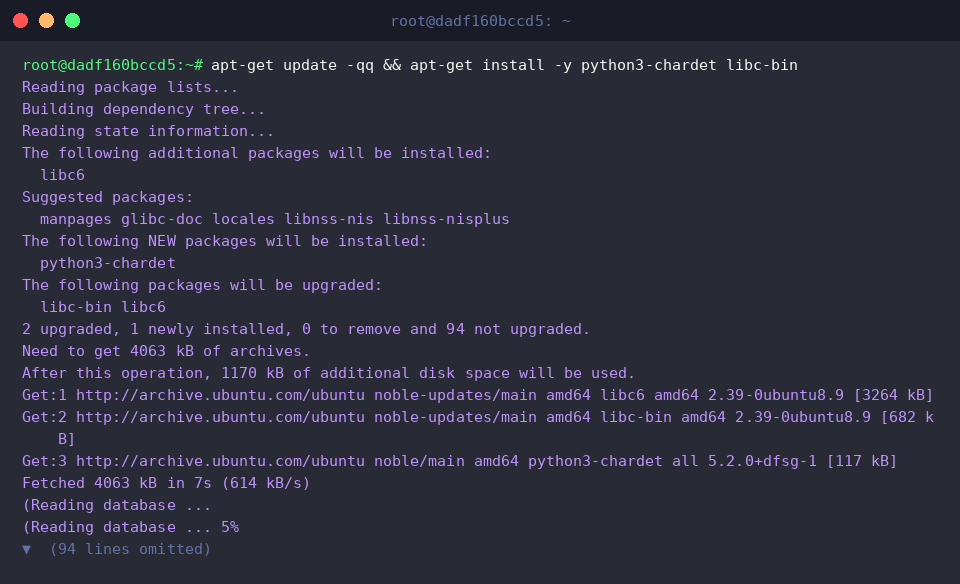
Утилита chardetect выполняет эвристический анализ байтовых последовательностей текстового потока либо файла, выдавая предположительный чарсет и степень статистической уверенности алгоритма.
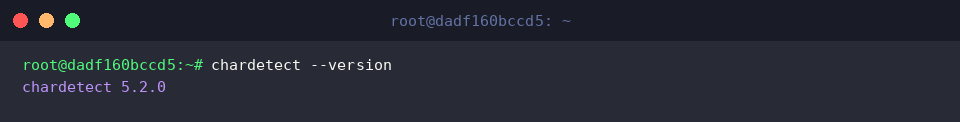
Проверить установленный релиз программы можно с помощью ключа --version.
⚙️ [Ключевые аргументы командной строки]
-l, --line-per-line : запускает построчную проверку содержимого вместо сканирования всего объема файла.--minimal : скрывает коэффициент уверенности, оставляя на выходе исключительно идентификатор кодировки.-h, --help : выводит справочную информацию по синтаксису и доступным флагам.--version : демонстрирует текущую версию утилиты и завершает работу.
Практикум: генерация тестовых файлов и распознавание кодировок
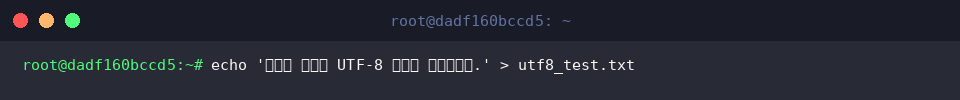
Начнем с формирования базового текстового документа в стандартной кодировке UTF-8, воспользовавшись потоковым выводом команды echo:
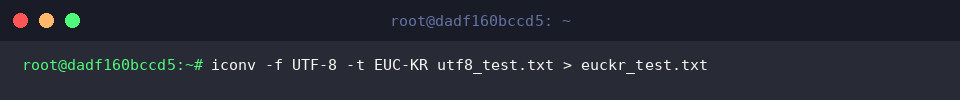
Чтобы проверить способность утилиты различать региональные наборы символов, преобразуем исходный текст в корейский стандарт EUC-KR при помощи конвертера iconv:
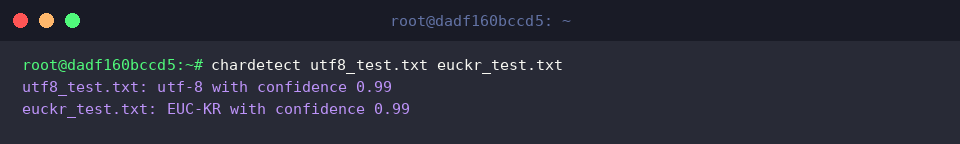
Теперь передадим оба файла в качестве аргументов chardetect для одновременного сканирования.
Утилита моментально определяет свойства каждого объекта: файл utf8_test.txt идентифицирован как UTF-8, а euckr_test.txt — как EUC-KR. В обоих случаях показатель достоверности достигает впечатляющих 99%.
Анализ через конвейер stdin и массовая проверка файлов
Смоделируем типовую ситуацию с журнальными файлами на сервере: создадим отдельный каталог и поместим туда пару логов с различным текстовым наполнением:
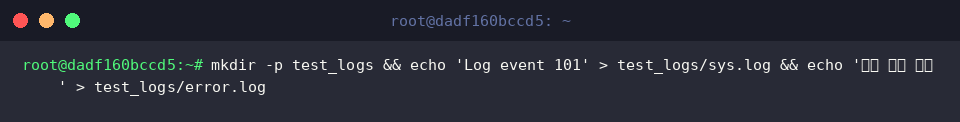
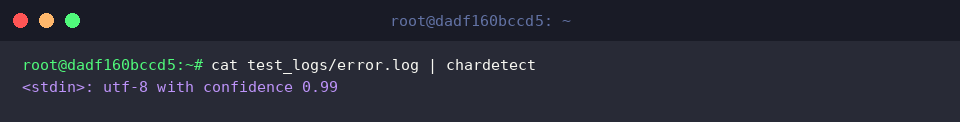
Инструмент отлично встраивается в стандартные конвейеры Linux. Направив вывод cat через пайплайновый оператор (|), мы передаем данные прямо в стандартный поток ввода:
На консоль выводится источник <stdin>, для которого алгоритм безошибочно фиксирует формат UTF-8 с точностью 99%.
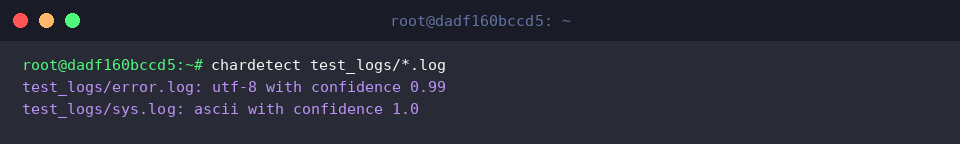
Когда требуется пакетная обработка файлов в каталоге, удобно применять маску поиска (*).
В результате группового сканирования файл error.log с многобайтными символами распознается как UTF-8, тогда как латинский sys.log определяется как стандартный ASCII.
Внутренние механизмы детекции и конвертация через iconv
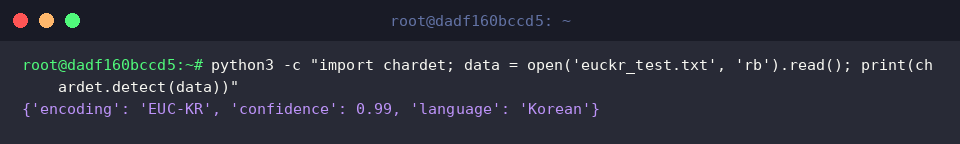
Консольная утилита представляет собой обертку над библиотекой chardet. Обратившись к модулю напрямую через однострочник Python, можно увидеть сырые метаданные анализа:
Интерпретатор возвращает словарь, включающий определенную схему (EUC-KR), степень математической уверенности (0.99) и предполагаемый язык контента (Korean).
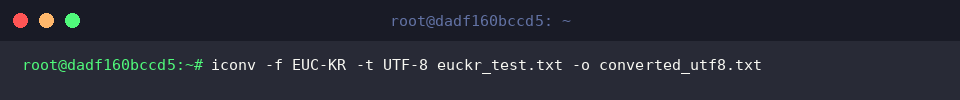
Распознав исходный чарсет, можно без риска искажения данных выполнить перекодировку с помощью iconv.
Параметр -f EUC-KR задает исходный формат, а флаг -t UTF-8 определяет целевую кодировку. Результат трансляции сохраняется в файл converted_utf8.txt.
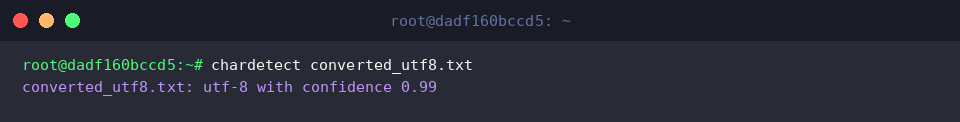
Для контроля качества проведенной операции повторно запустим chardetect на только что созданном файле converted_utf8.txt.
Диагностика подтверждает успешную смену структуры данных на UTF-8 с надежностью 99%.
Мы рассмотрели практические сценарии применения chardetect в Linux — от базовой инсталляции и конвейерной фильтрации до интеграции с утилитой iconv. Этот инструмент позволяет системным администраторам и разработчикам быстро диагностировать и устранять проблемы с поврежденным текстом при работе с разнородными файловыми архивами и логами.