


Введение
Когда требуется молниеносно проверить идентичность двух объектов на уровне байтов, стандартная утилита cmp оказывается незаменимым инструментом системного администратора. Ниже мы детально разберем практические сценарии применения этой утилиты, ключевые флаги конфигурации, особенности сопоставления как текстовых, так и бинарных данных, а также интеграцию проверок в условия скриптов командной оболочки.
Базовый анализ: поиск первого расхождения по смещению и строке
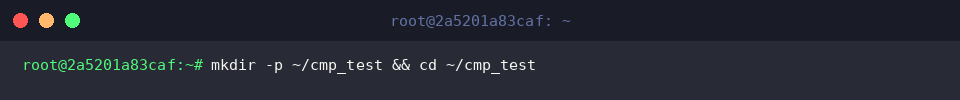
Подготовим изолированное рабочее пространство для экспериментов, выполнив создание каталога и переход в него через связку mkdir -p ~/cmp_test && cd ~/cmp_test.
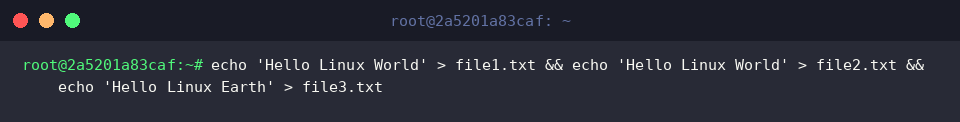
Сгенерируем тестовый набор данных: пару полностью идентичных файлов file1.txt и file2.txt, а также модифицированный вариант file3.txt с помощью команды echo.
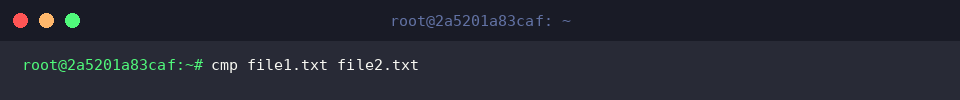
Алгоритм cmp выполняет последовательное низкоуровневое сопоставление байтов. Если содержимое файлов полностью совпадает, утилита завершает работу без вывода диагностических сообщений в стандартный поток.
⚙️ [Ключевые параметры запуска]
-b : отображает различающиеся байты в виде печатных символов рядом с их числовыми кодами.-l : выводит подробный список всех несовпадающих позиций с восьмеричными значениями байтов.-n : ограничивает область сканирования указанным объемом байтов от начала файлов.-i : пропускает заданное количество байтов в заголовке каждого файла перед стартом анализа.-s : отключает любые экранные уведомления, возвращая исключительно числовой код завершения (0 или 1).
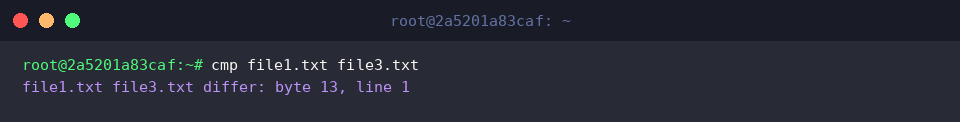
Теперь запустим сравнение файлов с несовпадающим содержимым посредством cmp file1.txt file3.txt.
Обнаружив несовпадение, утилита моментально прерывает сканирование и указывает точный номер проблемного байта, а также номер строки в текстовом представлении.
Детализация различий: листинг всех несовпадающих байтов (-l, -b)
Для наглядного изучения байтовых структур создадим два файла f1.txt и f2.txt, различающихся отдельными символами в середине строки.
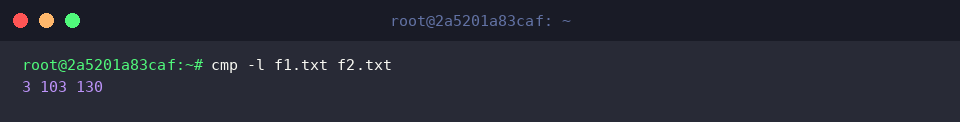
Вызов cmp -l f1.txt f2.txt формирует полный перечень всех позиций, где зафиксированы несовпадения, отображая смещение и восьмеричные значения байтов для каждого файла.
На третьей позиции отчетливо видно расхождение: в первом источнике находится восьмеричный код 103 (соответствующий C), а во втором — 130 (соответствующий X).
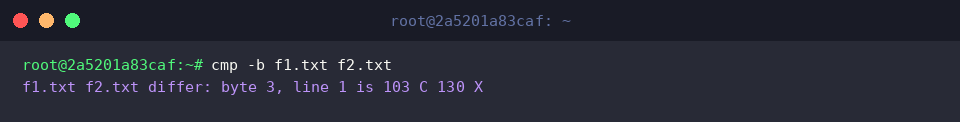
Добавление флага символьного декодирования cmp -b f1.txt f2.txt делает отчет более информативным при поиске первой нестыковки, печатая исходные символы вместе с их кодами.
В позиции 3 различие между литералами 103 (C) и 130 (X) считывается мгновенно без необходимости заглядывать в таблицу ASCII.
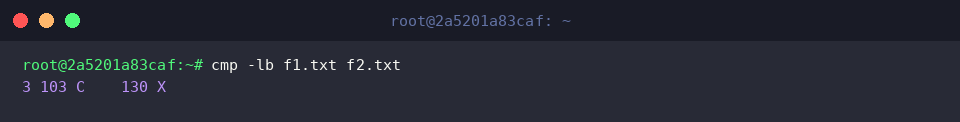
Комбинируя флаги в виде cmp -lb f1.txt f2.txt, мы получаем исчерпывающую сводку: номер каждого отличающегося байта, восьмеричный эквивалент и соответствующий ASCII-символ.
Такая форма вывода идеальна для быстрого ручного аудита небольших бинарных повреждений или правок в конфигурационных файлах.
Автоматизация и Bash-скрипты: «тихий» режим и коды возврата (-s)
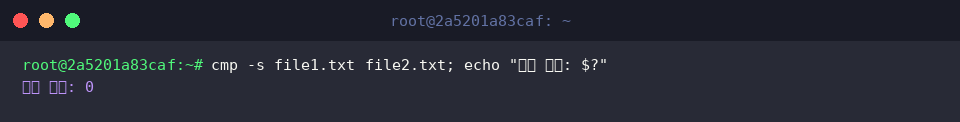
Применение ключа -s полностью подавляет вывод утилиты в консоль, что особенно удобно для проверки кода возврата ($?) в автоматизированных конвейерах.
При совпадении содержимого файлов утилита возвращает статус успешного завершения 0.
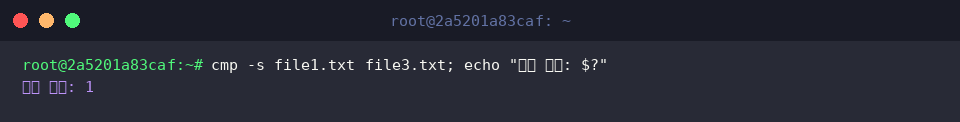
Если же сопоставляемые объекты имеют хотя бы малейшее байтовое отличие, выполнение команды cmp -s file1.txt file3.txt завершится с кодом 1.
Это позволяет однозначно трактовать расхождение в логических ветвлениях без парсинга текстовых логов.
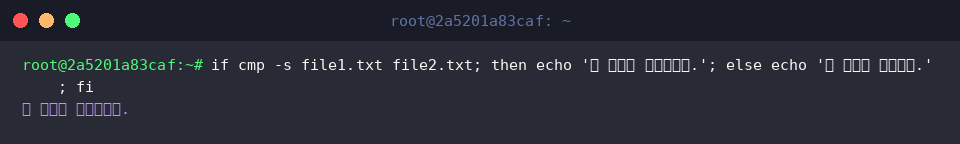
Интегрируем cmp -s в классическую конструкцию if-then-else внутри оболочки Bash для выполнения целевых действий в зависимости от идентичности файлов.
Поскольку данные в обоих файлах одинаковы, условие принимает значение истины, запуская ветку подтверждения эквивалентности.
Тонкая настройка диапазона: пропуск заголовков (-i) и лимит байтов (-n)
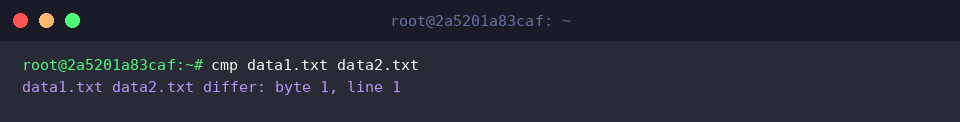
Для тестирования частичного сопоставления сформируем наборы data1.txt и data2.txt, имеющие разные префиксы, но общую хвостовую часть.
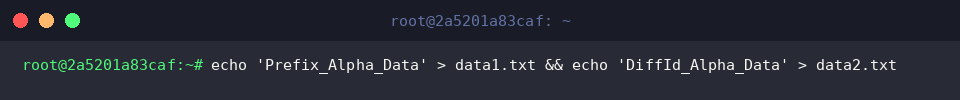
Стандартный запуск cmp data1.txt data2.txt ожидаемо зафиксирует несовпадение на самом первом символе (байт 1, строка 1).
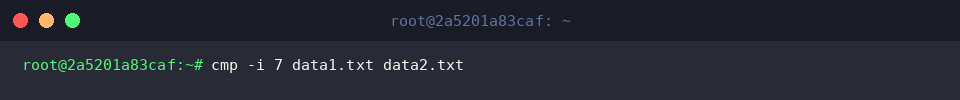
Флаг смещения -i 7 указывает утилите проигнорировать начальные 7 байтов и приступить к анализу со следующего участка.
Оставшиеся сегменты данных (Alpha_Data) полностью совпадают, поэтому проверка успешно завершается в тихом режиме.
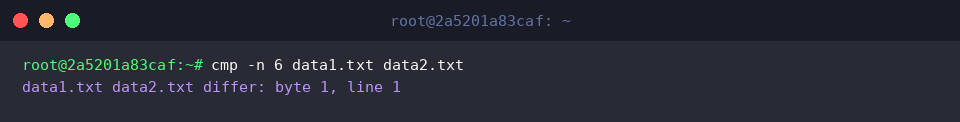
Опция -n 6 задает жесткий лимит на глубину проверки: сканируются строго первые 6 байтов от начала файлов.
В пределах этого стартового блока утилита находит расхождение уже на первом байте и немедленно рапортует об этом.
Мы подробно рассмотрели эксплуатацию команды cmp в экосистеме Linux — от экспресс-проверок до тонкого побайтового сопоставления с фильтрацией диапазонов.
Этот инструмент значительно экономит системные ресурсы и время при валидации объемных образов дисков, архивов и скомпилированных бинарных файлов.