


Введение
Утилита comm — один из базовых и при этом недооценённых инструментов командной строки Linux, предназначенный для построчного сопоставления текстовых массивов. В отличие от тяжеловесного diff, она мгновенно раскладывает информацию на три логические категории: строки, уникальные для первого источника, строки только из второго файла и их общее пересечение. В данном руководстве мы подробно разберём механику трёхколоночного вывода, фильтрацию множеств через числовые флаги, а также приёмы работы с несортированными данными прямо в конвейере Bash.
1. Архитектура утилиты comm и распределение данных по колонкам
Для изоляции тестовой среды подготовим отдельный каталог и перейдём в него с помощью команды mkdir -p ~/comm_lab && cd ~/comm_lab.
Наполним первый файл fruits_a.txt предварительно отсортированным списком строк, выполнив команду printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt.
Аналогичным образом создадим контрольный список fruits_b.txt с пересекающимися значениями: printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt.
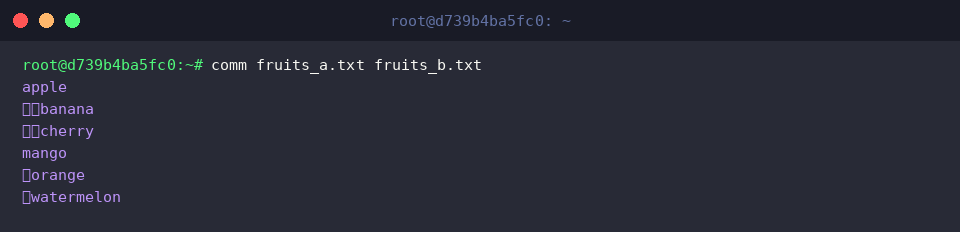
Принцип работы comm заключается в параллельном чтении двух отсортированных потоков и разделении вывода на три столбца при помощи табуляции:
- Первый столбец (без смещения): записи, уникальные для первого файла.
- Второй столбец (отступ в один таб): строки, найденные исключительно во втором файле.
- Третий столбец (отступ в два таба): общее подмножество, присутствующее в обоих источниках.
⚙️ [Ключевые параметры утилиты]
-1 : скрыть вывод элементов первого файла (1-я колонка).-2 : скрыть вывод элементов второго файла (2-я колонка).-3 : скрыть дублирующиеся в обоих файлах строки (3-я колонка).--check-order : строгая проверка корректности лексикографической сортировки входных файлов.--nocheck-order : игнорировать ошибки порядка строк без аварийного завершения.--output-delimiter=STR : использовать произвольную строку-разделитель (STR) вместо стандартной табуляции.
2. Выборка пересечений и разностей с помощью числовых флагов
Убедимся, что находимся в директории с нашими файлами, выполнив переход: cd ~/comm_lab.
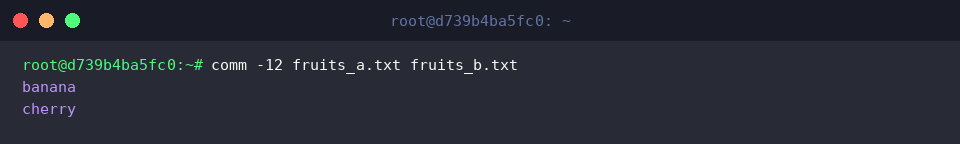
Комбинация флагов comm -12 подавляет отображение первой и второй колонок, оставляя в терминале только математическое пересечение двух списков.
В результате выводятся совпавшие позиции — banana и cherry.
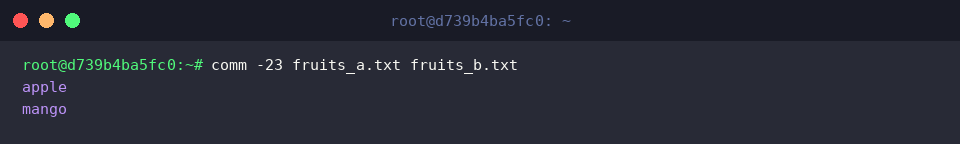
Если требуется получить чистую относительную разность (то, что есть только в первом наборе), отключаем второй и третий столбцы вызовом comm -23.
На экран поступят исключительно apple и mango из fruits_a.txt.
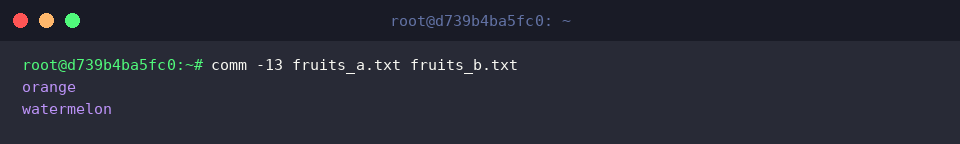
Чтобы выделить данные, специфичные для второго перечня, подавляем столбцы 1 и 3 с помощью comm -13.
Команда выведет только orange и watermelon, содержащиеся в fruits_b.txt.
3. Обработка неотсортированных данных через Process Substitution в Bash
Перед началом экспериментов возвращаемся в рабочую папку: cd ~/comm_lab.
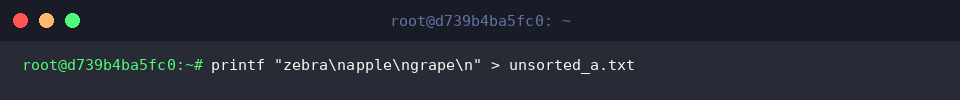
Поскольку comm требует упорядоченного ввода, смоделируем работу с хаотичными списками. Создадим первый несортированный файл: printf "zebra\napple\ngrape\n" > unsorted_a.txt.
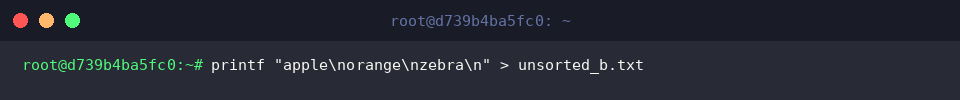
Вторым шагом сформируем ещё один произвольный список: printf "apple\norange\nzebra\n" > unsorted_b.txt.
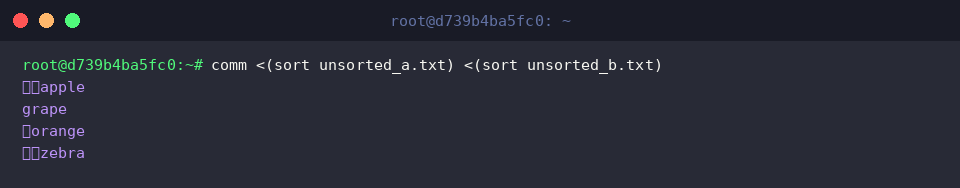
Вместо сохранения промежуточных файлов на диск применим механизм подстановки процессов оболочки: comm <(sort unsorted_a.txt) <(sort unsorted_b.txt). Синтаксис <(...) налету передаёт отсортированные потоки прямо на стандартный ввод comm.
В выводе данные распределяются корректно: 1-я колонка содержит grape, 2-я колонка — orange, а 3-я колонка отображает общие значения apple и zebra.
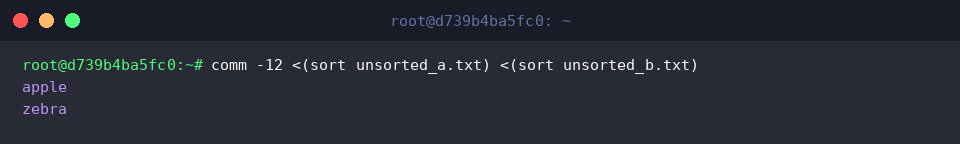
Добавив фильтрующие аргументы в конструкцию, получаем команду comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt), которая оставляет исключительно точки пересечения.
Таким образом, без засорения файловой системы временными артефактами мы извлекаем общие элементы apple и zebra.
4. Сравнение установленных пакетов и нюансы регистра символов
Перейдём в каталог с материалами практикума: cd ~/comm_lab.
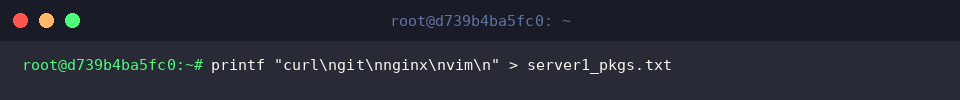
В практическом администрировании comm часто применяется для сверки окружений двух серверов. Сымитируем перечень ПО первого хоста с помощью команды printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt.
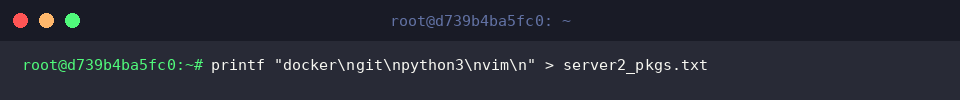
Затем создадим опись установленных пакетов для второго узла: printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt.
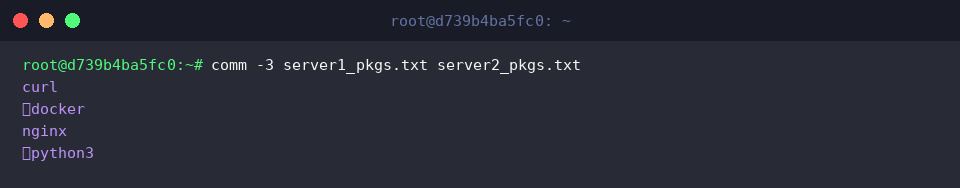
Флаг comm -3 server1_pkgs.txt server2_pkgs.txt скрывает третью колонку (общие элементы), наглядно демонстрируя только расхождения между конфигурациями.
Совпадающие утилиты git и vim фильтруются, а в выводе остаются компоненты curl и nginx (присутствующие только на первом сервере) и docker с python3 (установленные исключительно на втором).
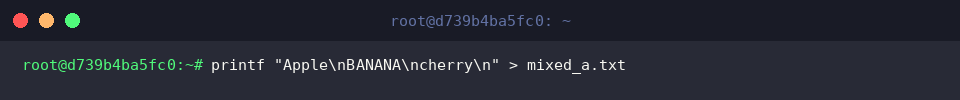
Другой важный практический аспект — чувствительность к регистру. Создадим файл со смешанным регистром букв: printf "Apple\nBANANA\ncherry\n" > mixed_a.txt.
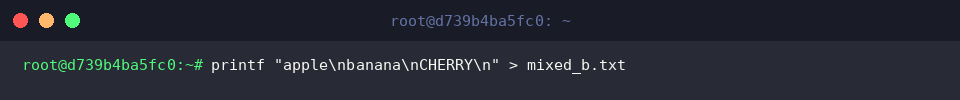
Подготовим второй тестовый файл с аналогичными словами в противоположном регистре: printf "apple\nbanana\nCHERRY\n" > mixed_b.txt.
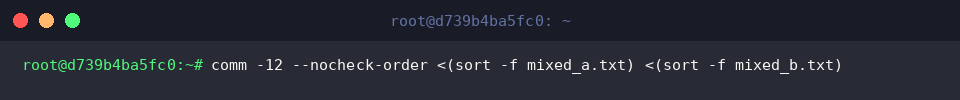
Команда comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) сначала выполняет регистронезависимое упорядочивание ключом sort -f, а флаг --nocheck-order предотвращает прерывание работы из-за нестандартной последовательности байтов.
Несмотря на одинаковый лексический состав, терминал ничего не выводит: comm проводит строгую побайтовую сверку символов, поэтому строки с различием в регистре не считаются идентичными.
В этом материале мы разобрали, как с помощью команды comm проводить прецизионный анализ файлов, выделять общие фрагменты и фильтровать расхождения.
Комбинируя comm с сортировкой и конвейерами Linux, вы сможете быстро сопоставлять масштабные списки пользователей, пакетов и конфигурационных логов в повседневных задачах DevOps.