


Обзор возможностей утилиты csplit
Когда требуется разделить объемный системный журнал или структурированный текстовый документ не просто на равные части, а по определенным маркерам, регулярным выражениям или номерам строк, стандартная команда split оказывается бессильна. В подобных сценариях незаменима системная утилита csplit (context split). Ниже на наглядных примерах рассмотрены ключевые приемы работы с этим инструментом для эффективной нарезки данных по смысловому контексту.
Базовая нарезка текстовых данных по номерам строк
Для безопасных экспериментов создадим изолированный каталог и перейдем в рабочую директорию с помощью команды mkdir -p ~/csplit_lab && cd ~/csplit_lab.
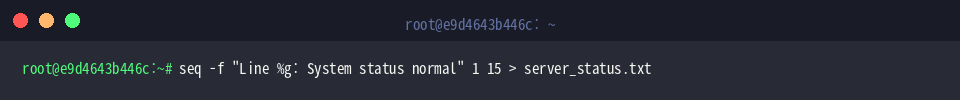
Сформируем демонстрационный файл server_status.txt из 15 строк с записями о состоянии системы, выполнив команду seq -f "Line %g: System status normal" 1 15 > server_status.txt.
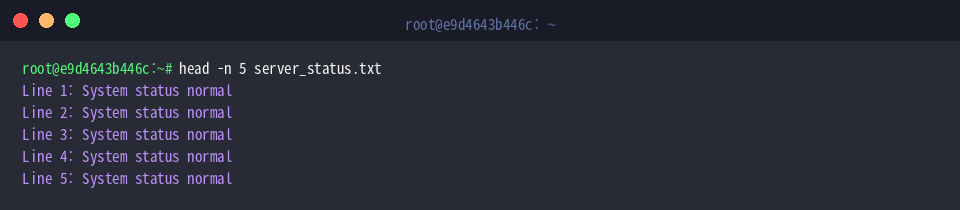
Убедимся в корректности структуры подготовленного файла, просмотрев первые пять строк вызовом head -n 5 server_status.txt.
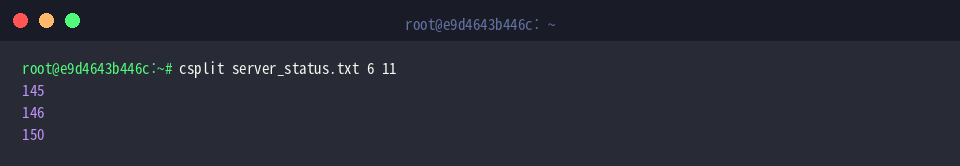
Утилита csplit позволяет задавать точные границы строк для сегментации входного потока.
Инструкция csplit server_status.txt 6 11 указывает утилите разделить файл на три части: строки 1–5, строки 6–10 и остаток с 11 по 15 строку включительно.
Числа, выводимые в терминал по окончании обработки, отражают точный объем каждого созданного сегмента в байтах.
⚙️ [Полезные параметры]
-f PREFIX : переопределяет стандартный префикс имен выходных файлов (xx) на заданную строку.-b FORMAT : задает формат числового суффикса с использованием синтаксиса printf.-n DIGITS : определяет количество цифр в нумерации создаваемых фрагментов (по умолчанию: 2).-s : включает тихий режим работы, отключая вывод информации о байтовом размере файлов.-z : подавляет создание пустых результирующих файлов нулевой длины.-k : предотвращает удаление уже сформированных сегментов при возникновении сбоя или ошибки.
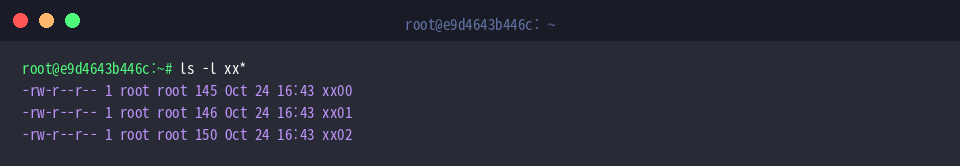
Оценим результаты сегментации содержимого вызовом ls -l xx*.
В директории появились три результирующих файла с дефолтным префиксом: xx00, xx01 и xx02, размер которых полностью соответствует заданным диапазонам строк.
Автоматическая сегментация по регулярным выражениям
Подготовим отчет с несколькими независимыми блоками системных метрик, выполнив команду cat << 'EOF' > reports.txt:
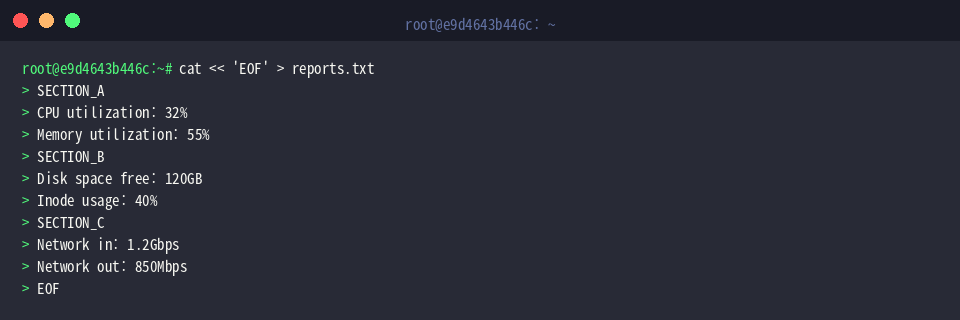
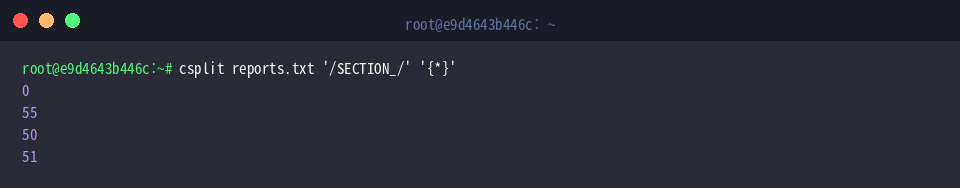
Командой cat reports.txt проверим сформированный отчет, содержащий секции SECTION_A, SECTION_B и SECTION_C.
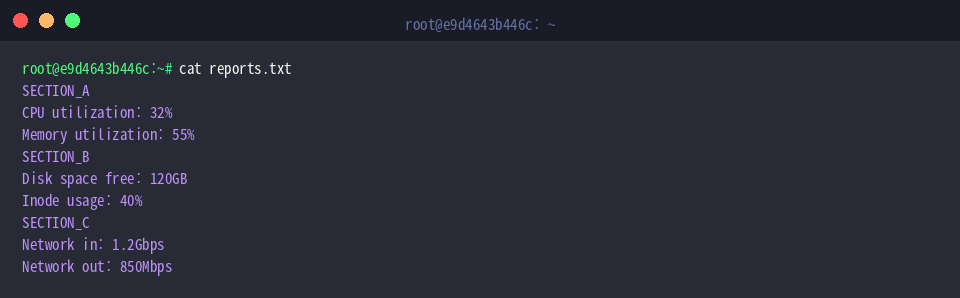
Конструкция csplit reports.txt '/SECTION_/' '{*}' сканирует файл и делит его при каждом обнаружении шаблона /SECTION_/. Квантификатор { * } инструктирует утилиту повторять операцию поиска совпадений до самого конца файла.
Терминальный вывод отображает размеры сгенерированных фрагментов; при этом первая запись отражает область до первого вхождения шаблона (в данном случае пустой блок размером 0 байт).
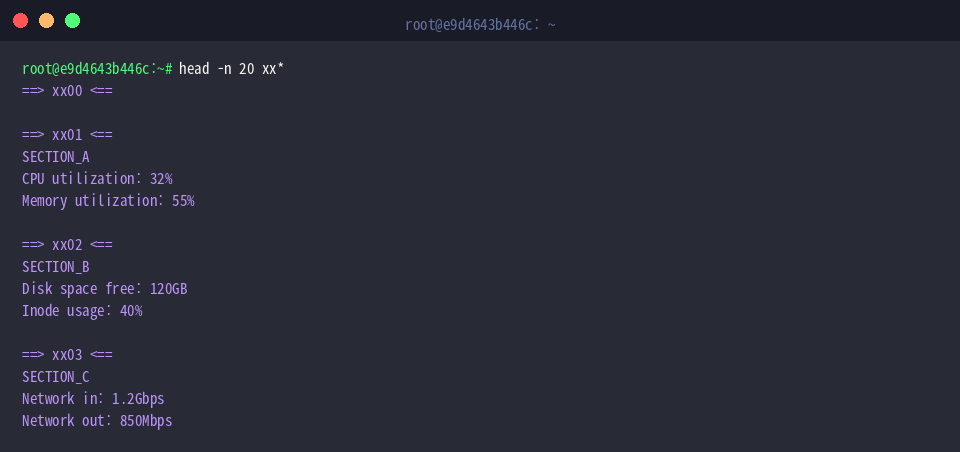
Для инспекции содержимого каждого созданного фрагмента выполним head -n 20 xx*.
Вывод подтверждает, что начальный пустой файл xx00 предшествует первому совпадению, тогда как xx01, xx02 и xx03 содержат изолированные блоки соответствующих секций.
Настройка префикса и разрядности нумерации выходных файлов
Создадим имитацию журнала событий приложения с записями разного уровня важности посредством команды cat << 'EOF' > app.log:
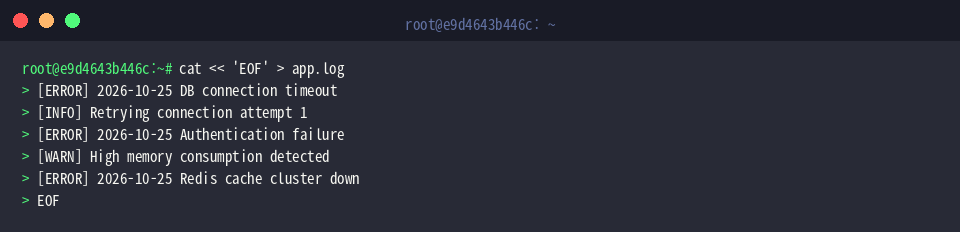
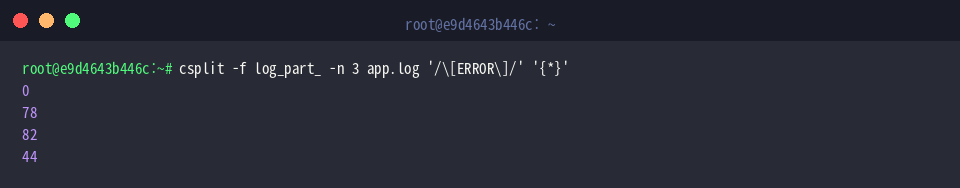
Команда csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}' делит лог по маркерам критических событий [ERROR]. Параметр -f log_part_ заменяет стандартный префикс на информативное имя, а флаг -n 3 задает трехзначный формат нумерации создаваемых файлов.
В консоли отобразится перечень размеров сформированных блоков в байтах.
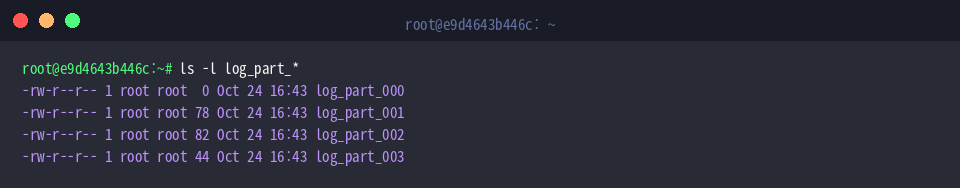
Вызовом ls -l log_part_* проверим сгенерированные сегменты журнала.
Вместо стандартного шаблона имена файлов теперь начинаются с log_part_ и содержат аккуратные трехзначные индексы от log_part_000 до log_part_003.
Практическое применение опций сохранения данных (-k) и отсечения пустых файлов (-z)
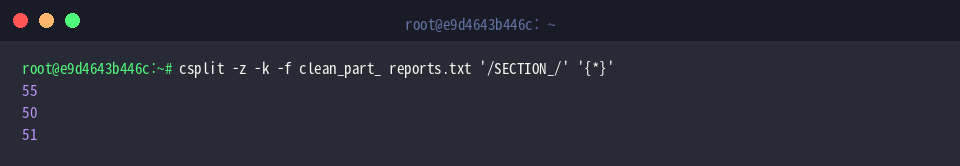
Вызов csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' объединяет флаг -z, исключающий появление нулевых файлов перед первым совпадением, и флаг -k, защищающий уже записанные фрагменты от удаления в случае сбоя.
На экран будут выведены размеры только тех трех файлов (55, 50 и 51 байт), которые содержат реальную информацию.
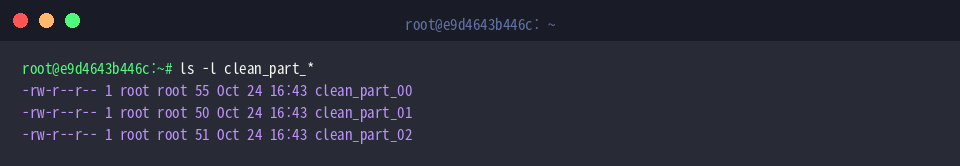
С помощью команды ls -l clean_part_* убедимся в отсутствии артефактов нулевой длины.
Благодаря действию опции -z созданы исключительно значимые сегменты clean_part_00, clean_part_01 и clean_part_02.
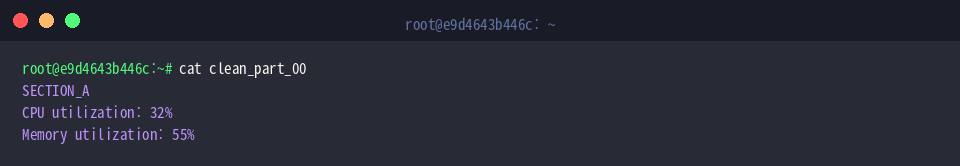
Проверим корректность содержимого первого фрагмента командой cat clean_part_00.
Файл clean_part_00 сразу открывается блоком SECTION_A, подтверждая, что отсечение пустого префикса не затронуло исходные данные отчета.
Завершив практические эксперименты, очистим рабочую среду удалением тестового каталога командой rm -rf ~/csplit_lab.
Мы подробно рассмотрели практическое применение системной утилиты csplit для контекстной нарезки текстовых массивов и структурированных логов в Linux.
Гибкое комбинирование номеров строк, шаблонов regex и управляющих ключей делает csplit мощным инструментом автоматизации повседневных задач системного администрирования.