


概述
在日常管理 Ubuntu 系统时,频繁面对庞大的 .bz2 归档文件若先解包再比对,不仅耗时而且极占磁盘 I/O。利用系统内置的 bzcmp 工具,我们能够直接穿透压缩层执行逐字节的内容校验。本文将带大家从基础语法起步,结合退出状态码、字节偏移分析以及压缩文件与明文文本的混杂比对,全面掌握这一高效排错利器。
环境准备与演示样本构建
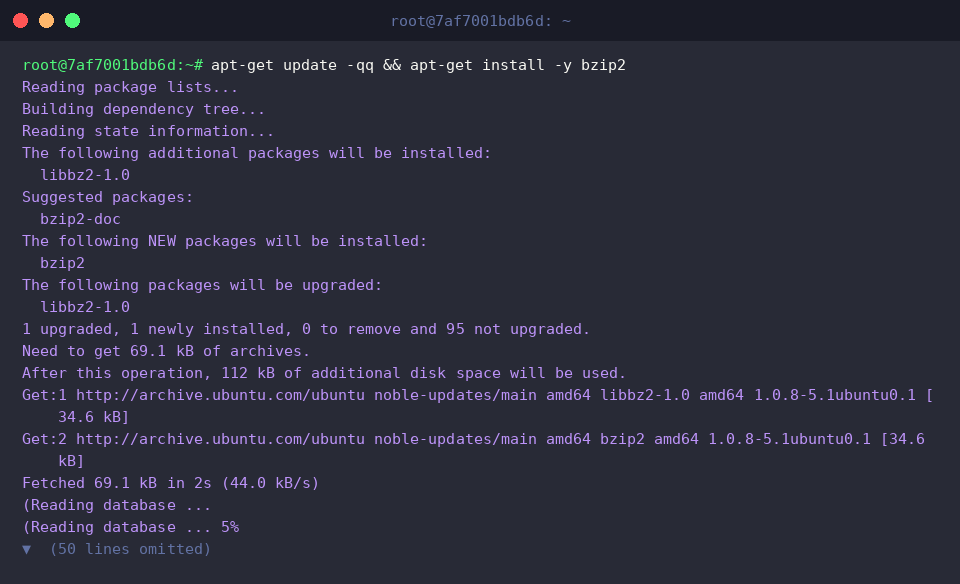
首先在测试节点上补齐所需的软件包,确保 bzip2 相关配套工具已就绪。
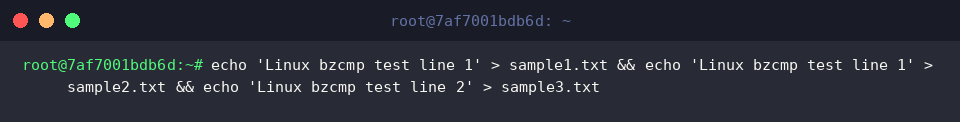
为了构造直观的对比场景,先向磁盘写入三份文本:前两份数据完全一致,第三份则写入不同的内容以供测试。
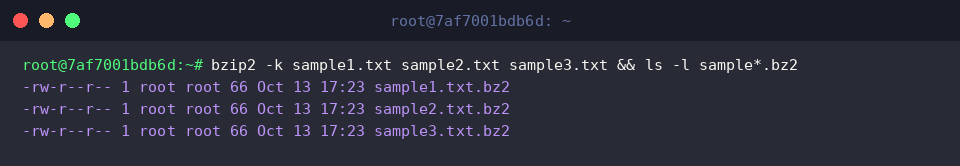
紧接着使用带 -k(保留源文件)参数的压缩指令生成对应的 .bz2 文件,并通过列表命令确认所有归档均已正确写入。
一致性校验与进程退出码($?)评估
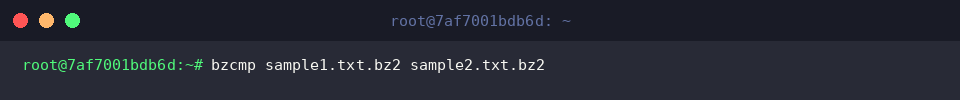
当两份压缩归档内部的数据无任何差异时,直接执行比对指令 bzcmp sample1.txt.bz2 sample2.txt.bz2。遵循 Unix 经典的“静默即成功”哲学,终端不会返回任何多余字符。
在自动化脚本开发中,静默输出通常依赖返回值判断。此时打印 $? 环境变量,返回的代码 0 正好确认了二者内容处于完全吻合的状态。
异构数据比对及偏移量定位
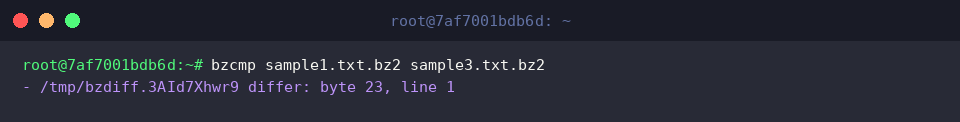
换成存在内容差异的测试文件,执行 bzcmp sample1.txt.bz2 sample3.txt.bz2 观察响应。系统会迅速捕获不一致之处,并准确定位首个发生分歧的字节索引及行号。
再度抓取此时的进程退出状态。虽然检测到了内容不匹配,但程序本身并未发生崩溃或语法异常,它以标准状态码标识了数据存在出入的检测结果。
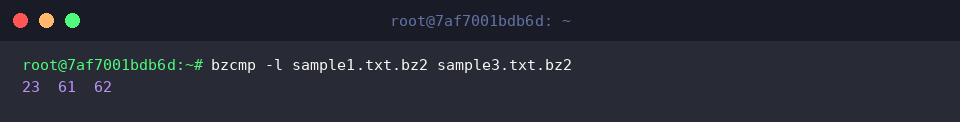
如果需要更深入的取证分析,可以追加 -l 选项。这会激活底层的详细字节扫描模式,逐行输出产生偏差的十进制偏移地址,以及两端对应数据的八进制原始编码。
归档包与明文文件混检及现场清理
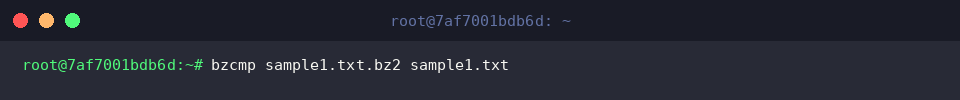
bzcmp 的另一大亮点在于它能够自动处理混合输入——即一边是 .bz2 压缩包,另一边是解压状态下的普通文件。执行跨格式比对时,底层管线会自动处理流式解压,内容一致依然保持完全静默。
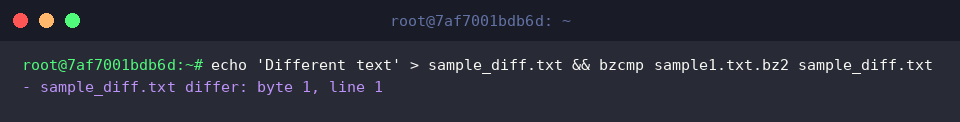
我们再临时写入一段互不相同的字符文件来进行交叉比对,工具依然能无缝识别内容冲突,精准反馈首个出现不同的字节段与行号。
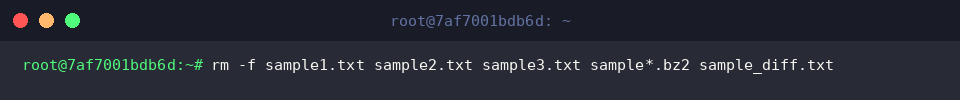
实验结束后,通过清理指令抹除本次演练所创建的所有临时文件及归档包,使工作区保持清爽。
综上所述,bzcmp 巧妙化解了解压大体积历史日志或备份文件时带来的存储与算力开销。将其纳入日常维护和运维脚本工具箱中,能在排查差异时大幅提升工作流效率。