


概述
在日常生产排障中,海量历史归档日志普遍采用 bzip2 压缩存储。若每次排查故障都要先解压文件,不仅消耗大量磁盘 I/O,还极易引发存储空间不足。本文重点分享 bzegrep 工具的实操技巧,通过丰富的案例演示如何在不还原压缩包的前提下,直接运用扩展正则表达式在 bz2 归档中完成多维度信息过滤。
构建实战测试环境与依赖安装
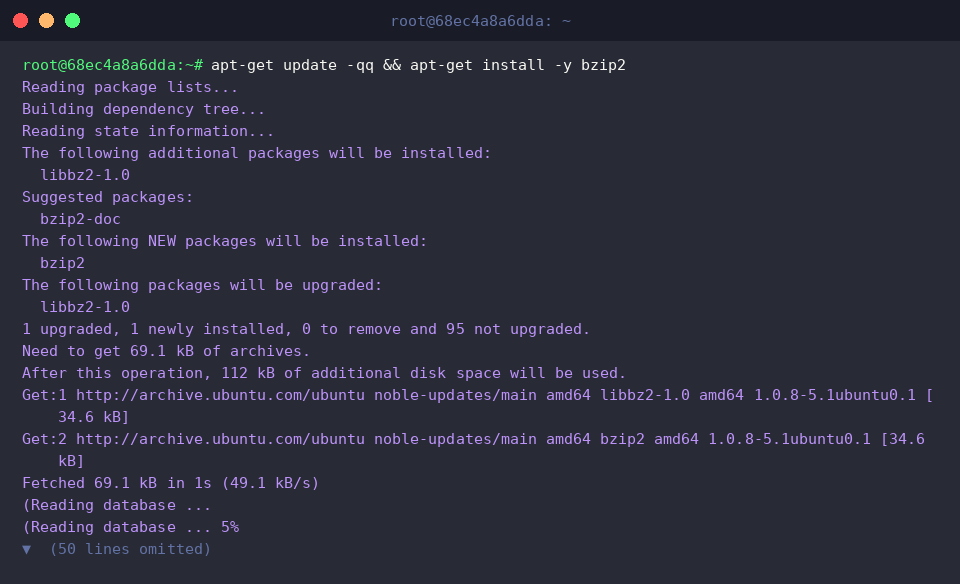
首先通过 APT 包管理器部署底层依赖,确保系统中具备完整的 bzip2 工具链。
在系统临时目录下建立专门的演练环境并快速切换至该路径:mkdir -p /tmp/bzegrep-lab && cd /tmp/bzegrep-lab。
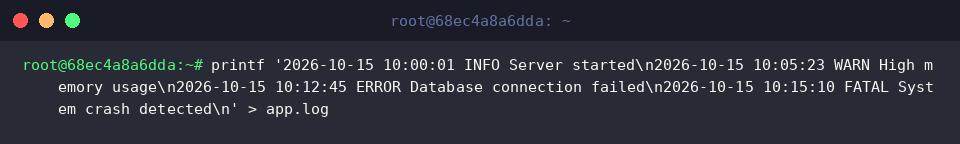
生成包含多种日志级别(INFO、WARN、ERROR、FATAL)的测试样例文件 app.log。
借助 -k 参数在生成 .bz2 压缩包的同时保留文本源文件:执行 bzip2 -k app.log。
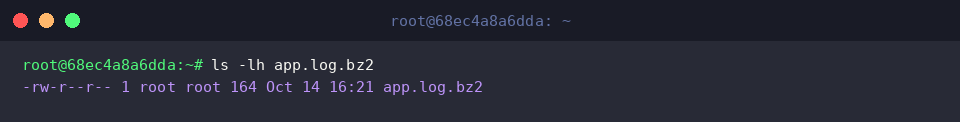
执行 ls -lh app.log.bz2 查看新生成归档文件的大小与权限属性,确认文件处于完备状态。
零解压快速检索 bz2 文件关键字
开始前先执行命令确认当前处于演练目录:cd /tmp/bzegrep-lab。
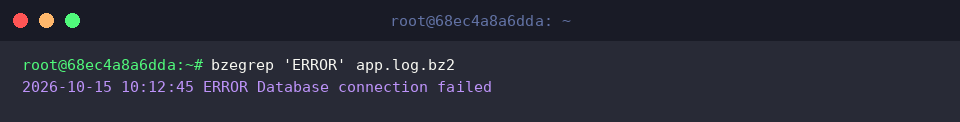
使用 bzegrep 直接定位 app.log.bz2 中包含 ERROR 标记的故障行。
系统会在管道内部自动处理数据流解压,并在控制台瞬间呈现相关的错误日志。
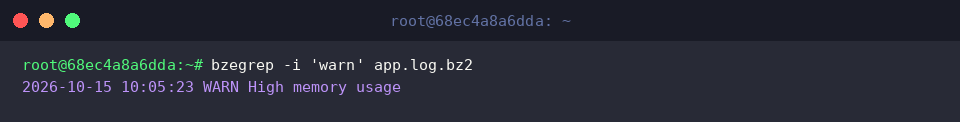
排查过程中经常遇到大小写不统一的问题,此时可加入 -i 参数忽略大小写匹配 warn 关键字。
即便参数为全小写,源文件中大写的 WARN 预警行依然能够被精准抓取。
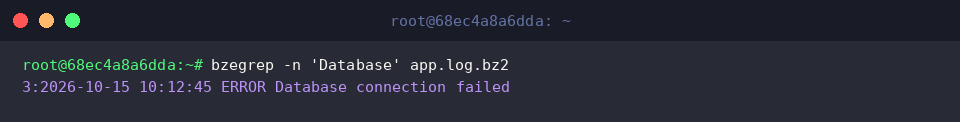
为了便于对照原文件核对上下文,通过 -n 选项在查询 Database 相关事件时输出原始行号。
返回结果前端清晰标注了行号 3,极大方便了后续溯源定位。
运用扩展正则表达式 (ERE) 进行复合模式匹配
再次确保处于操作工作路径下:运行 cd /tmp/bzegrep-lab。
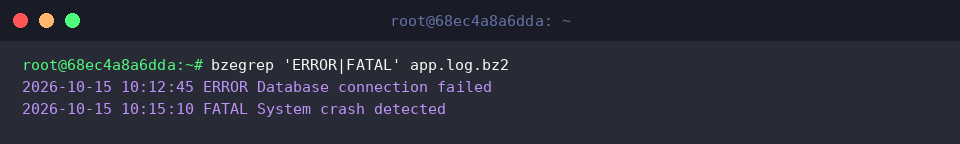
bzegrep 原生兼容扩展正则表达式语法,可利用管道符 | 实现多条件的逻辑或过滤,同时抓取 ERROR 与 FATAL 级别的关键记录。
系统会一并抓取并输出所有符合任一故障特征的记录。
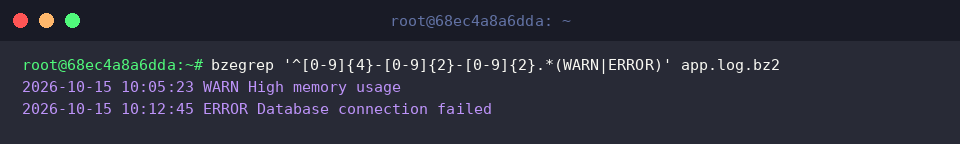
若需严格筛选以规范时间戳起始且同时出现警示或异常标志的记录,可传入组合正则模式。
这种严苛的正则约束能够有效过滤干扰项,仅保留符合特征的结构化行。
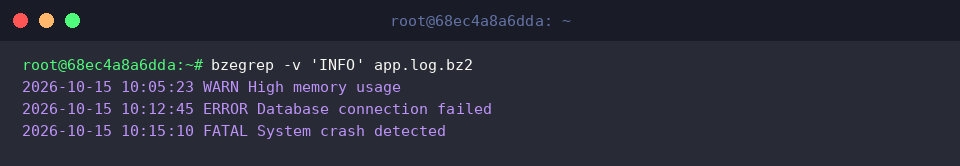
通过添加 -v 选项反向排除无用的噪声数据,例如剔除所有常规的 INFO 行。
非故障相关的提示信息被整体过滤,留下关键的异常状态供重点研判。
批量扫描多压缩文件并输出匹配来源
继续在演练环境中开展多目标测试:cd /tmp/bzegrep-lab。
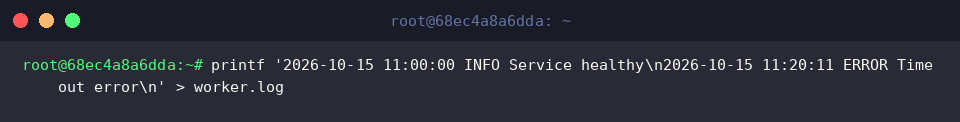
新建第二个测试日志 worker.log,用于模拟多节点或分布式场景下的日志结构。
运行 bzip2 worker.log 将其转换为压缩包格式。
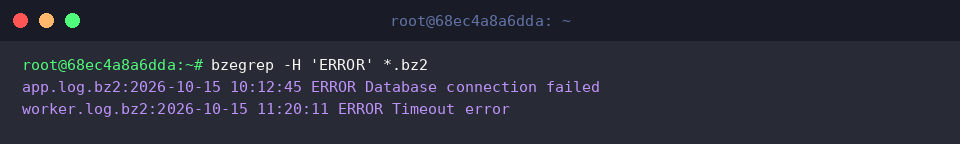
当通配符匹配多个压缩文件(*.bz2)时,搭配 -H 选项可强制在每行匹配内容前附带具体的归档文件名。
控制台将明确标示各条异常分别来源于哪个压缩文件,避免日志来源混淆。
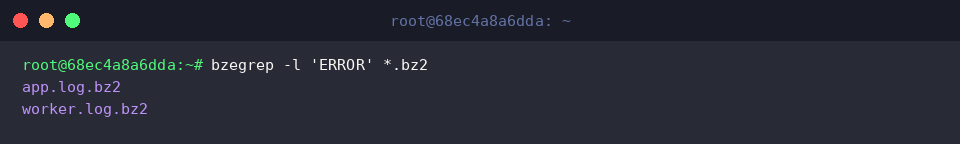
若仅仅需要确认哪些压缩包中潜藏了目标关键字,-l 参数能够隐藏日志正文,仅打印命中的文件名列表。
包含 ERROR 的包名会被逐行呈现,输出简练直观。
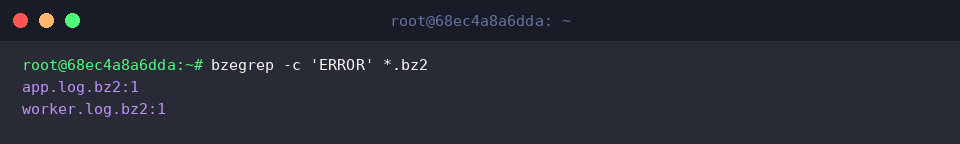
如果希望统计各归档内部匹配特征出现的频次,使用 -c 选项可针对每个文件单独输出计数。
各个压缩包内匹配到的错误行总数将以清晰的数字格式汇总反馈。
通过上述实例可以看出,bzegrep 完美结合了 bzip2 流式解压机制与 grep 的文本处理威力。掌握这些参数搭配,在面对 GB 甚至 TB 级别的海量压缩日志排查时,便能大幅降低临时存储压力并显著缩短运维定位周期。