


概述
在处理海量日志或大型文本数据时,运维人员常需按特定规则将其切开分析。相较于仅支持固定行数或字节大小的经典 split 工具,csplit(Context Split)提供了更加灵活的内容感知能力,允许用户依托指定行号或正则表达式模式执行精细化分块。本文结合实际操作场景,深入解析该命令在日常生产环境中的核心用法与关键参数配置。
按行号边界切分文本基础实战
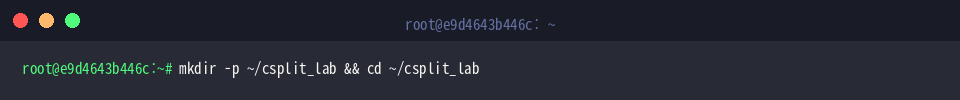
首先准备独立的实验环境,执行 mkdir -p ~/csplit_lab && cd ~/csplit_lab 命令完成实验目录的创建并切换至该路径。
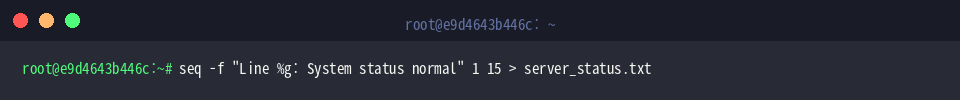
随后生成包含 15 行系统模拟状态记录的基础样例文件,通过运行 seq -f "Line %g: System status normal" 1 15 > server_status.txt 将数据写入磁盘。
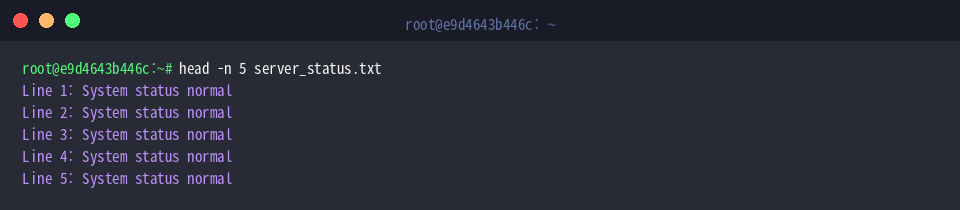
为了确认测试数据结构,调用 head -n 5 server_status.txt 快速抽样预览文件开头的 5 行记录。
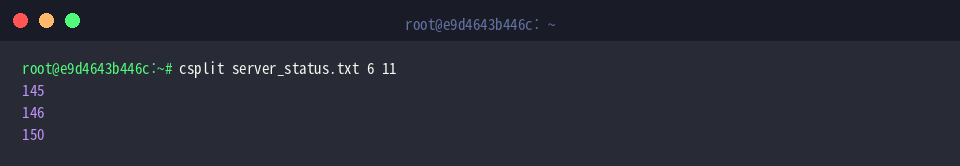
csplit 的核心机制在于根据给定的分界线对目标文本进行切片。例如执行 csplit server_status.txt 6 11 时,命令将分别在第 6 行与第 11 行处设立截断边界,从而将整份文件精准切分为三个独立子集:1 至 5 行、6 至 10 行以及 11 至 15 行。终端打印的一组整数为各生成文件的字节数(Byte)。
⚙️ [核心参数速查]
-f PREFIX : 自定义拆分文件名前缀,替换系统默认使用的 xx。-b FORMAT : 指定文件编号后缀的格式化规则(遵循 printf 语法规范)。-n DIGITS : 设置文件后缀计数器的数字位宽(默认保持 2 位)。-s : 开启静默运行模式,隐藏输出文件字节大小的回显。-z : 自动剔除并抑制生成大小为 0 字节的空文件。-k : 容错保障选项,若处理途中发生错误仍保留前期已生成的有效切片。
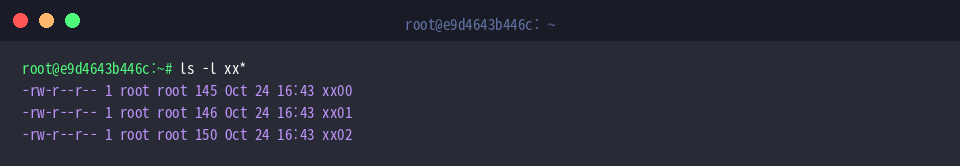
切分完成后,运行 ls -l xx* 检索当前目录下所有新生成的子文件。可以看到系统按照预设规则生成了带有默认 xx 前缀的 xx00、xx01 和 xx02,且各自的大小分布与分段行数完全吻合。
基于正则表达式自动按区块切分文件
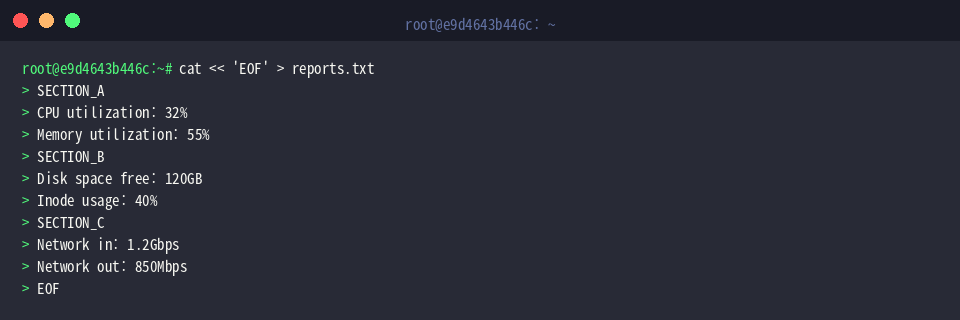
在结构化日志或报表分析中,通常需要依据特定的分段标识符完成切片。通过以下命令利用 Heredoc 语法生成一份包含多个监控维度的状态报表文件:cat << 'EOF' > reports.txt。
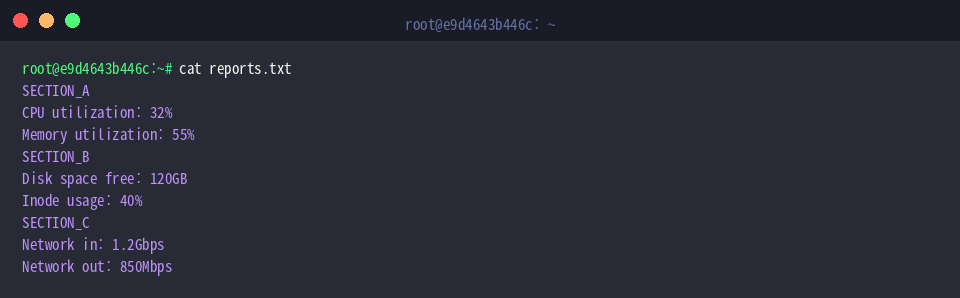
执行 cat reports.txt 查看刚刚写入的完整内容,验证 SECTION_A、SECTION_B、SECTION_C 三个监控区块是否排布正确。
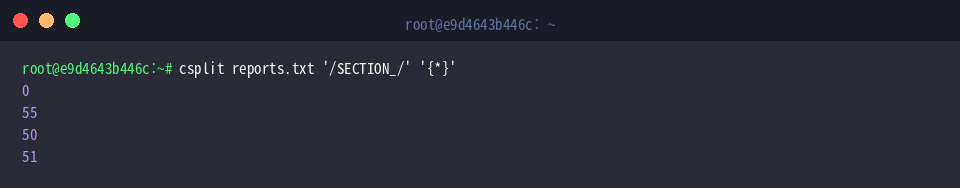
使用命令 csplit reports.txt '/SECTION_/' '{*}' 启动基于模式匹配的内容分块处理。其中 /SECTION_/ 定义了用于定界的正则模式,而附加的 { * } 计数修饰符则要求系统持续遍历至文件末尾,在每次捕获匹配项时均触发分割。终端返回的数值直观反映了各个切片的大小,同时第一项包含了首个模式出现前所对应的 0 字节初始片段。
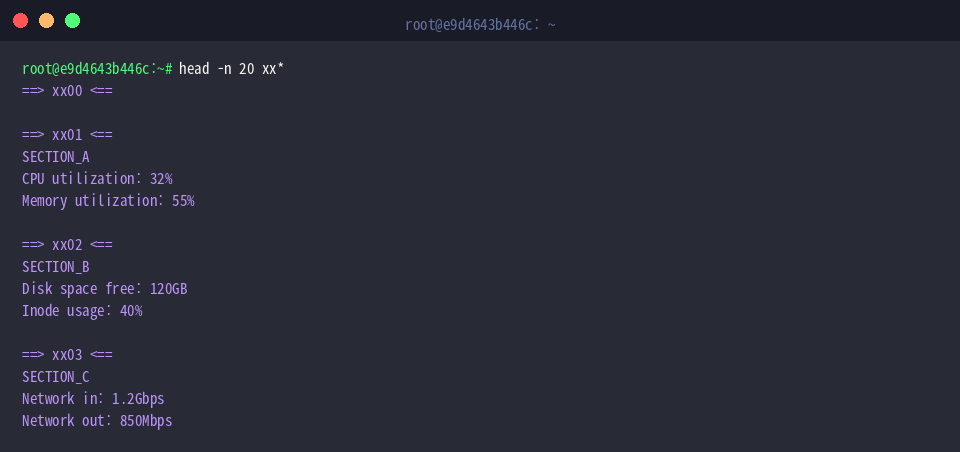
通过 head -n 20 xx* 批量核查各个生成分卷的具体内容。从检视结果可见,除了模式前置生成的零长度占位文件 xx00 外,三个监控段落被完整且有序地封存在 xx01、xx02 以及 xx03 之中。
自定义输出文件名前缀与数字编号格式
默认的 xx 前缀和两位索引在复杂作业流中极易混淆,可以通过专属参数进行定制。首先运行 cat << 'EOF' > app.log 构筑一份模拟的应用异常排查日志。
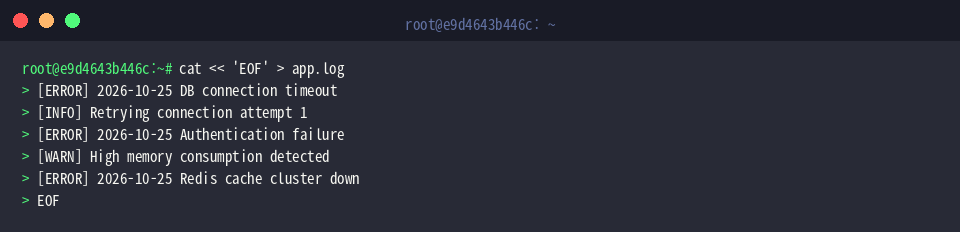
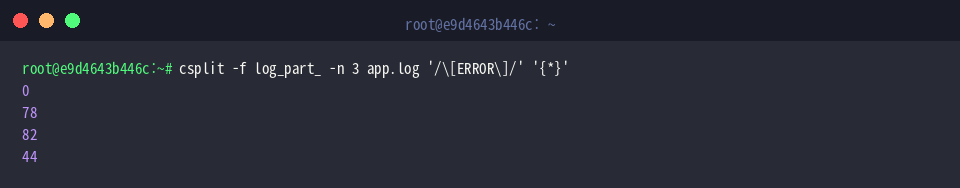
随后运行 csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}'。此处借助 -f log_part_ 显式指定更具辨识度的新文件名前缀,并搭配 -n 3 将递增序号统一扩充为三位数字格式,切分锚点则对齐每条带有 [ERROR] 的异常行。屏幕输出对应呈现了各片段的字节容量。
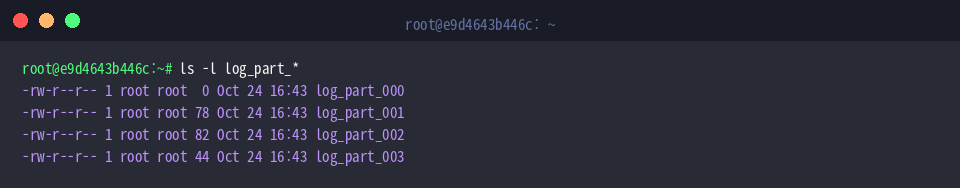
执行 ls -l log_part_* 检验文件命名是否生效。结果表明,从 log_part_000 到 log_part_003 均精准继承了设定的前缀属性及 3 位零填充命名规则。
生产级实用参数:保留异常文件(-k)与过滤空文件(-z)
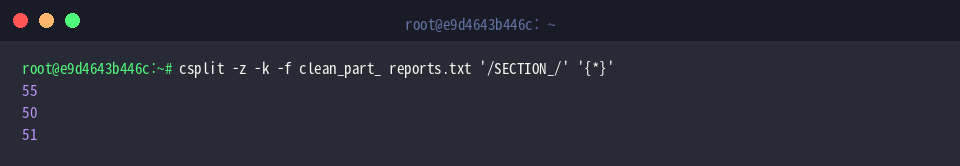
在自动化运维脚本中,因文件首行命中匹配模式而伴生 0 字节冗余文件,以及意外中断导致前序产物丢失都是常见痛点。为此可组合使用清理与容灾选项,执行命令:csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}'。-z 确保直接过滤掉大小为 0 的空白切片,而 -k 则保障即使解析中断也不会将已切出的片段误删。屏幕此时仅展示了三个具备实际有效载荷的文件容量(分别为 55、50 和 51 字节)。
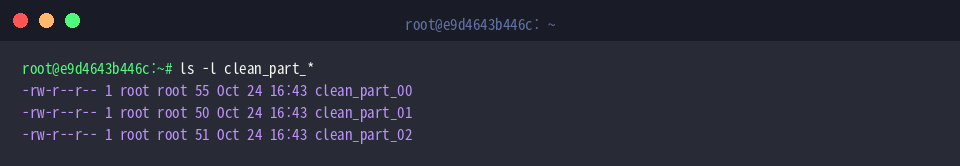
通过 ls -l clean_part_* 列出产物目录。得益于 -z 过滤特性的介入,排除了无意义的空索引文件,整洁生成了从 clean_part_00 至 clean_part_02 的 3 份纯有效数据块。
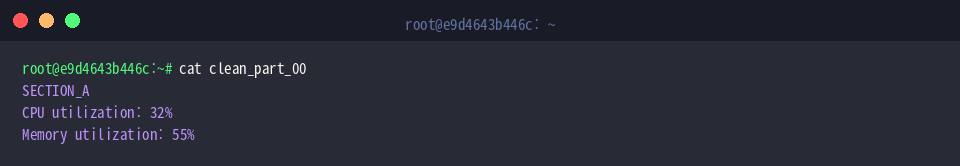
查看首个分卷内容以验证数据完整度:执行 cat clean_part_00。由于无用空段已被剥离,clean_part_00 严丝合缝地自 SECTION_A 的第一行起步,上下文数据无任何丢失或移位。
完成所有演练操作后,运行 rm -rf ~/csplit_lab 清除本次实验所搭建的临时目录及生成文档。
综上所述,csplit 是 Linux 环境下进行复杂文本解构与精准分段的利器。当常规的行数截取或体积切割无法满足业务诉求时,合理结合正则表达式、空文件过滤及前缀定制等选项,能让日志审计与大型文本的预处理流水线变得格外优雅高效。